忆时塔(chronomem)
中文 | English
分层时间记忆的 MCP 服务:替你的工具保存时序记忆(经历/事件),需要时按时间精确回想(零 LLM),或让 LLM 把一段日子压成语义摘要。
塔 = 分层:记忆按时间堆叠,一层一个粒度,越久越粗、越久越高,需要细节时沿引用链下钻。 技术设计见
docs/design.md。
特性
- 自定义记忆类型——每种记忆一条独立 series(
worklog、proj/decisions…),任意 JSON + tags,互不干扰 - 两档回想,成本不同:
- 精确下钻(
mem/recall mode=exact/mem/query)→ 原始条目,语义保真,零 LLM - 语义回顾(
mode=summary)→ 时段摘要,有 LLM 成本,前提是该时段已总结过
- 精确下钻(
- 按类型的粒度链——
10min → 30min → 1h → day → week每类型可自定义;day/week 按本地日历对齐,不是 epoch - 检索:时间范围 / tag 多条件(AND + IN)/ 关键词内容搜索,分页返回
- 语义总结:窗口 → LLM 结构化摘要(决策/结论/待办/状态变更/关键词)→ 落库,可递归再总结
- 后台自动:结构物化(零 LLM,幂等)+ 定时自动总结(opt-in 类型)
- 上下文恒定:只「存 + 查」,永不主动把内容塞回客户端上下文
- 仅 streamable HTTP,多客户端共享同一记忆库;内嵌 Web 控制台与 MCP 同端口
示例
工作日志(开箱即用)
worklog 类型启动时自动创建(levels: [day, week] + 自动总结),无需建类型。
# 干活时随手记
mem/append { type: "worklog", payload: { "task": "拆分忆时塔设计", "status": "完成" }, tags: { "proj": "chronomem" } }

# 任务阶段收尾 → 按阶段总结(不规则窗口,后台异步,立即返回 job_id)
mem/summarize { type: "worklog", from: <开始>, to: <结束>, instructions: "提炼决策与待办" }

# 回想
mem/query  { type: "worklog", tag: "proj=chronomem" }         # 按项目(走索引,快)
mem/query  { type: "worklog", keyword: "nftables" }           # 按内容(无索引,见下)
mem/recall { type: "worklog", granularity: "day", mode: "summary" }  # 当天的语义摘要
让 dsh 自动记录会话(dsh-mem-bridge)
dsh 用户可装本仓自带的宿主插件,自动把会话活动写进忆时塔——
不用手写 mem/append,聊完就能回想「上周那个问题怎么解的」。
dsh plugin --profile web add dsh-mem-bridge # 装完重启该 profile 的 dsh
它默认记会话生命周期、轮次、上下文压缩、目标状态机、子代理里程碑与错误(写入 dsh/activity)。
若把某个工作区配进全上下文模式,还会逐条记下真人输入、assistant 回复与工具调用
(写入独立的 dsh/chat 类型,工具调用可按 none/names/full 控制记录粒度)——
# 配置示例(Web 界面「插件」面板,或 profile 配置)
fullContextWorkspaces:
  - path: ~/notes      # 聊天/写作类工作区
    level: names       # 工具只记名字;不想记工具就用 none
默认关闭:不配置任何工作区时行为与不装插件前完全一致,内容不会入塔。 细节见
dsh-mem-bridge/README.md。
安装
Docker(推荐)
docker run -d --name chronomem -p 8900:8900 \
  -e CHRONOLOG_ADDR=0.0.0.0 \
  -v ~/chronolog:/home/app/.chronolog \
  ghcr.io/ystyle/chronomem:latest
⚠️ 数据目录先建好并 chown 1000:1000(容器内
app用户),否则 Docker 会建成 root,服务写不进去:mkdir -p ~/chronolog && sudo chown -R 1000:1000 ~/chronolog⚠️ 容器内必须
CHRONOLOG_ADDR=0.0.0.0——端口映射是从容器外部 IP 进来的,绑127.0.0.1连不上。
二进制
Linux / macOS 装到 ~/.local/bin:
VERSION=v0.1.2
curl -fsSL "https://github.com/ystyle/chronomem/releases/download/${VERSION}/chronomem_${VERSION}_linux_amd64.tar.gz" \
  | tar -xz -C /tmp && install -m 755 /tmp/chronomem ~/.local/bin/chronomem

chronomem              # 起服务(Web 控制台 + MCP 同端口;不从参数读配置,全用环境变量)
Windows 下载 zip 解压即得 chronomem.exe:
$VERSION = "v0.1.2"
Invoke-WebRequest "https://github.com/ystyle/chronomem/releases/download/$VERSION/chronomem_${VERSION}_windows_amd64.zip" -OutFile chronomem.zip
Expand-Archive chronomem.zip -DestinationPath .
.\chronomem.exe
单文件即可运行:Web 控制台的样式在编译期已嵌入二进制,不需要额外的
public/目录。 Linux 需liburing(apt install liburing2/pacman -S liburing),其余依赖已静态链接; macOS / Windows 无此依赖(io_uring 是 Linux 专有,非 Linux 平台自动走同步写路径)。
源码
需要仓颉工具链(cjpm,版本见 cjpm.toml 的 cjc-version):
eval "$(cjvs env bash)" && eval "$(cjvs stdx-env bash)"
cjpm build -j 16
CHRONOLOG_DIR=~/.chronolog ./target/release/bin/chronomem.cli
环境变量
服务
| 变量 | 默认 | 说明 |
|---|---|---|
CHRONOLOG_DIR |
~/.chronolog |
存储根目录(tsdb 时序库 + 类型注册表) |
CHRONOLOG_ADDR |
127.0.0.1 |
绑定地址;容器内必须 0.0.0.0 |
CHRONOLOG_PORT |
8900 |
监听端口(UI 与 MCP 共用) |
CHRONOLOG_TIMEZONE |
本地时区 | 自然窗口时区(Asia/Shanghai);决定 day/week 边界 |
CHRONOLOG_UI_ENABLED |
true |
置 false 则只跑 MCP,不挂 Web 控制台 |
CHRONOLOG_SEED_WORKLOG |
true |
启动自动创建默认 worklog 类型 |
后台任务
| 变量 | 默认 | 说明 |
|---|---|---|
CHRONOLOG_MATERIALIZE_CRON |
@every 1m |
结构物化(零 LLM,幂等) |
CHRONOLOG_SUMMARY_CRON |
*/10 * * * * |
自动语义总结检查 |
CHRONOLOG_SUMMARY_MAX_PER_RUN |
5 |
每轮最多总结几个窗口 |
CHRONOLOG_SUMMARY_SETTLE |
600000 |
窗口闭合后等多久再总结(毫秒,避开迟到的条目) |
LLM(仅语义总结需要)
不配也能用:存 / 查 / 精确回想全部正常,只有 mem/summarize 会返回「未配置 LLM」。
| 变量 | 默认 | 说明 |
|---|---|---|
LLM_BASE_URL |
— | OpenAI 兼容端点 |
LLM_API_KEY |
— | API Key |
LLM_MODEL |
— | 模型名 |
LLM_PROVIDER |
openai |
openai / anthropic / ollama |
CHRONOLOG_SUMMARY_CONTEXT_TOKENS |
32768 |
端点给该模型分配的上下文。客户端据此算输入预算:一次装得下就直连,装不下按条目切块 + 聚合。换模型必须同步改,否则撞 exceeds the available context size |
CHRONOLOG_SUMMARY_MAX_TOKENS |
4096 |
单次总结输出上限 |
CHRONOLOG_SUMMARY_CALL_TOKENS |
40000 |
单次调用输入上限。上下文大 ≠ 一次能做那么大:实测 4b prefill ~317 tok/s,68K token 的块会撞 300s 读超时 |
CHRONOLOG_SUMMARY_NO_THINK |
true |
透传 enable_thinking=false 关掉推理思考。仅对 vLLM / llama.cpp / SGLang 有效;云端严格 OpenAI API 请置 false |
CHRONOLOG_SUMMARY_MAX_ATTEMPTS |
3 |
同一窗口连续失败几次后停止重试(防每 10 分钟白烧 token) |
| CHRONOLOG_SUMMARY_SAFETY_TOKENS | 1024 | 输入预算余量(模板 / 行前缀 / 估算误差) |
| CHRONOLOG_SUMMARY_BYTES_PER_TOKEN | 2 | UTF-8 字节/token 的保守估值(实测 3.01,取 2 = 低估容量、提前切块的安全方向) |
| CHRONOLOG_SUMMARY_MAX_CALLS | 8 | 单个总结任务的 LLM 调用上限(切块数 + 1 次聚合) |
| CHRONOLOG_SUMMARY_READ_TIMEOUT | 300 | 单次读超时(秒)。端点确实需要长 prefill 可调大;更推荐调小 CALL_TOKENS(切块更细) |
Web 控制台
服务启动时自动内嵌,页面与 MCP 同进程同端口:UI 占根路径,MCP 挂 /mcp;
页面直接调服务(不经 HTTP),零开销。
浏览器打开 http://127.0.0.1:8900。
| 页面 | 作用 |
|---|---|
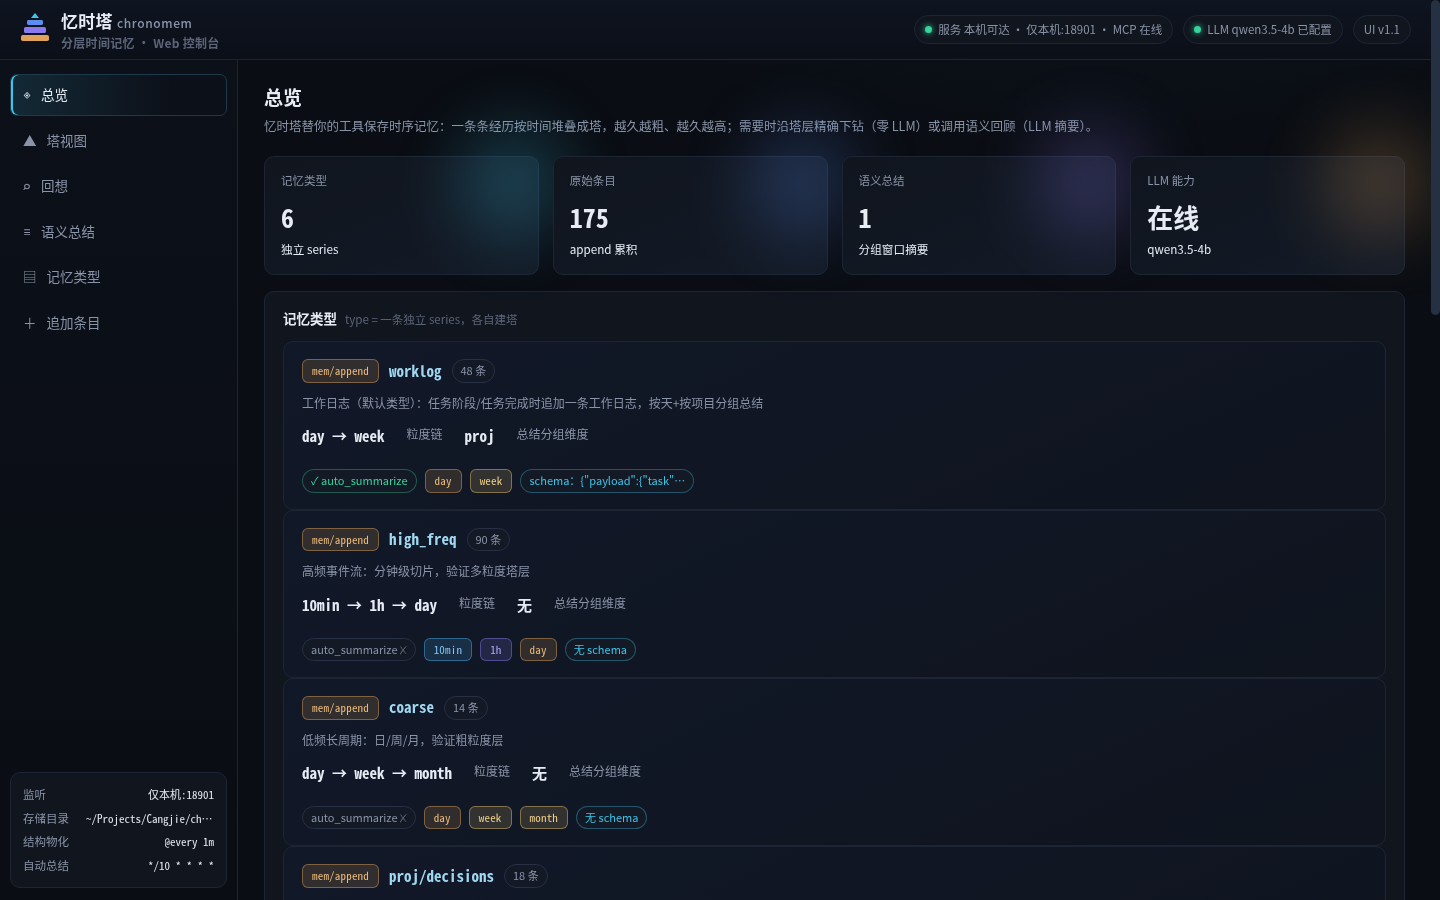
| 总览 | 记忆类型 / 条目 / 总结规模,类型卡片带粒度链与分组维度 |
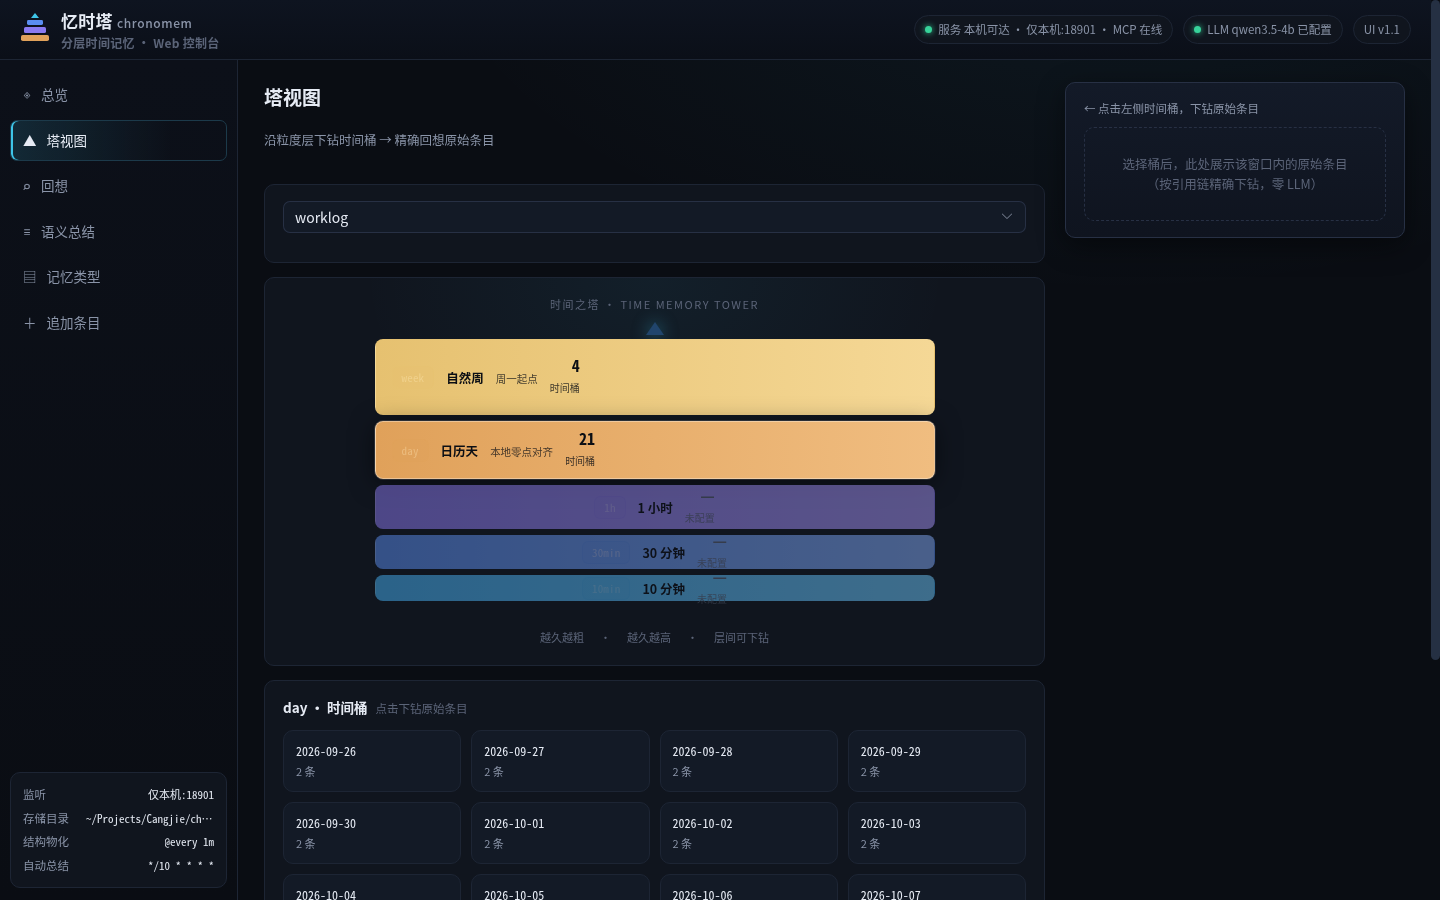
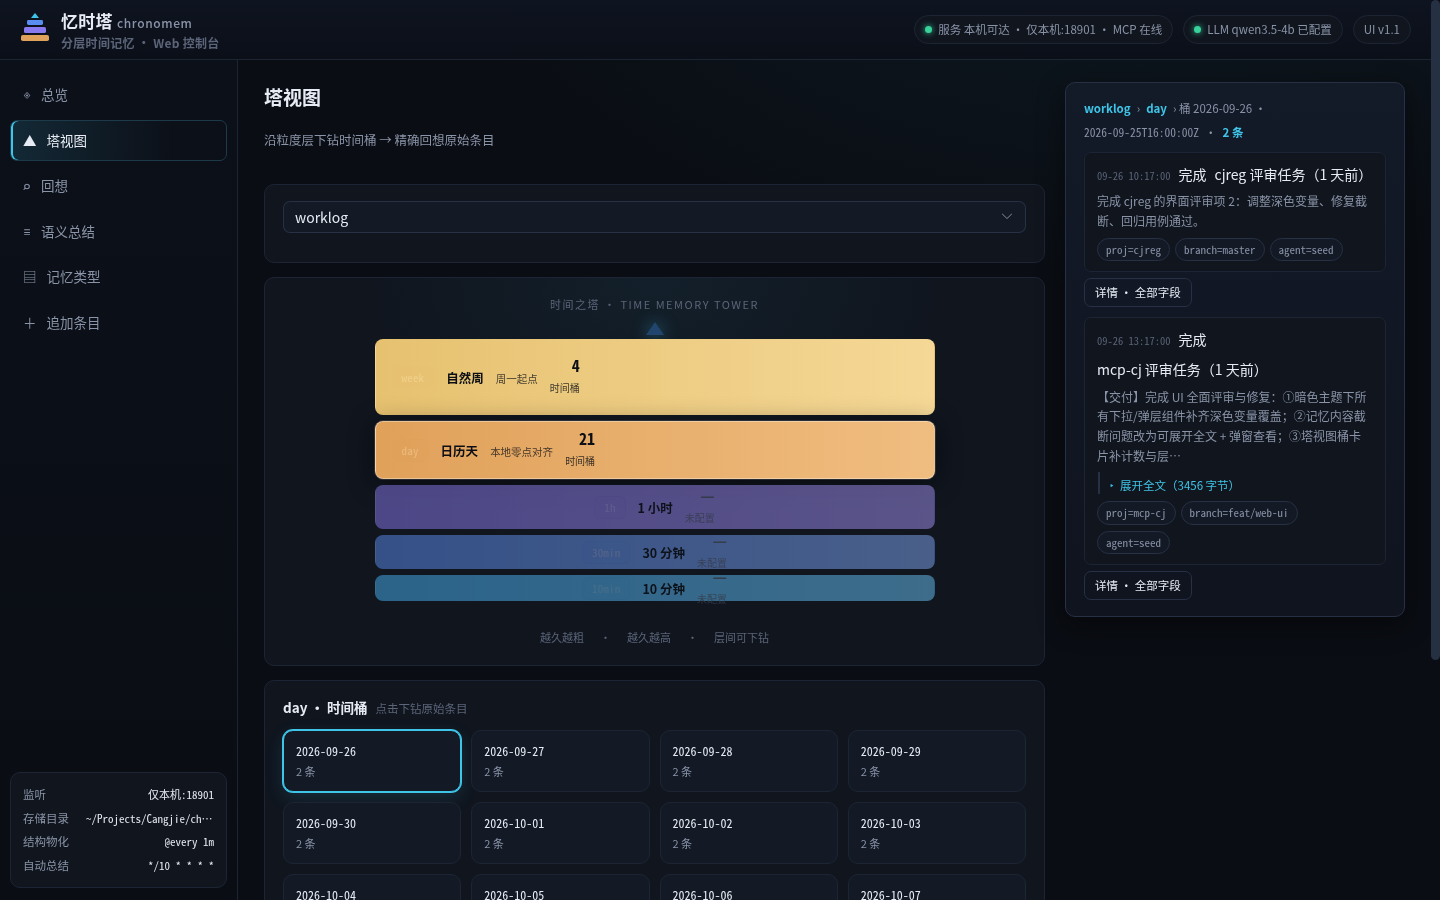
| 塔视图 | 粒度链分层可视化 → 点时间桶 → 下钻原始条目 |
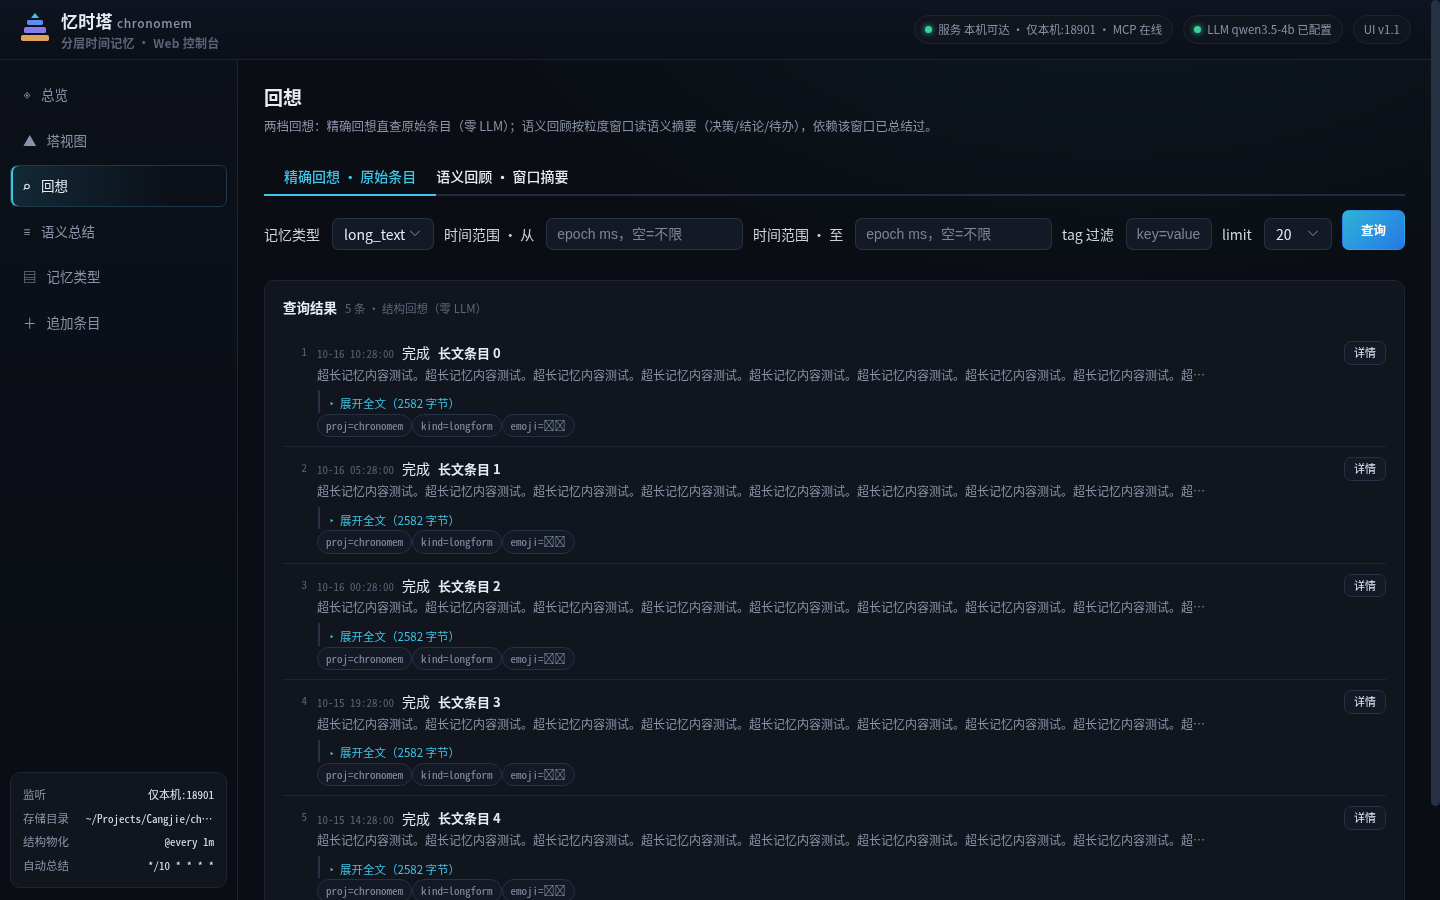
| 回想 | 精确回想(原条目)/ 语义回顾(窗口摘要)双模式 |
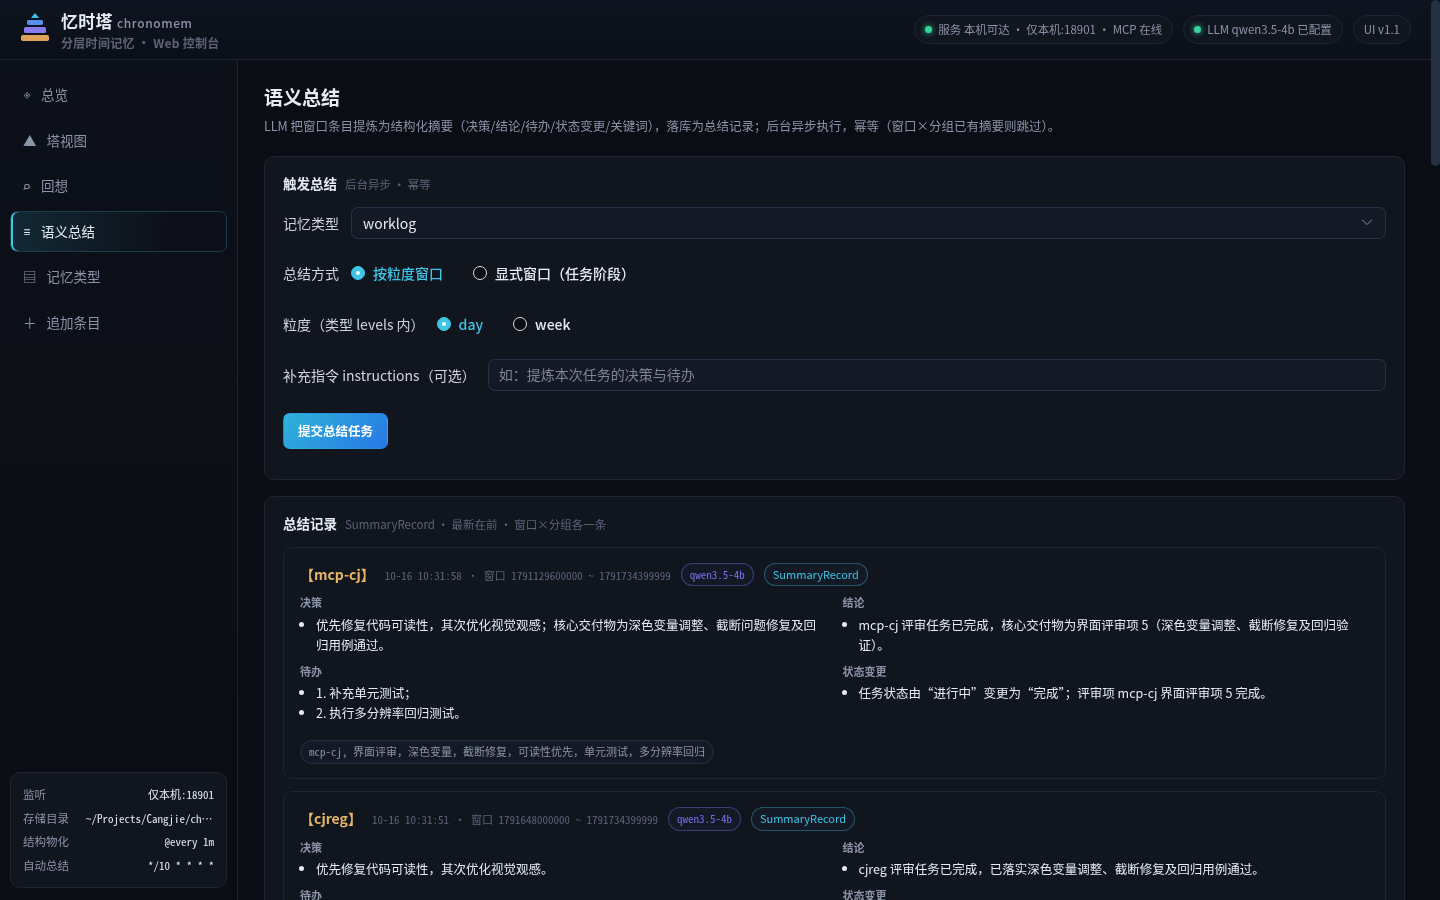
| 语义总结 | 后台任务触发 + SummaryRecord 结构化展示 |
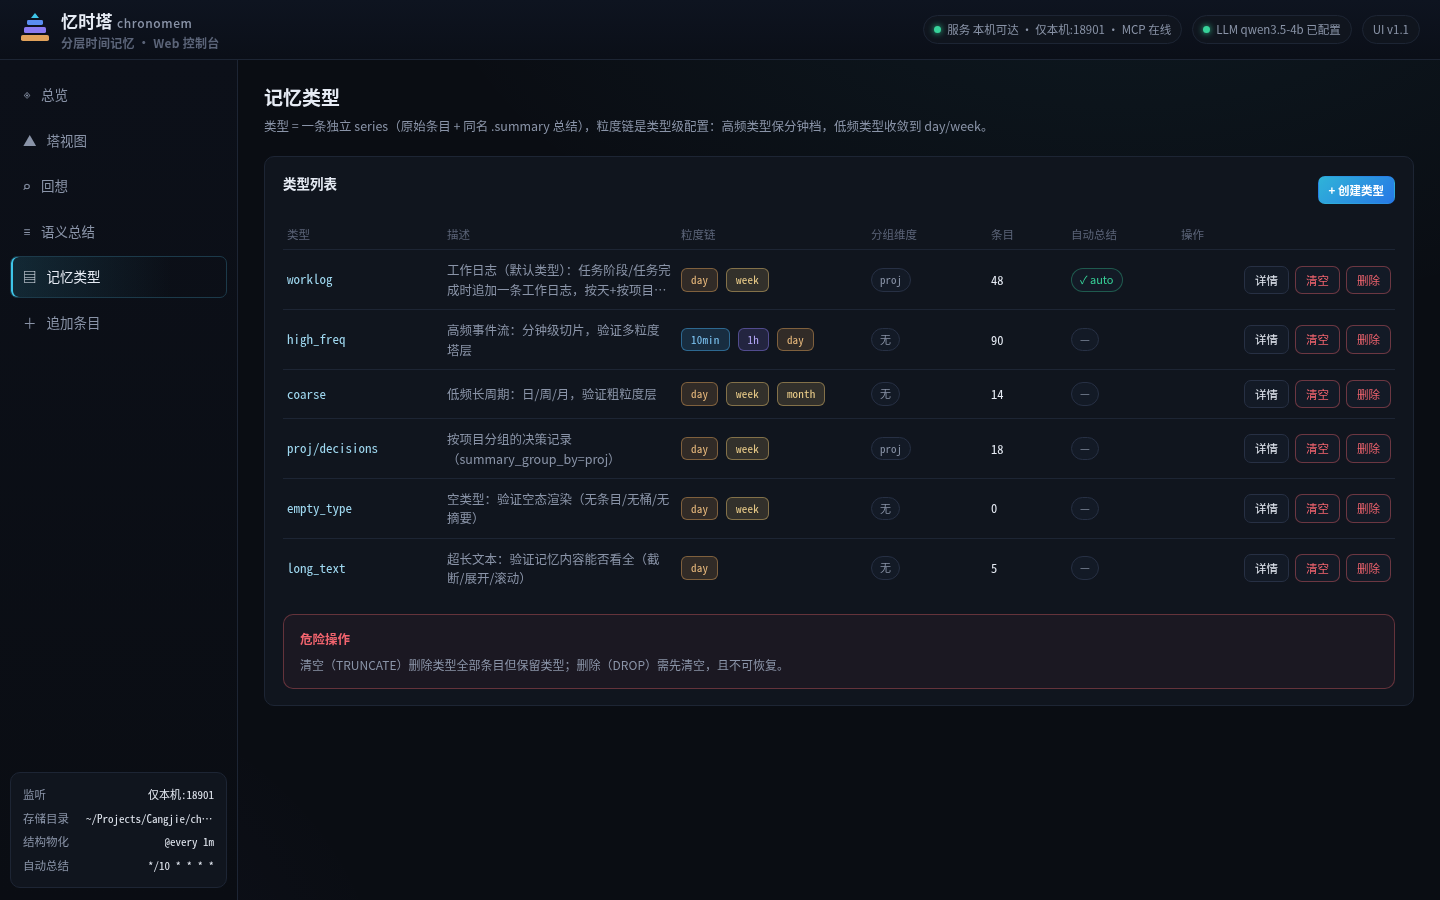
| 记忆类型 | 创建 / 详情 / 清空 / 删除(两步守卫) |
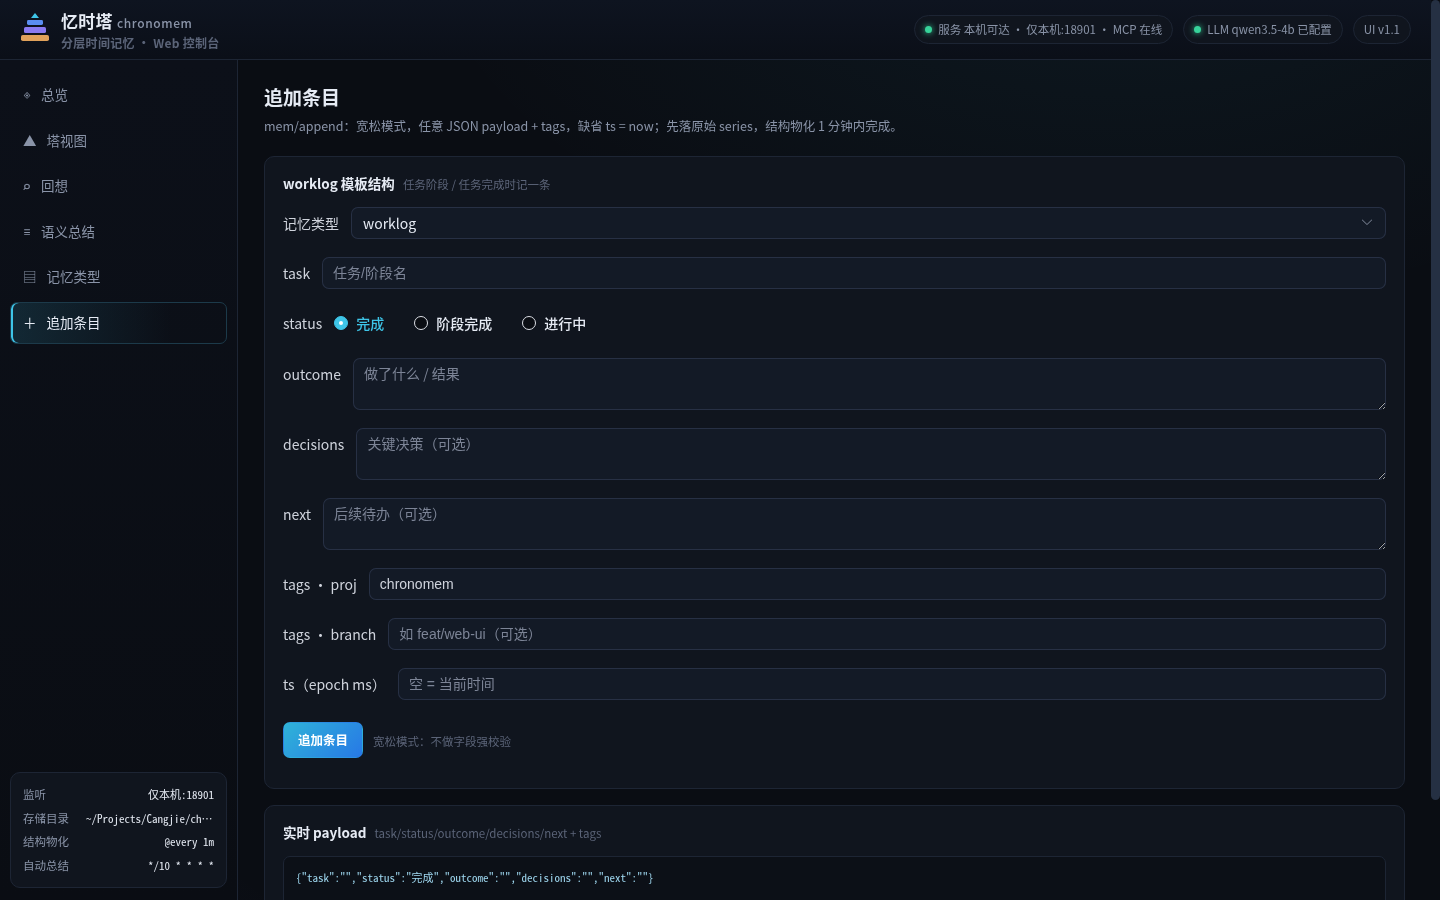
| 追加条目 | worklog 模板 + 实时 JSON 预览 |
总览(测试数据,非真实记忆)——规模与类型卡片:
塔视图——越久越粗、越久越高,点桶即下钻:
回想——精确回想直查原条目,长内容给「展开全文」与「详情·全部字段」出口:
语义总结——按「决策 / 结论 / 待办 / 状态变更 / 关键词」结构化展示:
塔视图下钻到原始条目:
记忆类型(条目数 / 粒度链 / 分组维度 / 自动总结状态):
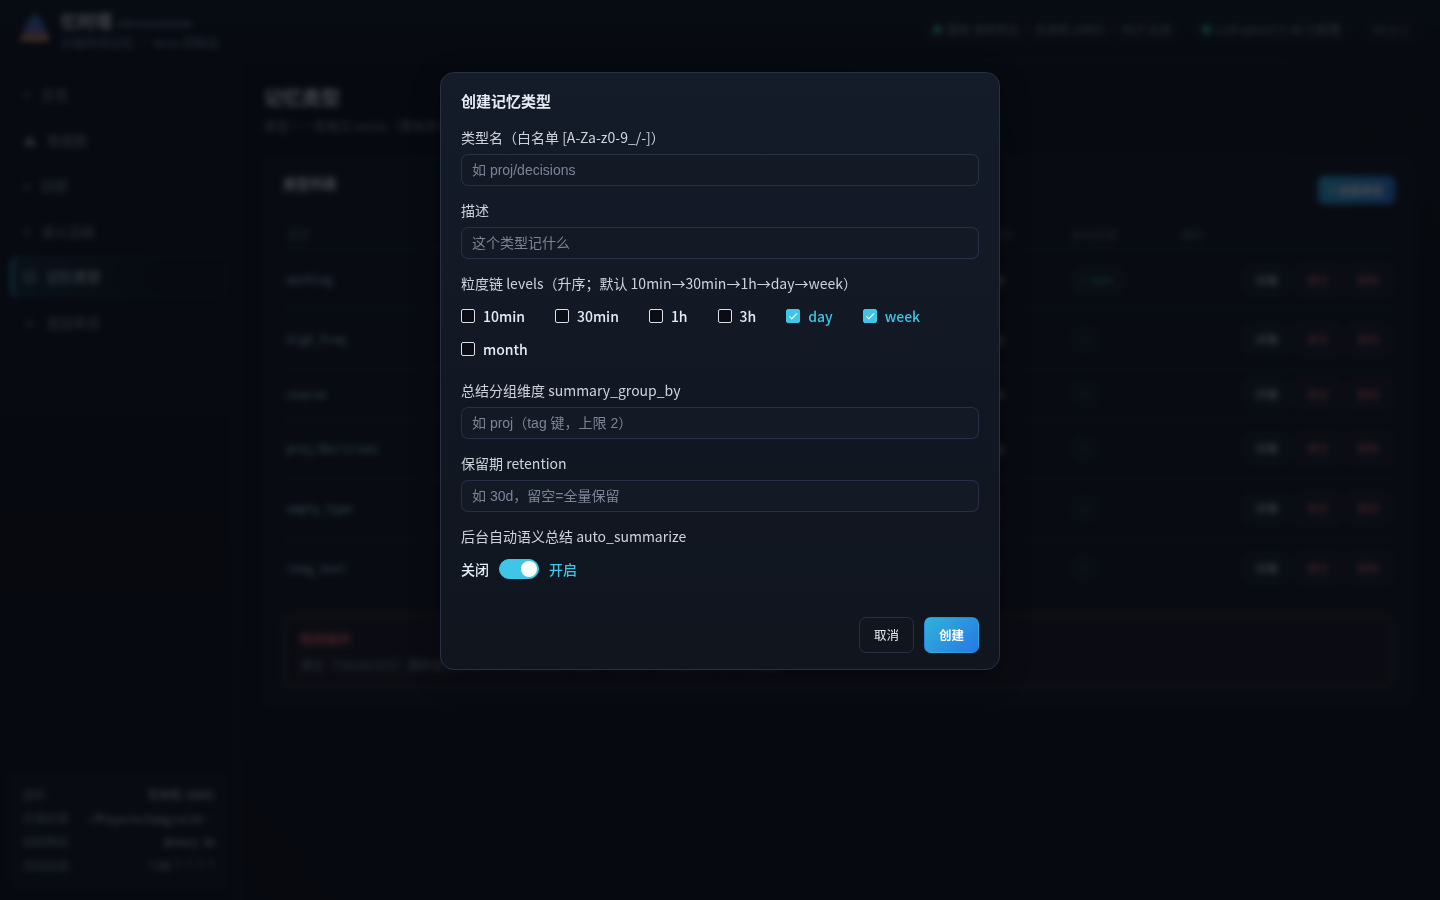
创建类型时可定粒度链(建了不可改)与分组维度:
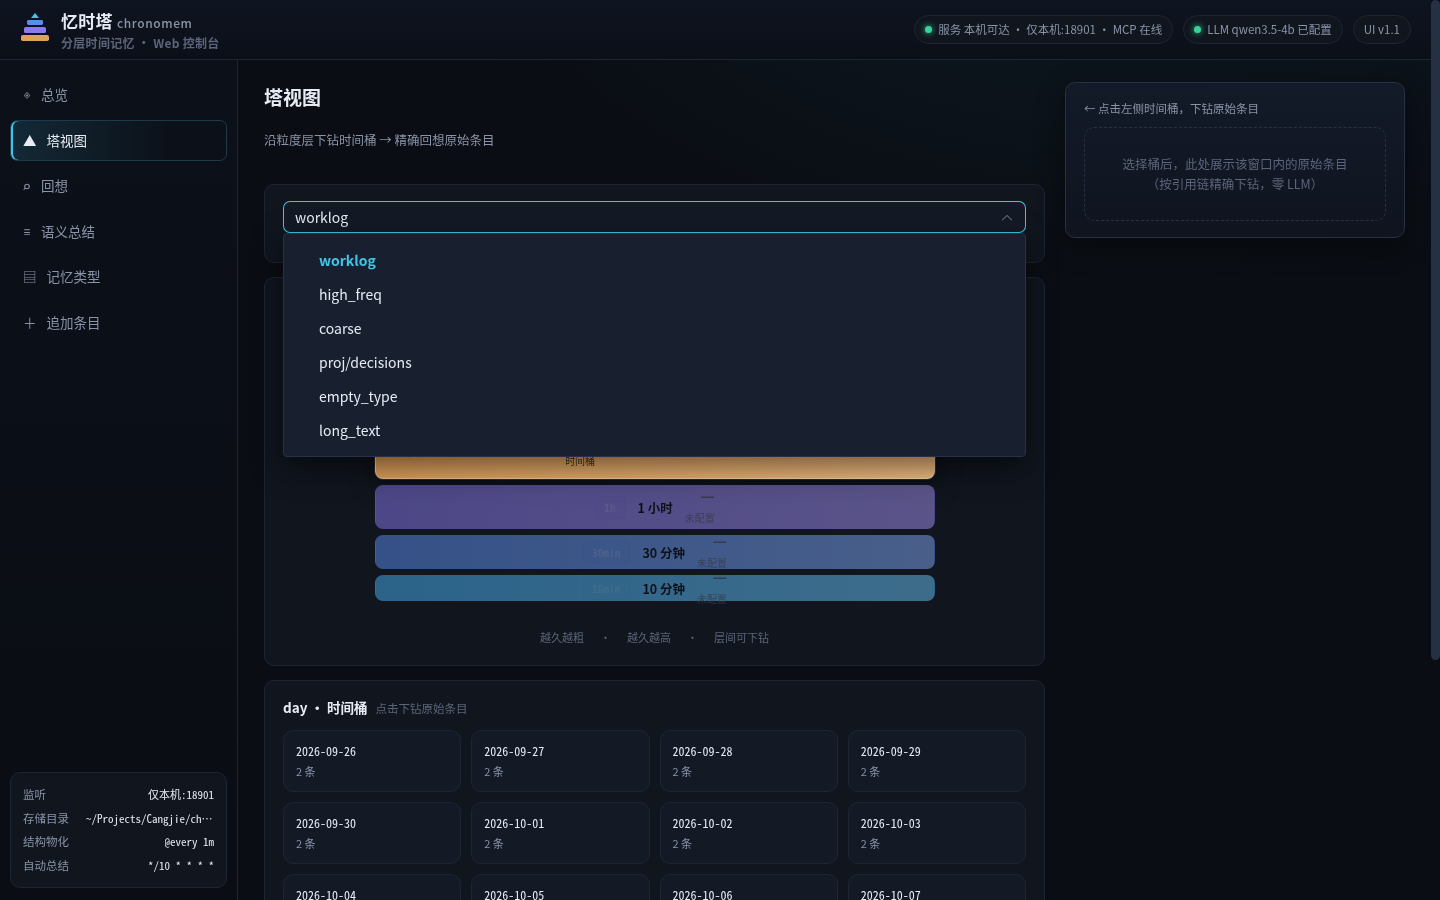
类型下拉在深色主题下的适配(选项完整可读,不被压成单字母):
追加条目——worklog 模板表单 + 实时 payload 预览,宽松模式不做字段强校验:
工具
| 工具 | 作用 |
|---|---|
mem/type_create |
创建记忆类型(name 必填;levels? 粒度链;auto_summarize? 自动总结;retention? 保留期) |
mem/type_update |
改类型配置(省略的字段保持不变;levels 不可改) |
mem/list_types |
类型列表 |
mem/type_info |
单类型详情(meta + 条目数 + 各粒度桶数) |
mem/append |
追加条目(type + payload 必填;tags? ts?) |
mem/query |
结构回想:from? to? limit? page? tag? keyword? |
mem/recall |
mode=exact 下钻原条目 / mode=summary 语义回顾;granularity 须在类型 levels 内 |
mem/buckets |
列某粒度的物化桶(发现可用窗口) |
mem/summarize |
异步总结:立即返回 job_id,LLM 后台跑,不阻塞其它请求 |
mem/summarize_status |
查总结任务状态 |
mem/summaries |
查总结记录(最新在前) |
mem/delete |
删除指定条目:单条给 ts(+seq),批量给 tag/keyword/from/to。默认 dry-run 只预览 |
mem/truncate |
清空类型全部条目(保留类型);须 confirm=<类型名> |
mem/type_delete |
删除类型(守卫:两个 series 都须为空;须 confirm=<类型名>) |
tag 语法
| 写法 | 含义 |
|---|---|
proj=chronomem |
等值 |
proj=chronomem role=user |
空格 = AND |
status=todo,done |
逗号 = 同 tag 多值 IN |
条件间一律 AND,没有 OR 运算符(需要 OR 用同 tag 多值 IN)。 语法错误一律报错——静默降级为「无过滤」会把「查某个项目」变成「查全部」,而调用方毫无察觉。
删除条目
删错了才想删,所以这里的每道护栏都是"少删"优先:
# 1) 先看:默认 dry-run,只回显将删多少条 + 前几条样本
mem/delete { type: "worklog", tag: "proj=test" }
mem/delete { type: "worklog", ts: 1730000000000 }

# 2) 再删:显式 dry_run=false;批量还要带 confirm=<上面看到的条数>
mem/delete { type: "worklog", tag: "proj=test", dry_run: false, confirm: 7 }
mem/delete { type: "worklog", ts: 1730000000000, dry_run: false }
| 护栏 | 作用 |
|---|---|
默认 dry_run=true |
忘了传参数的调用不会删掉任何东西 |
批量必须 confirm=<条数> |
实际命中数与预期不符 → 整批回滚,一条都不删 |
ts 不唯一必须给 seq |
同一毫秒有多条时不替你猜,而是把 seq 列出来让你选 |
| 无条件删被拒 | 想清空就走 mem/truncate,它要 confirm=<类型名> |
为什么条目要 seq:忆时塔的条目身份是 (type, ts, seq),不是单纯的「时间」。
同一毫秒内可以有多条记录(批量导入、并发写都会撞上),此时只给 ts 只能定位到「那一毫秒的全部」。
mem/query 的输出里 seq>0 的条目会带 #n 后缀(seq=0 省略不写,因为绝大多数条目都是 0),
把它原样带上就是精确删那一条。
keyword 内容搜索
keyword 不填 = 不启用,行为与没有这个参数时逐字节一致。
| 写法 | 含义 |
|---|---|
图片 |
单个关键词 |
图片 报错 |
空格 = 多词 AND(都要出现,顺序无关) |
不区分大小写;只做 AND(多词是「缩小范围」而非「任一个算」);匹配 payload 原文、不解析 JSON。
代价:内容条件没有索引,每次扫完候选范围。万级条目内无感,十几万条会到秒级。 缩小
from/to或同时给tag能显著降低扫描量。要做到毫秒级需另建倒排/向量索引。
截止到目前的边界
- 内容搜索无索引(见上);
tag有索引 levels(粒度链)建了不可改——物化桶链不可逆,选类型时要定好- 语义回顾依赖该窗口已总结:day/week 窗口要过零点才闭合,查「今天」「本周」的摘要必然空
- 未配 LLM 时只有
mem/summarize不可用,其余全部正常
论文
| 论文 | 内容 | 评审 |
|---|---|---|
| Chronomem:以 MCP 服务形态提供的时间分层外部记忆 AiraXiv 2610.0035 |
设计定位:两档回想的成本模型、递归总结、按类型粒度链 | 6.6/10 |
| 忆时塔实证评估:召回保持、压缩行为与递归总结的边界 AiraXiv 2610.0045 |
实证:容量断崖、递归保真度、真实语料上什么存活 | 7.9/10 |
两篇均有中英双版(英文为投稿正本),Markdown 源在 docs/paper/。
每条量化主张都能追溯到本仓可重跑的脚本与归档结果(见 bench/results/)。
几条反直觉的结论(也是后续设计要顾着的):
- 有界近因窗口的失效是断崖,不是衰减——窗口内满分、越界归零。加大窗口是移动边界,不是让边界变软
- 压缩的承重件是「条目 → 取值」的对应关系——保留配对的压缩器答对 100%,把取值转述掉的答对 0%,每问只差 11 token。粗层不是细层的廉价版
- 递归总结的保真度取决于输入多样度,而非层级——单天输入时常拒绝压缩(68% 长度比),多天输入才真压缩(0.54x)并丢掉约 40% 数量
- 真实语料上先丢「证据性数字」与因果机制,标识符活得最久——若下游需要数字证据,在提示词里要求总结器逐项保留取值(实测把可答性从 52.4% 找回到 100%,代价约 3.4 倍摘要长度)
依赖
| 依赖 | 用途 |
|---|---|
mcp |
MCP 协议框架(streamable HTTP) |
tsdb |
时序存储(series + 物化桶 + drillDown) |
llm_api |
薄层 LLM REST 库(OpenAI / Anthropic / Ollama) |
cron |
定时调度(物化 + 自动总结) |
cjxt |
服务端驱动 UI(内嵌 Web 控制台) |
jsonvalue |
工具参数 / 动态字段 |
不发布仓颉中心仓:本项目是应用(MCP 服务,入口
chronomem.cli),不是供[dependencies]引用的库。开源 = 源码可见可构建,与发包是两件事。
License
MIT
No comments yet. Be the first to write one.