tabellio-dsh 🧠


English | 简体中文
给 DeepSeek Harness 加一个「记得住、但你说了算」的记忆。
它会在聊天里留意值得留下的约定和偏好,先收进「候选区」;你点一下批准,它才真正记住。之后你问「我们上次怎么定的?」,它会自己想起来。
数据全部存在你电脑上的普通 Markdown 文件里,不上传;联网只发生在本机回环:自动发现本地向量服务(semantic: auto),以及用宿主当前模型做一次「相关/不相关」的小裁决(judge: llm,可关)。
为什么要装它
新开一个对话,Agent 就失忆了:你昨天说过的偏好、定过的流程、纠正过的错误,它一概不记得。
市面上的记忆插件大多两种做法:要么什么都不记,要么把整段对话一股脑塞进记忆里——结果不是没帮上忙,就是把无关内容也召回、干扰回答。
tabellio-dsh 走第三条路:先草稿,后记忆。它只把「看起来值得记」的话写成候选;你批准了才入库。入库的每条记忆都能查到来源,召回有预算、有上限,不会淹没对话。
它和别的记忆插件有什么不一样
- 你批准,它才记。 自动捕获只写「候选」,不动正式记忆。删除、修改也永远在你手里。
- 召回看得见、说得清。 设置里的「记忆」页会告诉你上一轮为什么想起(或没想起)什么,而不是黑箱。
- 纯本地、纯文本。 记忆就是
~/memory/tabellio下的 Markdown 文件,用任何编辑器都能看;换电脑拷走就能用。
安装
需要 DeepSeek Harness 0.2.x。
dsh plugin --profile desktop add tabellio-dsh
装完重启 DSH。打开「设置 → 记忆」,能看到笔记数、候选数和库路径就成功了。
从 0.39.1 及更早升级? 那些版本的安装补丁把召回预算钉在
500 token / 6 条 / 覆盖率 0.33。如果你的~/.dsh/profiles/<name>/cordis.patch.yml里也有这三行(recallBudgetTokens、recallMaxNotes、recallMinCoverage),删掉让它们跟随 0.39.2 的默认(1200 / 8 / 0.2);不删会继续用旧预算,面板上看不出来。
还在开发版?用本地目录安装:
dsh plugin --profile desktop add /path/to/tabellio-dsh。
第一次用,只做三件事
- 正常聊天。 说一句「以后发布前先跑测试」或「我不喜欢太长的回答」。
- 打开「设置 → 记忆」,在候选区点「批准入库」。
- 过几天问它一句:「我们发布前一般先做什么?」——它会自己想起来。
想跳过对话直接写?「设置 → 记忆」里有一个「直接存一条记忆」的输入框,保存即入库。
就这么多。不需要每次说「请记住」,也不需要配置任何东西。
它怎么记住你
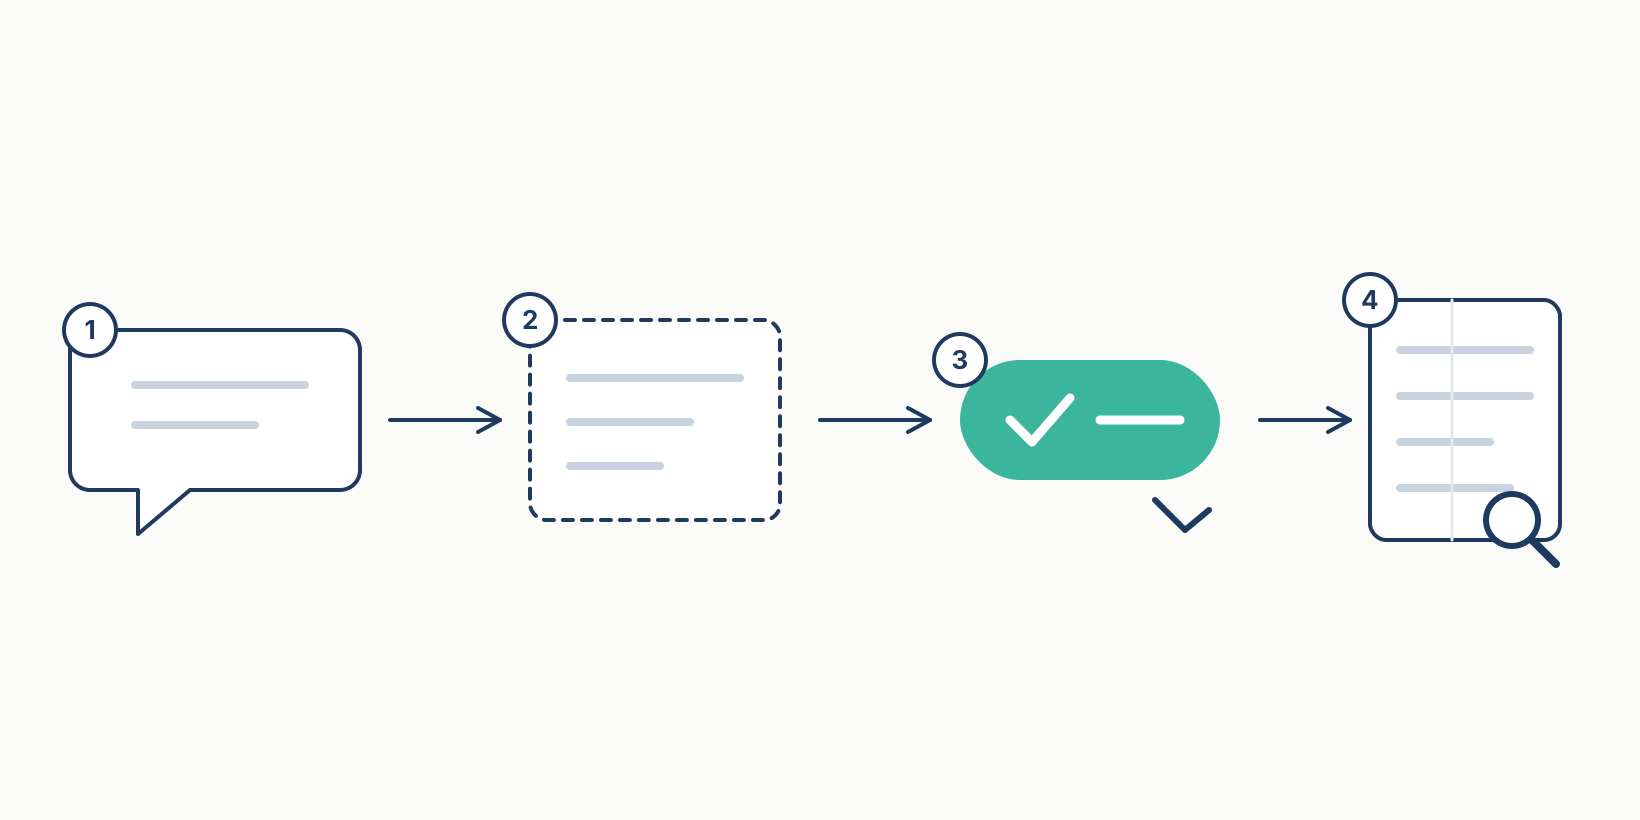
你说的话
   │  ① 留意约定、偏好、纠错(每轮最多 2 条)
   ▼
候选区 notes/candidates/     ← 只在这里,还没进记忆
   │  ② 你在「记忆」页点批准
   ▼
正式记忆 notes/              ← 本地 Markdown,可搜索、可编辑、可删除
   │  ③ 下次聊到相关话题
   ▼
自动想起(有预算、有上限,闲聊不打扰)
几个你可能会关心的点:
- 候选会被提醒一次。 有候选等你批准时,静默上下文里会多一行提示(每 6 小时最多一次),点开设置页「记忆」逐条确认即可。
- 默认只花一次小模型调用。 召回命中时,用你正在用的 DSH 默认模型做一次很小的相关度判断;全部本地语义可用,不向外部发数据。想完全关掉:面板「设置 → 智能记忆」关掉即可。
- 不会把整段对话存下来。 只挑约定、偏好、纠错这类「值得长期记住」的句子。
- 不会把密码写进去。 出现明文密码、token 的句子直接跳过;「凭据统一放 1Password」这种策略句才会保留。
- 不会打扰闲聊。 只有问题像是在问「我们的历史/约定/偏好」时,才会把记忆带进上下文。
常见问题
Q:装完为什么一条记忆都没有? 它只在出现值得记的话时才产生候选;新库本来就是空的。聊几天就有了。
Q:为什么候选一直不消失? 候选需要你批准(或忽略)才会离开候选区。Agent 不会替你批准——这是故意的。
Q:记忆存在哪里?能备份吗?
~/memory/tabellio。整个目录拷走就是备份;删掉索引也能从 Markdown 重建。
Q:能关掉自动捕获吗?
能。设置里把 capture 改成 off,或只保留 explicit(必须说出「记住」才记)。
Q:会不会拖慢对话? 召回只在每轮第一条真人消息时做一次,默认 1200 token 预算、最多 8 条(2026-10-22 由 500/6 复测上调:太小等于把第 3 名以后的 gold 直接裁掉);闲聊直接跳过。
Q:支持 Claude Code / Cursor 吗? 核心库和命令行工具支持多个宿主;DSH 插件目前只适配 DSH。其他宿主的适配在路线图上。
几个可选开关
普通用户不用动。想微调的话,在 DSH 的 profile 配置里改这几项就够:
| 开关 | 默认 | 一句话 |
|---|---|---|
autoApprove |
off |
仅在 writeJudge: llm 同时开启时生效:显式且长期的单主题约定可自动入库(T0),其余仍进候选。 |
capture |
assist |
记什么:assist 最省心;explicit 只记「记住…」;off 关闭 |
delivery |
context |
怎么送:context 静默(推荐);notice 在对话里显示一条提示 |
shadow |
false |
只记录召回、不注入,用来对比其他记忆插件 |
judge |
llm |
用模型再筛一遍召回,更准;每轮命中时多一次小调用 |
storePath |
~/memory/tabellio |
记忆放在哪 |
其余高级配置见开发者说明。
上表是插件补丁(
cordis.patch.yml)下发的默认值;配置里不写这些键时,代码内置默认是capture: explicit、delivery: notice。
模型裁决(默认开启)
每轮召回命中时多一次小模型调用:把「问题 + 最多 4 条候选」一起给模型,只留真正回答问题的笔记。默认开启,模型永远跟随宿主当前选中的对话模型(换模型即跟着换,不需要单独配置);想省成本,在面板「设置 → 智能记忆」里关掉。需要固定模型的进阶用户仍可在配置文件写 judgeModel/judgeProvider。裁决失败一律放行,不会因为模型超时丢记忆。
真实模型抽样(本地 Qwen3.6-35B,30 条冻结问句 + 人工 gold):gold 召回 19/20,judge 后保留 18/19(94.7%),保留笔记里 85.7% 是相关项;1 条 gold 被误杀、1 条无关笔记被留下、1 次格式失败按「失败即放行」回退。这是 2026-10-19 的快照,不是长期承诺。
性能(实测,2026-10-20,1411 条笔记)
- 词面召回:p50 约 131ms、p95 约 225ms(本机 M 系列,冷/热进程混合)。
- 叠加本地语义补召回:p50 约 166ms、p95 约 312ms;语义服务离线时自动退回词面,不阻塞。
- 模型裁决只在命中后调用一次,实测 1.0–1.3s(deepseek-flash);把它关掉就只花上面的时间。
- 复测:
TABELLIO_STORE=~/memory/tabellio npm run bench:recall(只读,不写库)。
设置面板(设置 → 记忆)
第一次打开面板会走三步引导(默认开启智能记忆 → 选本机或远程向量服务 → 存第一条记忆试试),也可以「稍后再说」,之后在「设置」页底部点「重新运行引导」再走一遍。
面板按任务分成四个页签,状态不会一次铺满:
- 概览:记忆总量 / 待批准 / 索引状态,加上「上次召回」、最近 7 天汇总(召回次数、注入成本、裁决保留/丢弃、复核、新增记忆)、最近召回记录(为什么召回/为什么没召回,用人话写)、「裁决复核」(模型每次裁决保留/丢弃了哪些记忆,可点「判得对 / 判错了」抽样复核)、「记忆成本」(近 7 天注入字符/估算 tokens/裁决与语义调用次数)与最近新增;
- 待批准:新候选与合并提案,可单条或批量批准/忽略,只有批准后才进 notes/;
- 记忆库:写一条新记忆、搜索并点开全文(正文下方附「来源与使用」:写入来源、信任级别、是否被取代、被召回次数,以及一条时间线——写入、哪几轮被召回、被你纠正/标记、被谁取代)、全部笔记翻页与类型/时间筛选;
- 设置:只有一个「智能记忆」开关(开=自动发现本地向量服务 + 用默认模型过滤误召回;关=纯词面)。服务地址/模型、捕获档位、投递方式、每轮条数、巩固节奏都收在「进阶设置」里,保存即生效;judge 模型与耗时、语义索引大小、库路径、索引警告收在同一页下方。
普通用户不用碰配置文件:面板里只决定一件事——智能记忆开不开(默认开)。开启后自动探测本机常见向量端口(llama-swap / Ollama / LM Studio 等),发现即用;没有任何向量服务时自动退回词面匹配,不会报错。地址、模型、捕获档位、投递方式、每轮条数、巩固节奏,以及「助手结论沉淀」「纠正反馈」两个开关都在「进阶设置」里,保存即生效。这些写在记忆库目录的 panel-settings.json,可随库迁移,也不会动宿主配置。
裁决模型不用配:judge 始终用你当前对话里选中的模型,换模型自动跟着换;只有想长期固定某个模型时才需要改配置文件(judgeModel)。
用远程向量服务? 在「进阶设置」里把服务地址指向任意 OpenAI 风格的 /v1/embeddings,点「获取模型」从服务端拉模型列表(也可以手填),再点「测试连接」确认维度和耗时;远程服务需要填 API Key(写进 panel-settings.json,明文本地文件),更推荐用环境变量 TABELLIO_SEMANTIC_API_KEY,面板里会显示「已设置」而不会回显 Key。
留在配置里的只有进阶项:recallMinRelevance/recallMinScore/recallMinCoverage(召回阈值)、recallBudgetTokens、storePath、shadow、refreshSeconds。这些改错会直接影响召回质量或落库位置,所以没有放进面板;默认值已经适配普通用户。
纠正会被记住(结果反馈)
记忆注入之后的下一轮,如果你说「不对,应该是白鹭」这类纠正,而这句话又和刚注入的笔记
有实际词面重叠(至少 2 个共同词元),插件会往 outcome.jsonl 记一条局部信号:哪几条笔记被
纠正、当时问的什么。之后这些笔记只在同一查询的排序里小幅降权(每条最多降 24%),不删除、
不改写、不越过相关性闸门;超过 10 分钟或不相关的「不对」不会被算到记忆头上。
关掉:outcomeFeedback: false。
归因在 36 条合成对抗样本上实测:precision 0.923、recall 1.0(1 条误归因是「同一主题、不同方面」;见 node tools/outcome-eval.mjs)。这是合成集,真实会话的准确率还要再量。
隐私
- 全部本地读写;网络只到
127.0.0.1(本地向量服务),以及宿主默认模型的一次裁决调用(可关)。 - 不收集任何遥测。
- 明文 Markdown,建议放在你自己的加密磁盘里。
给开发者
点开:架构、工具面、配置全表、测试与评测架构
- 核心
tabellio:存储、索引、BM25 + 共现打分、写入闸门、回执、巩固。这个插件只做 DSH 适配,不复制核心逻辑。 - 适配层
tabellio-dsh:agent/pre-step召回、agent/turn-stopping捕获、7 个原生工具、设置面板(HTTP RPC,loopback + Origin 校验;概览/待批准/记忆库/设置四个页签)。 - 换宿主时核心不动,只换适配层;库目录、写入闸门、召回口径三个入口共用,走查见 docs/CROSS-HOST.md。
工具
tabellio_recall / tabellio_search / tabellio_read / tabellio_status / tabellio_capture / tabellio_inbox / tabellio_report(周报)/ tabellio_conflicts(只读:列出可能过时的笔记对)/ tabellio_merge(人批准后合并新旧说法,旧笔记标记被取代)/ tabellio_feedback(记录「这条有用 / 不对」,只调整后续排序,不改笔记)/ tabellio_forget(人确认后归档一条笔记,自动召回不再使用;文件保留可审计)/ tabellio_edit(人要求修改时写入新版本并标记旧版本被取代,自动召回切到新版本)。tabellio_recall 与 tabellio_search 支持 as_of 按某个时间点查询。工具与 CLI、MCP 共用同一套预算、拒答和写入闸门。
配置全表
| 字段 | 默认 | 说明 |
|---|---|---|
enabled |
true |
关闭后不注册工具、不挂事件 |
storePath |
~/memory/tabellio |
与 CLI/MCP 同一个库,支持 ~ |
autoRecall |
true |
每轮首个真人消息召回一次 |
shadow |
false |
只写回执不注入,用于 A/B |
delivery |
notice |
notice 可见通知;context 静默上下文 |
recallBudgetTokens |
1200 |
召回预算,100–4000(太小时第 3 名以后的 gold 会被裁掉) |
recallMaxNotes |
8 |
最多几条,1–20 |
injectMaxChars |
1400 |
一轮注入的字符上限(约合 450 token),超出时只保留前几条全文 |
injectFullNotes |
2 |
前几条给全文;后续条目只给标题 + 120 字摘要,全文用 tabellio_read 取 |
injectRepeat |
session |
同一会话里已经注入过的笔记不重复注入;turn 只压住紧挨着的一轮,off 关闭 |
recallIntentGate |
true |
没有记忆意图的问句不注入 |
recallConfidentRelevance |
0.9 |
首条相关度到这条线时,即使没有意图词也放行 |
feedbackRanking |
true |
用「有用 / 不对」反馈给召回结果做小幅重排(不增删笔记;事件存核心的 <store>/runs/feedback.jsonl) |
decayDays |
180 |
遗忘衰减半衰期(天);0 关闭。只压排序,不归档 |
decayFloor |
0.6 |
衰减下限(0–1);user_stated 与 evergreen 笔记不衰减 |
captureAssistant |
false |
每轮结束时把助手给出的结论/决定(含结论、以后、统一等线索)整理成一条候选,仍需你批准;默认关。 |
outcomeFeedback |
true |
注入后下一轮你说「不对/不是…而是」且与被注入笔记有词面重叠时,记一条局部纠正信号,用于小幅降权(10 分钟窗口,不删笔记、不越过闸门) |
recallTrusts |
user_stated、system_derived |
自动召回信任哪些来源;导入的文档(external)默认只参与搜索/面板,不自动注入 |
recallMinCoverage |
0.2 |
覆盖率闸(噪声地板);长问句会被稀释,拒答交给 judge 与答案模型 |
recallMinScore |
0.1 |
最低分 |
recallMinRelevance |
0.12 |
最低相关度 |
includeCore |
true |
是否包含 core 笔记 |
minQueryChars |
4 |
更短消息不召回 |
queryChars |
400 |
超长消息保留头尾 |
refreshSeconds |
30 |
重扫库间隔;0 表示每次事件重扫 |
capture |
explicit |
explicit / implicit / assist / off |
semantic |
auto |
auto / local / off:auto 自动发现本机嵌入服务并补充召回,local 固定用配置地址,off 纯词面 |
semanticEndpoint / semanticModel |
http://127.0.0.1:8080/v1/embeddings / qwen3-embedding-0.6b |
首选地址与模型(auto 失败时会继续探测其他常见端口) |
semanticRefreshMinutes |
5 |
语义索引增量刷新间隔(分钟);0 关闭,只在新笔记写入后的下次重启索引 |
semanticMinSimilarity |
0.55 |
低于这个余弦相似度的语义命中不加进召回 |
consolidate |
off |
后台巩固:daily/weekly 时定时扫近似重复笔记并写合并提案,同时扫一遍「说法冲突」的笔记对并把结果写进 runs/conflict-state.json(只产提案/提示,批准仍在面板) |
maxCandidatesPerTurn |
2 |
每轮候选上限,1–5 |
captureMaxSentenceChars |
240 |
单句上限,40–1000 |
judge |
llm |
llm / off |
judgeProvider / judgeModel |
空 | 留空用宿主默认模型 |
judgeTimeoutMs |
6000 |
裁决硬超时,500–15000,超时回退词面命中 |
judgeDeadlineMs |
1500 |
软截止:到点先注入未裁决的结果,裁决晚到就缓存给下一次;0 = 关闭 |
judgeMinChars |
6 |
短于这个字数的模糊问句不调 judge(省约 2s);0 关闭 |
judgeCacheMinutes |
10 |
同一问题 + 同一批命中在多少分钟内复用裁决结果;0 关闭缓存 |
测试与评测
npm test                      # 74 个单元/集成用例 + npm run check:cross-host
node tests/acceptance.mjs     # 30 条功能验收
node tools/cross-host-demo.mjs  # 跨宿主 API 走查(临时库)
npm run check:cross-host       # 插件 API / CLI / MCP 三方一致性(临时库,失败即非零退出)
python3 tools/blind-eval.py <外部数据集.json>  # 冻结查询的召回盲测(数据集含个人记忆,不入库)
node tools/judge-eval.mjs <带 gold 的查询集.json>  # 真实模型裁判抽样(本地/任意 OpenAI 兼容端点)
发布前四路独立测试报告归档在 ~/yffto/archive/2026-10/scratch/tabellio-dsh-validation/final/。
边界
- 不自动批准候选,不自动合并/衰减/删除笔记。
- 不伪造 DSH 生命周期事件。
- 不上传;只访问本机回环服务(向量、宿主模型)。
相关文档
License
MIT
评测
node tools/memory-eval.mjs(或 npm run eval:memory)会在临时库上跑 12 条固定用例,覆盖五类能力:
| 类别 | 含义 | 当前 |
|---|---|---|
| knowledge_update | 新旧事实并存时,能否取到当前事实 | 2/2 |
| temporal | 依赖日期/时段的回忆 | 2/2 |
| preference | 用户偏好 | 2/2 |
| project | 项目事实 | 2/2 |
| abstention | 问的不是记忆时,应该不注入 | 4/4 |
它衡量的是「对/错」,不是命中率。--strict 会在低于基线时以非零码退出。
No comments yet. Be the first to write one.