文件快速寻回 · dsh-lost-and-found


忘了文件放哪,问一句就能找回来,再也不用翻遍硬盘。
忘了文件放哪,问一句就能找回来,再也不用翻遍硬盘。这款 DSH 插件把你指定的文件夹变成一座随问随答的本地文献库。支持多目录只读扫描,缓存与程序目录整棵跳过,几万个文件十几秒扫完;结果统一登记进本地 SQLite 索引,随时可从零重建。名字、类型、大小、出现时间、位置、来源自动入库,图片内容交给大模型看过之后写回描述。找文件采用两段式:先按时间、类型、目录、来源硬过滤,再按文件名、标签、路径、摘要、图片描述分层加权,多关键词取交,命中的是哪一层直接标给你看。索引里没有的当场实时兜底找一遍,但只现场比对、绝不写库,插件只读,绝不修改、移动或删除你的文件。比每次让大模型硬翻目录更省更可控,比你自己的记忆更靠得住,几万文件规模也照样秒回。
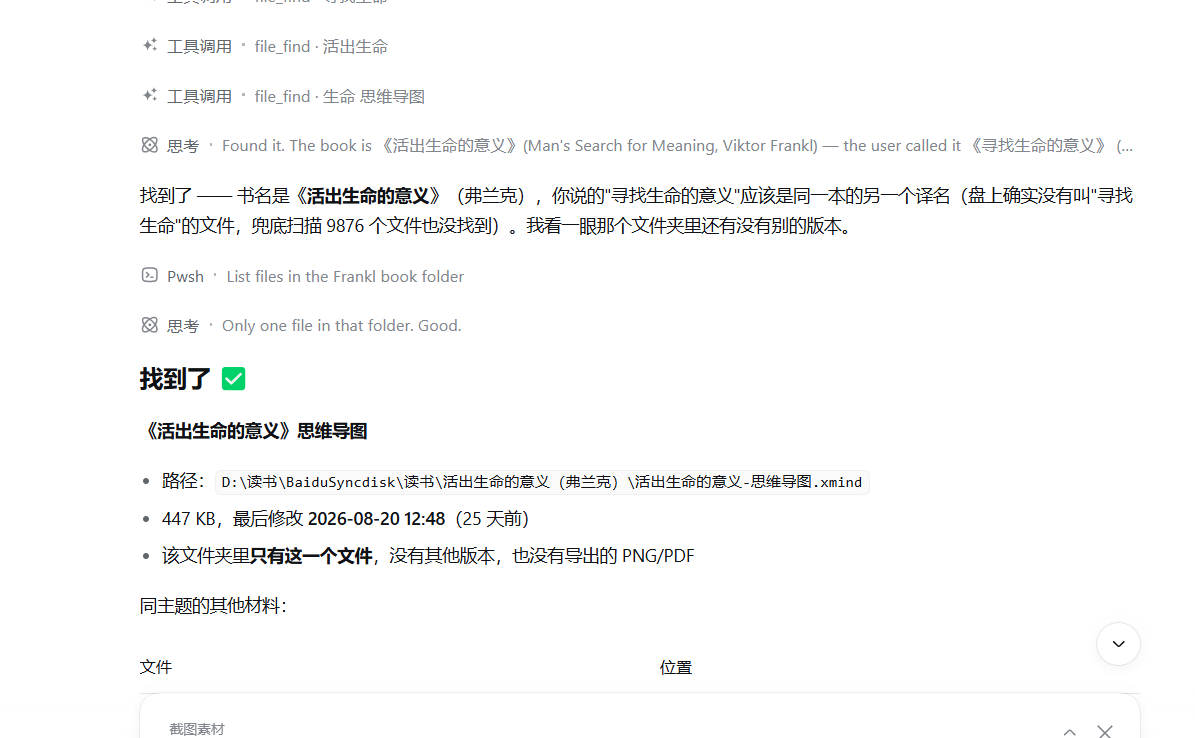
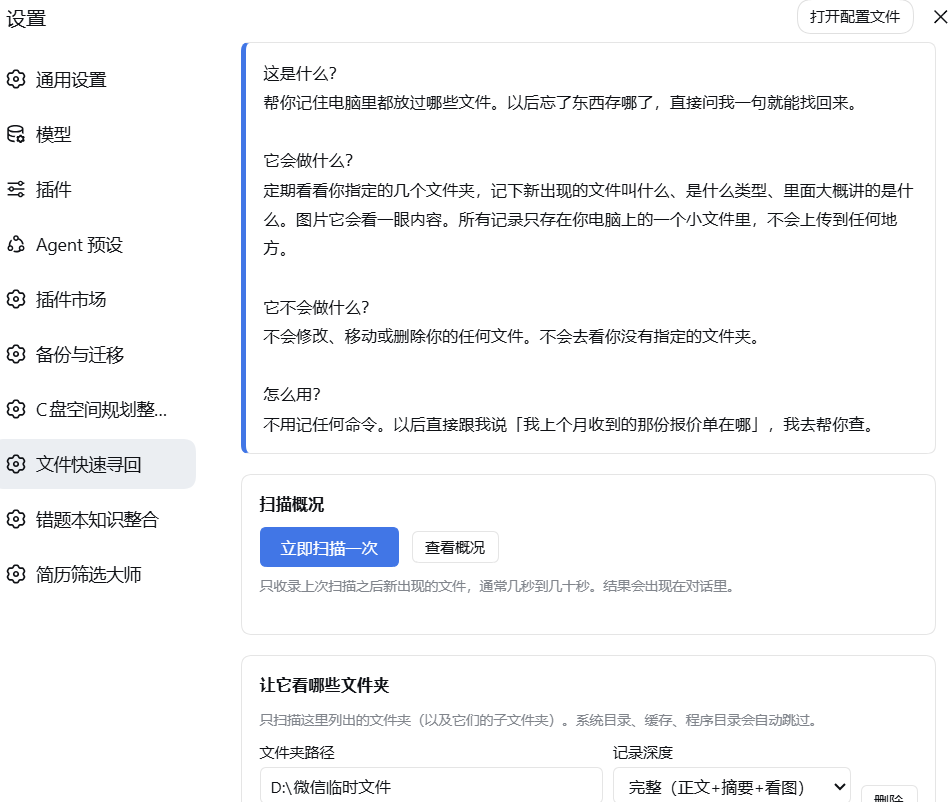
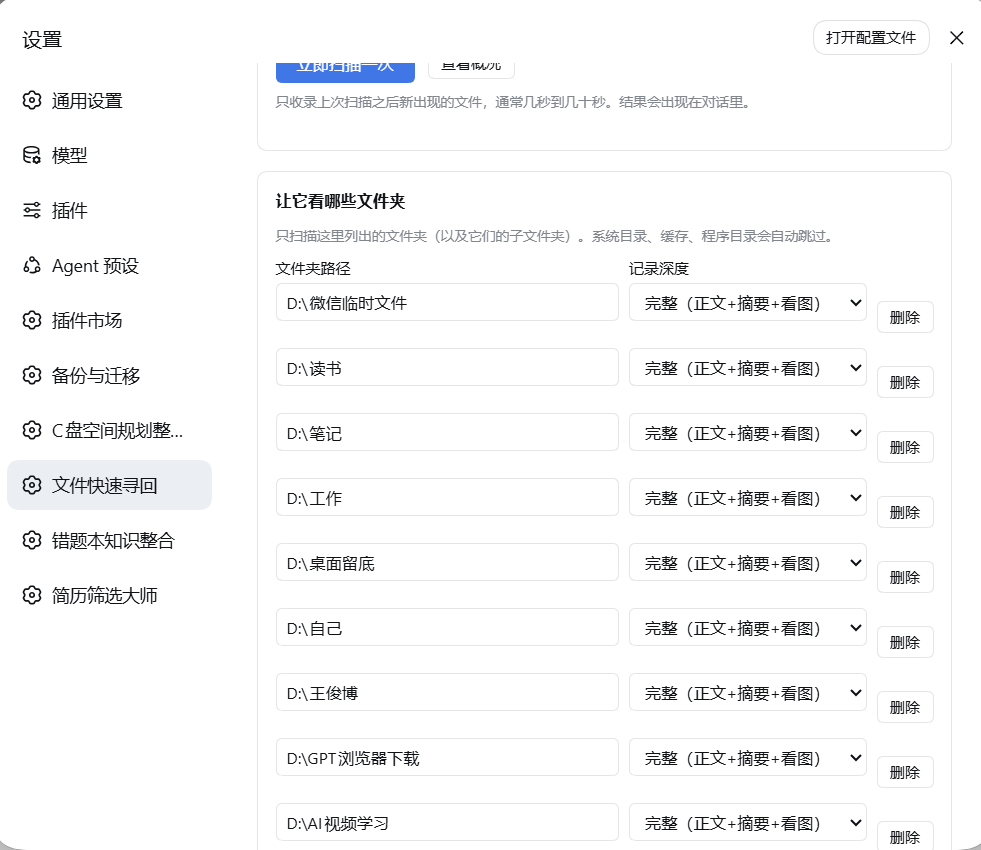
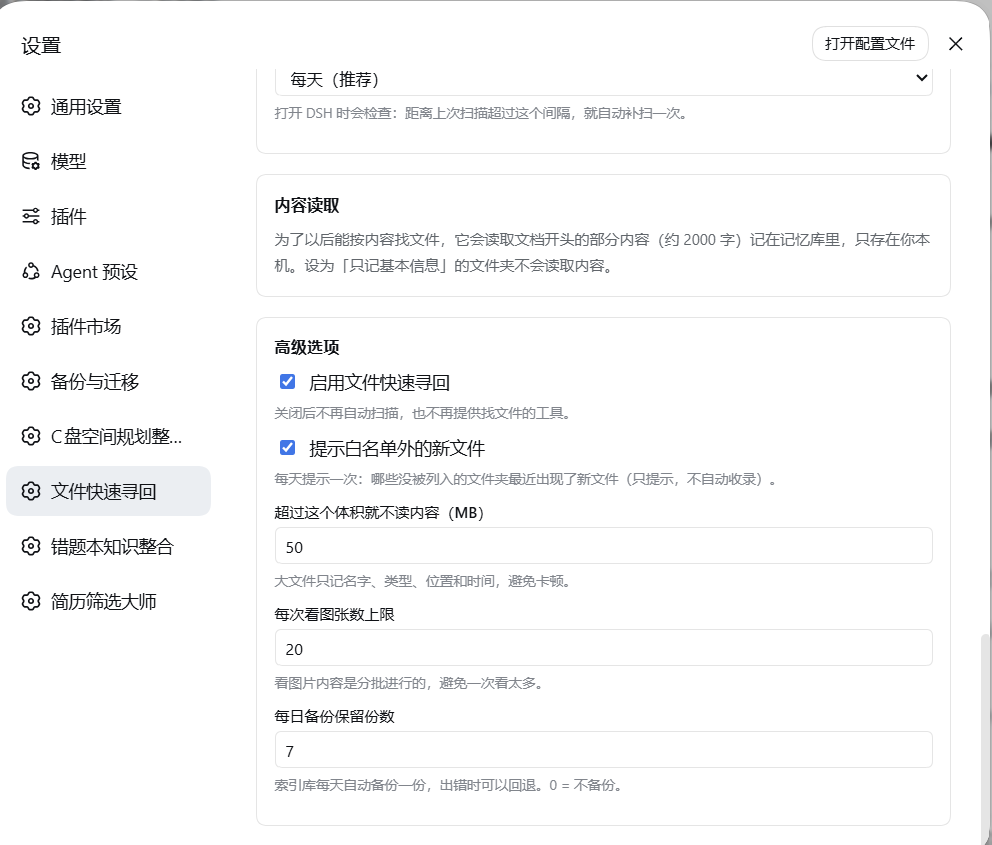
| 设置页:扫描概况与一键扫描 | 监视的文件夹(可逐个设内容深度) | 高级选项 |
|---|---|---|
 |
 |
 |
English summary
dsh-lost-and-found answers "where did I put that file?" from a local SQLite
index instead of walking your disk on every question. You pick the folders to
watch; the plugin records what appeared — name, type, size, appeared-at, location
and origin — and prunes caches, VCS and program folders at the directory level,
so a scan of tens of thousands of files finishes in seconds.
Search is two-stage: SQL hard filters (time / type / folder / origin) first, then multi-keyword AND matching scored by where the hit landed (name > tags > path > summary > image description > excerpt), and the result tells you which layer hit. When the index has no hit, the watched folders are scanned live as a fallback — compared only, never written back.
Every watched folder keeps its own incremental anchor. A folder added later is backfilled in full on its first scan; after that it is incremental, and a folder whose scan was interrupted keeps its anchor so the next run finishes the job.
Read-only promise: the plugin never modifies, moves, renames or deletes your files, never writes NTFS alternate data streams, never generates thumbnails, never touches timestamps, and never uploads anything — the whole index is one SQLite file on your machine.
dsh plugin --profile web add dsh-lost-and-found
Requires DSH with the web profile and Node.js ^22 or >=24. Windows-focused
(uses birthtime on NTFS), but nothing here is Windows-only by design.
它做什么
- 按你设定的间隔(每天 / 每 3 天 / 每周)扫描你指定的文件夹;打开 DSH 时会检查是否到期并补扫
- 记录文件名、类型、大小、出现时间、位置、来源,写进本地 SQLite 索引
- 每个目录各有自己的增量锚点:新加入的目录第一次扫描会把它的历史文件一并收进来,之后转为增量
- 支持按关键词、时间范围、文件类型、目录范围、来源组合查找,并按「命中在哪一层」加权排序
- 索引里没有的,会对扫描目录做一次实时兜底扫描,尽力找回(只读,不写库)
- 图片内容可以交给模型看过之后写回描述,之后按画面内容也能搜到
- 提示你扫描范围之外哪些文件夹最近出现了新文件(只提示,不自动收录)
- 记忆库可随时从零重建:索引是派生数据,不是唯一真相
它不做什么
- 绝不修改、移动、重命名或删除你的任何文件
- 不会去看你没有指定的文件夹
- 不写 NTFS 附加数据流(ADS)、不生成缩略图、不改任何时间戳
- 不联网上传任何内容:所有记录只存在你本机的一个 SQLite 文件里
- 不做文件同步、不做备份、不做重复文件清理(那些是别的工具的职责)
怎么用
不用记命令。直接说人话:
- 「我上个月收到的那份报价单在哪?」
- 「我让你写的那份关于 XX 的报告存哪了?」
- 「下载的那个安装包放哪了,好像这周下的」
- 「我记得有张截图,上面有转账金额 1280」
也可以直接调用工具:
| 工具 | 作用 |
|---|---|
file_find |
找文件(核心):关键词 + 时间/类型/目录/来源过滤,索引没命中时自动兜底 |
file_index_scan |
立刻扫描一次(wait=true 等它跑完;full=true 强制忽略锚点全量重扫) |
file_index_status |
概况:上次扫描时间、库内数量、扫描目录、待处理项、库位置 |
file_index_open |
在资源管理器里定位某个文件 |
file_index_forget |
从记忆库里删掉某条记录(不动文件) |
file_index_verify |
手动检查一批记录是否还在原处 |
file_index_pending_images / file_index_set_image_desc |
图片内容的「待看清单 / 写回描述」 |
环境要求
- DSH,使用
webprofile - Node.js
^22或>=24(用到内置node:sqlite) - 无需 API key、无需联网;扫描与检索全部在本机完成
安装
从 npm:
dsh plugin --profile web add dsh-lost-and-found
直接从仓库:
dsh plugin --profile web add https://github.com/wangzhanchao883/dsh-lost-and-found
开发期把工作副本链进 profile(改完必须重启 DSH,插件源码不热更新):
dsh plugin --profile web add link:/path/to/dsh-lost-and-found
配置
设置页里有:扫描概况与「立即扫描」按钮、扫描目录(可增删,每个目录可单独设内容深度)、记忆库存放位置、扫描间隔、内容读取说明与高级选项。
| 配置项 | 默认 | 说明 |
|---|---|---|
enabled |
true |
关闭后不再自动扫描,也不再提供找文件工具 |
roots |
[] |
要监视的目录,每个目录带自己的 policy |
dbPath |
空 | 索引库位置;留空用 %LOCALAPPDATA%\dsh-lost-and-found\index.db |
intervalDays |
1 |
自动扫描间隔;0 = 只手动 |
firstScanMode |
full |
一个目录第一次被扫时收多久:full 全部历史 / window 最近 firstRunWindowDays 天 / none 只收今后新增 |
firstRunWindowDays |
7 |
仅当 firstScanMode = window 时生效 |
maxFileMB |
50 |
超过此体积只记基本信息,不读内容 |
imageQuotaPerRun |
20 |
每次看图配额 |
patrolEnabled |
true |
是否提示白名单外有新文件的目录 |
backupKeep |
7 |
每日备份保留份数,0 = 不备份 |
extraExcludeDirs / extraExcludePatterns |
[] |
追加的排除目录名 / 路径片段(re: 前缀表示正则) |
扫描目录的内容深度(每个目录可不同)
- 完整:记基本信息,并允许把图片交给模型看过之后写回描述(默认)
- 只摘要:记基本信息;不把图片交给模型
- 只记基本信息:只记名字、类型、位置、时间(适合含证件/合同等敏感内容的目录)
下拉框里的档位名写的是「完整(正文+摘要+看图)」,其中正文与摘要抽取尚未启用,见下方路线图;当前真正生效的是「图片是否看图」。
架构速览
用户提问
   │
   ├─ file_find ──► ① SQL 硬过滤(时间/类型/目录/来源/状态/噪音)
   │                   ② 多关键词 AND 匹配(name/path/tags/summary/image_desc/excerpt)
   │                   ③ 命中位置加权打分 + 近 7/30 天加成
   │                   ④ 逐个 stat,标注「还在 / 已不在此处」
   │                └─ 索引无命中 ──► 对扫描目录做一次只读实时兜底扫描
   │
   └─ 扫描(独立子进程,PID 锁)
         ├─ 逐目录取自己的锚点(从未扫过 → 按 firstScanMode 回填)
         ├─ 目录级剪枝 + 跳过临时/缓存件
         ├─ 逐目录回报 completed
         └─ 只给「真正走完」的目录推进锚点;完成后写库、轮转备份
目录结构
index.mjs            host 入口:设置命名空间、工具注册、派发扫描
client.js            web 客户端:设置页那一段
config.mjs           默认值、剪枝规则、运行快照
db.mjs               SQLite 表结构、迁移与查询
core/scan.mjs        遍历器(剪枝、逐目录窗口、逐目录完成状态)
core/schedule.mjs    锚点与排期(computeSinceMs / rootSinceMs / isDue)
core/search.mjs      查询构造、打分、实时兜底扫描
core/run-scan.mjs    扫描子进程入口(独立进程 + PID 锁)
core/classify.mjs    类别、来源、噪音判定
core/format.mjs      体积与时间的可读化
tools/selftest.mjs   离线自测(不依赖 DSH)
docs/                设计与路线图文档(不进 npm 包)
一些实现上的取舍(写给愿意深看的人)
- 不判断「作者是谁」:Windows 无法可靠回答「这个文件是谁创建的」(NTFS Owner 只反映系统账户)。所以本插件索引的是**「最近出现在你地盘上的新文件」**——对「我找不见文件了」这个真实需求,这个口径更好用。
- 目录级剪枝:
node_modules、.git、各种缓存、程序目录命中的整棵子树都不下钻,而不是逐文件过滤。这让几万个文件的扫描只要十几秒。 - 不做全文检索索引:FTS5 的可用性取决于 Node 版本(实测系统 node v22.14.0 报
no such module: fts5,而 QClaw 自带、DSH 运行时用的 v22.22.3 是带 FTS5 的)。为了在两种环境下都能跑,检索统一走「SQL 硬过滤 + 多关键词 LIKE 取交 + 命中位置加权」。中文无需分词,子串匹配天然可用,几万行的查询在百毫秒级;将来检测到 FTS5 可用时可作为加速路径启用。 - 扫描跑在独立子进程:遍历是重 IO,放在 DSH 主进程里会拖慢界面。子进程只做 IO,写完库就退出,并用 PID 锁保证同一时间只有一个实例。
- 索引是可重建的派生数据:库丢了不要紧,重新扫描即可。查询永远带实时兜底,绝不把索引当作唯一真相。
- 每个扫描目录有自己的增量锚点:锚点存在
roots表里(last_scan_ms/first_scan_done),不是全局共用一个。这是必须的——全局锚点会让「后加入的目录」只看到锚点之后 6 小时内的文件,它更早的历史文件永久漏收(实测某个目录 570 个文件只进了 13 个)。只有真正走完的目录才推进锚点,扫描被中断或目录不可读时保留原锚点,下次继续补。 - 新目录首次扫描默认回填全部历史:由
firstScanMode控制;老库升级后first_scan_done为 0,下一次扫描会自动逐目录补一次,然后转为增量。
已知限制与路线图
已知限制
- 索引只覆盖你配置的目录;目录之外的文件只能靠实时兜底扫描按名字/时间找到,搜不到内容。
- 正文与摘要抽取尚未启用:
summary/excerpt字段目前不会被写入,所以「按文档内容找」还不成立(图片描述是走通的)。设置页的档位名与本节描述以此为准。 - 一个目录一天最多真扫一次(
intervalDays);刚下载的文件可能还没进索引——此时用兜底扫描或file_index_scan。 - 文件「出现时间」取
birthtime与mtime的较大值;被网盘/同步工具改写过的mtime会让时间维度失真。 - 暂不支持:视频/音频内容理解、压缩包内文件、全文检索服务。
路线图
- 内容索引 P0(零模型成本):本地抽取文本/Office/PDF 正文,图片元数据与描述入库,检索同时搜文件名与内容,并标注「命中文件名 / 命中内容」。
- 图片内容 P1:按价值排序的看图队列,批量看图写回描述;名字与内容明显不符的单独出报告(只给建议名,绝不改名)。
- 语义检索 P2:本地 BM25 / 字符 n-gram,解决「记不清词只记得大概意思」。
设计细节见 docs/内容索引与文件名脱钩-方案.md。
开发与自测
没有任何依赖需要安装:插件只用 Node 内置模块(node:sqlite / node:fs / node:zlib)。
npm test # 全量语法检查 + 离线自测(不依赖 DSH、不联网、不需要 API key)
tools/selftest.mjs 覆盖了 v0.1.1 修掉的那几类问题:新目录首扫全量回填、二次扫描幂等、中断不推进锚点、以及「文件名与内容脱钩」时的内容命中。CI 在 Node 22.x / 24.x 上跑同一套,且不执行 npm install,完全离线可复现。
许可
MIT — 见 LICENSE。
No comments yet. Be the first to write one.