角色头像框 · dsh-avatar-frame
DeepSeek Harness 的界面插件:在每轮 AI 回复左侧显示角色头像和可编辑的 ID,并可以把回复朗读出来——用系统语音,或者调用你自己跑的本地 TTS 服务;也可以在设置里一键启动、停止那个服务进程。
An avatar frame and read-aloud plugin for DeepSeek Harness. It ships no voice model, no reference audio and no service: if you want a cloned voice, you run your own TTS endpoint and point the plugin at it (the plugin can launch that process for you).
功能
形象
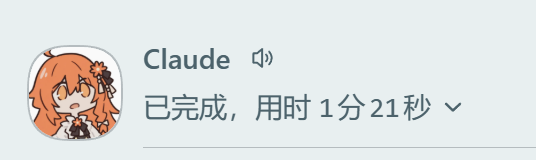
- 每轮 AI 回复左侧显示圆形头像,右边是可点击编辑的 ID,与「已完成,用时 …」那一行对齐;
- 上传图片 → 拖动/缩放裁切 → 应用到所有轮次;
- ID 字号可调(10–20px);
- 预设:最多 8 套「头像 + ID + 字号」,一键切换;预设图压缩成 JPEG,不占空间。
朗读
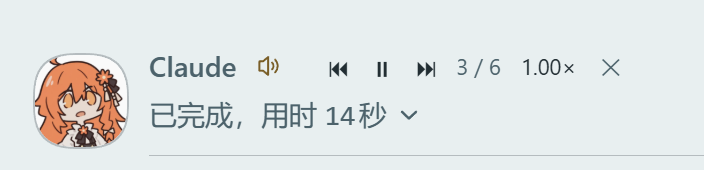
- 点 ID 右侧的小喇叭,朗读这一条回复的正文(只读最终回答,不读思考过程和折叠的工具步骤);
- 两种引擎:系统语音(开箱即用)或你自己的本地服务;
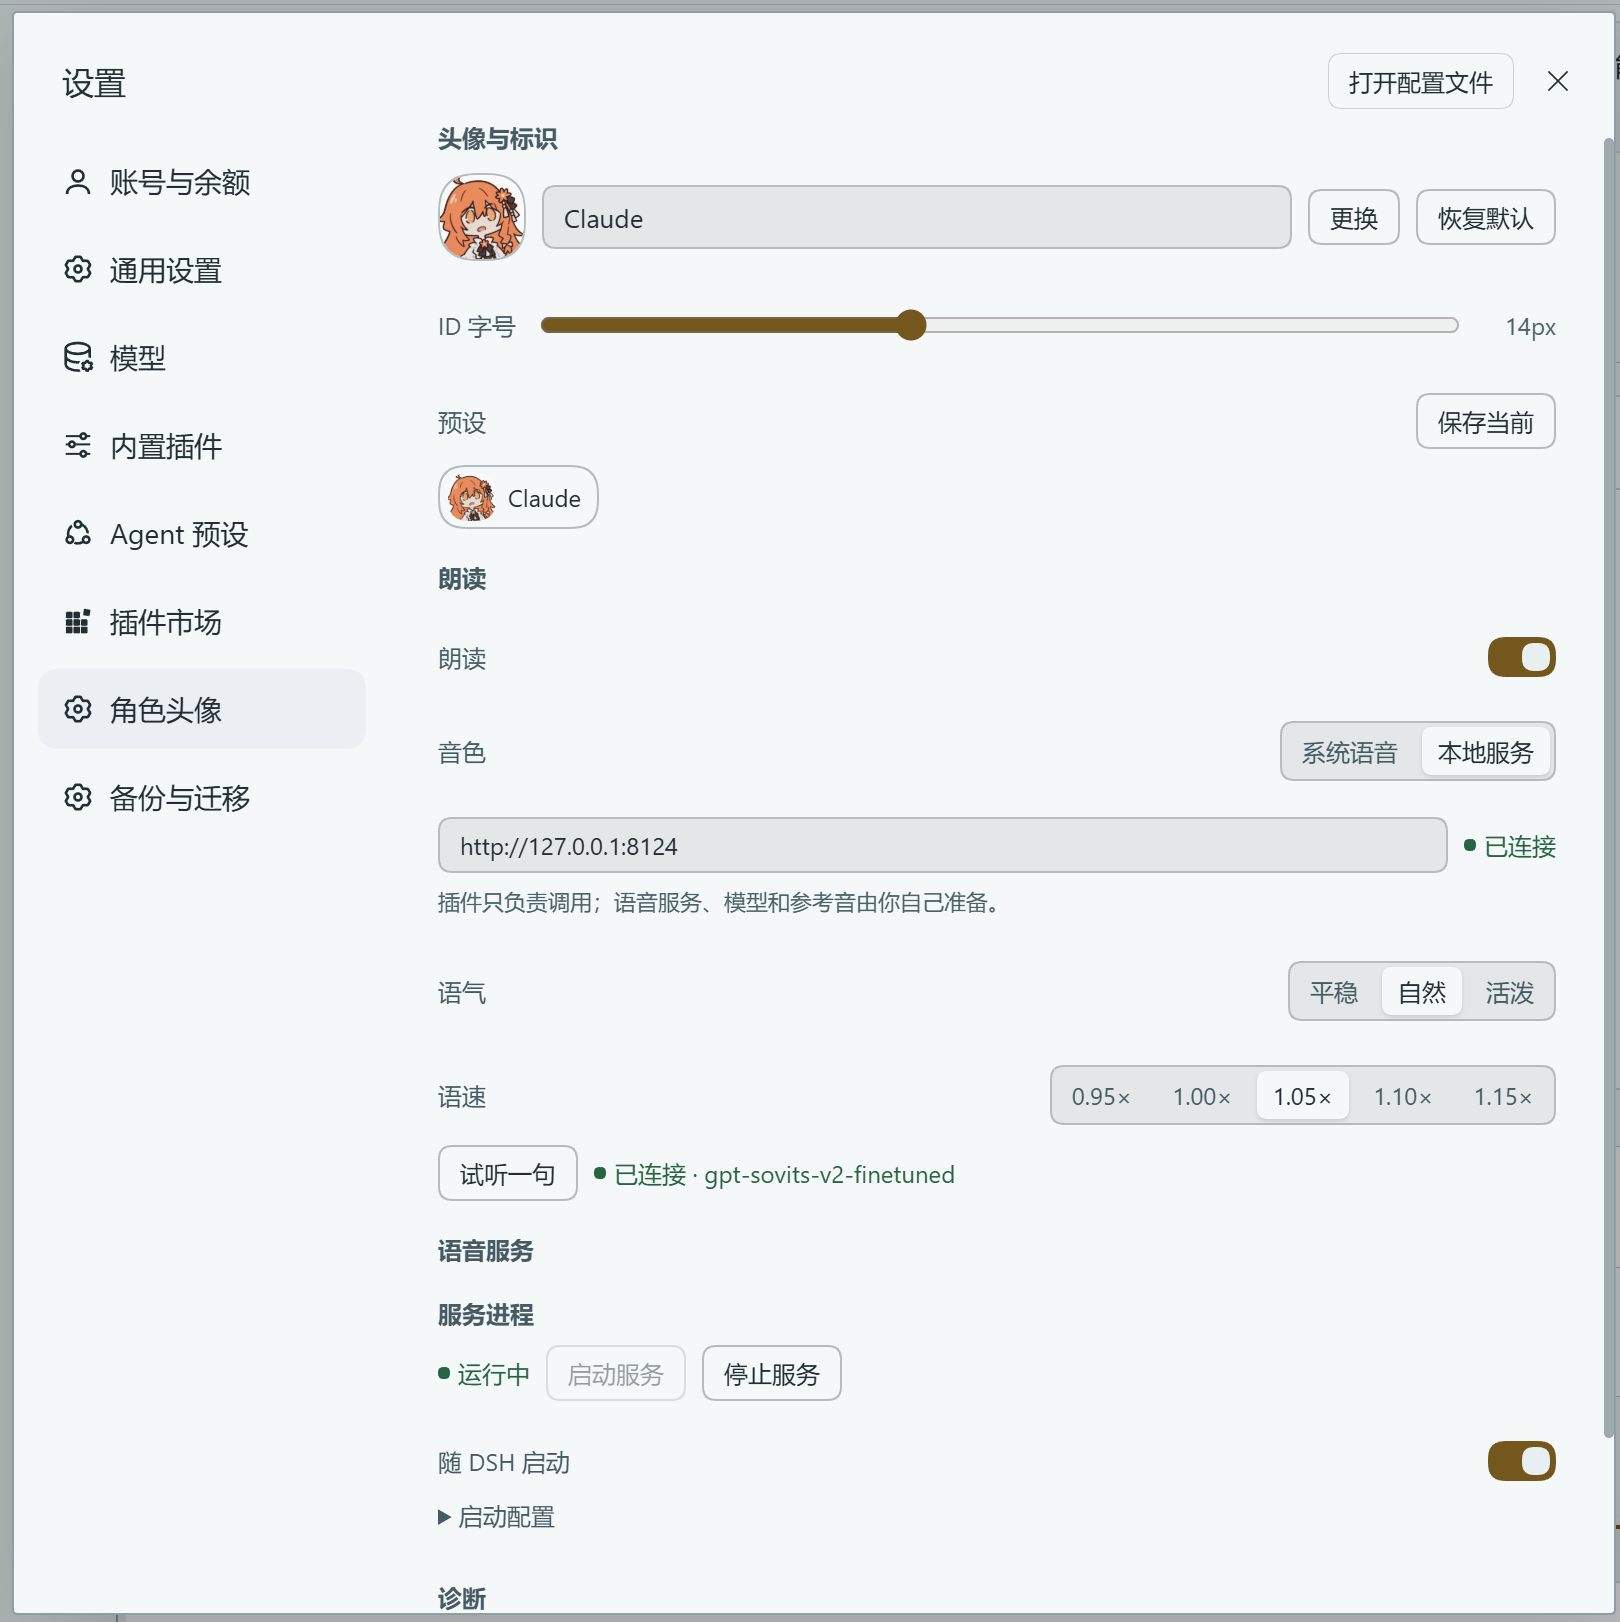
- 播放控制条:朗读时接在小喇叭右侧,可暂停/继续、上一句/下一句、五档语速(0.95× / 1.00× / 1.05× / 1.10× / 1.15×)、停止;
- 语气三档:平稳 / 自然 / 活泼,随请求发给你的服务;
- 试听:不用回到聊天,在设置里直接试一句;
- 失败提示:某句合成失败时,小喇叭旁出现红点,悬停可看原因;
- 长回复按句切分、提前两段预生成,句间不卡顿。
其他
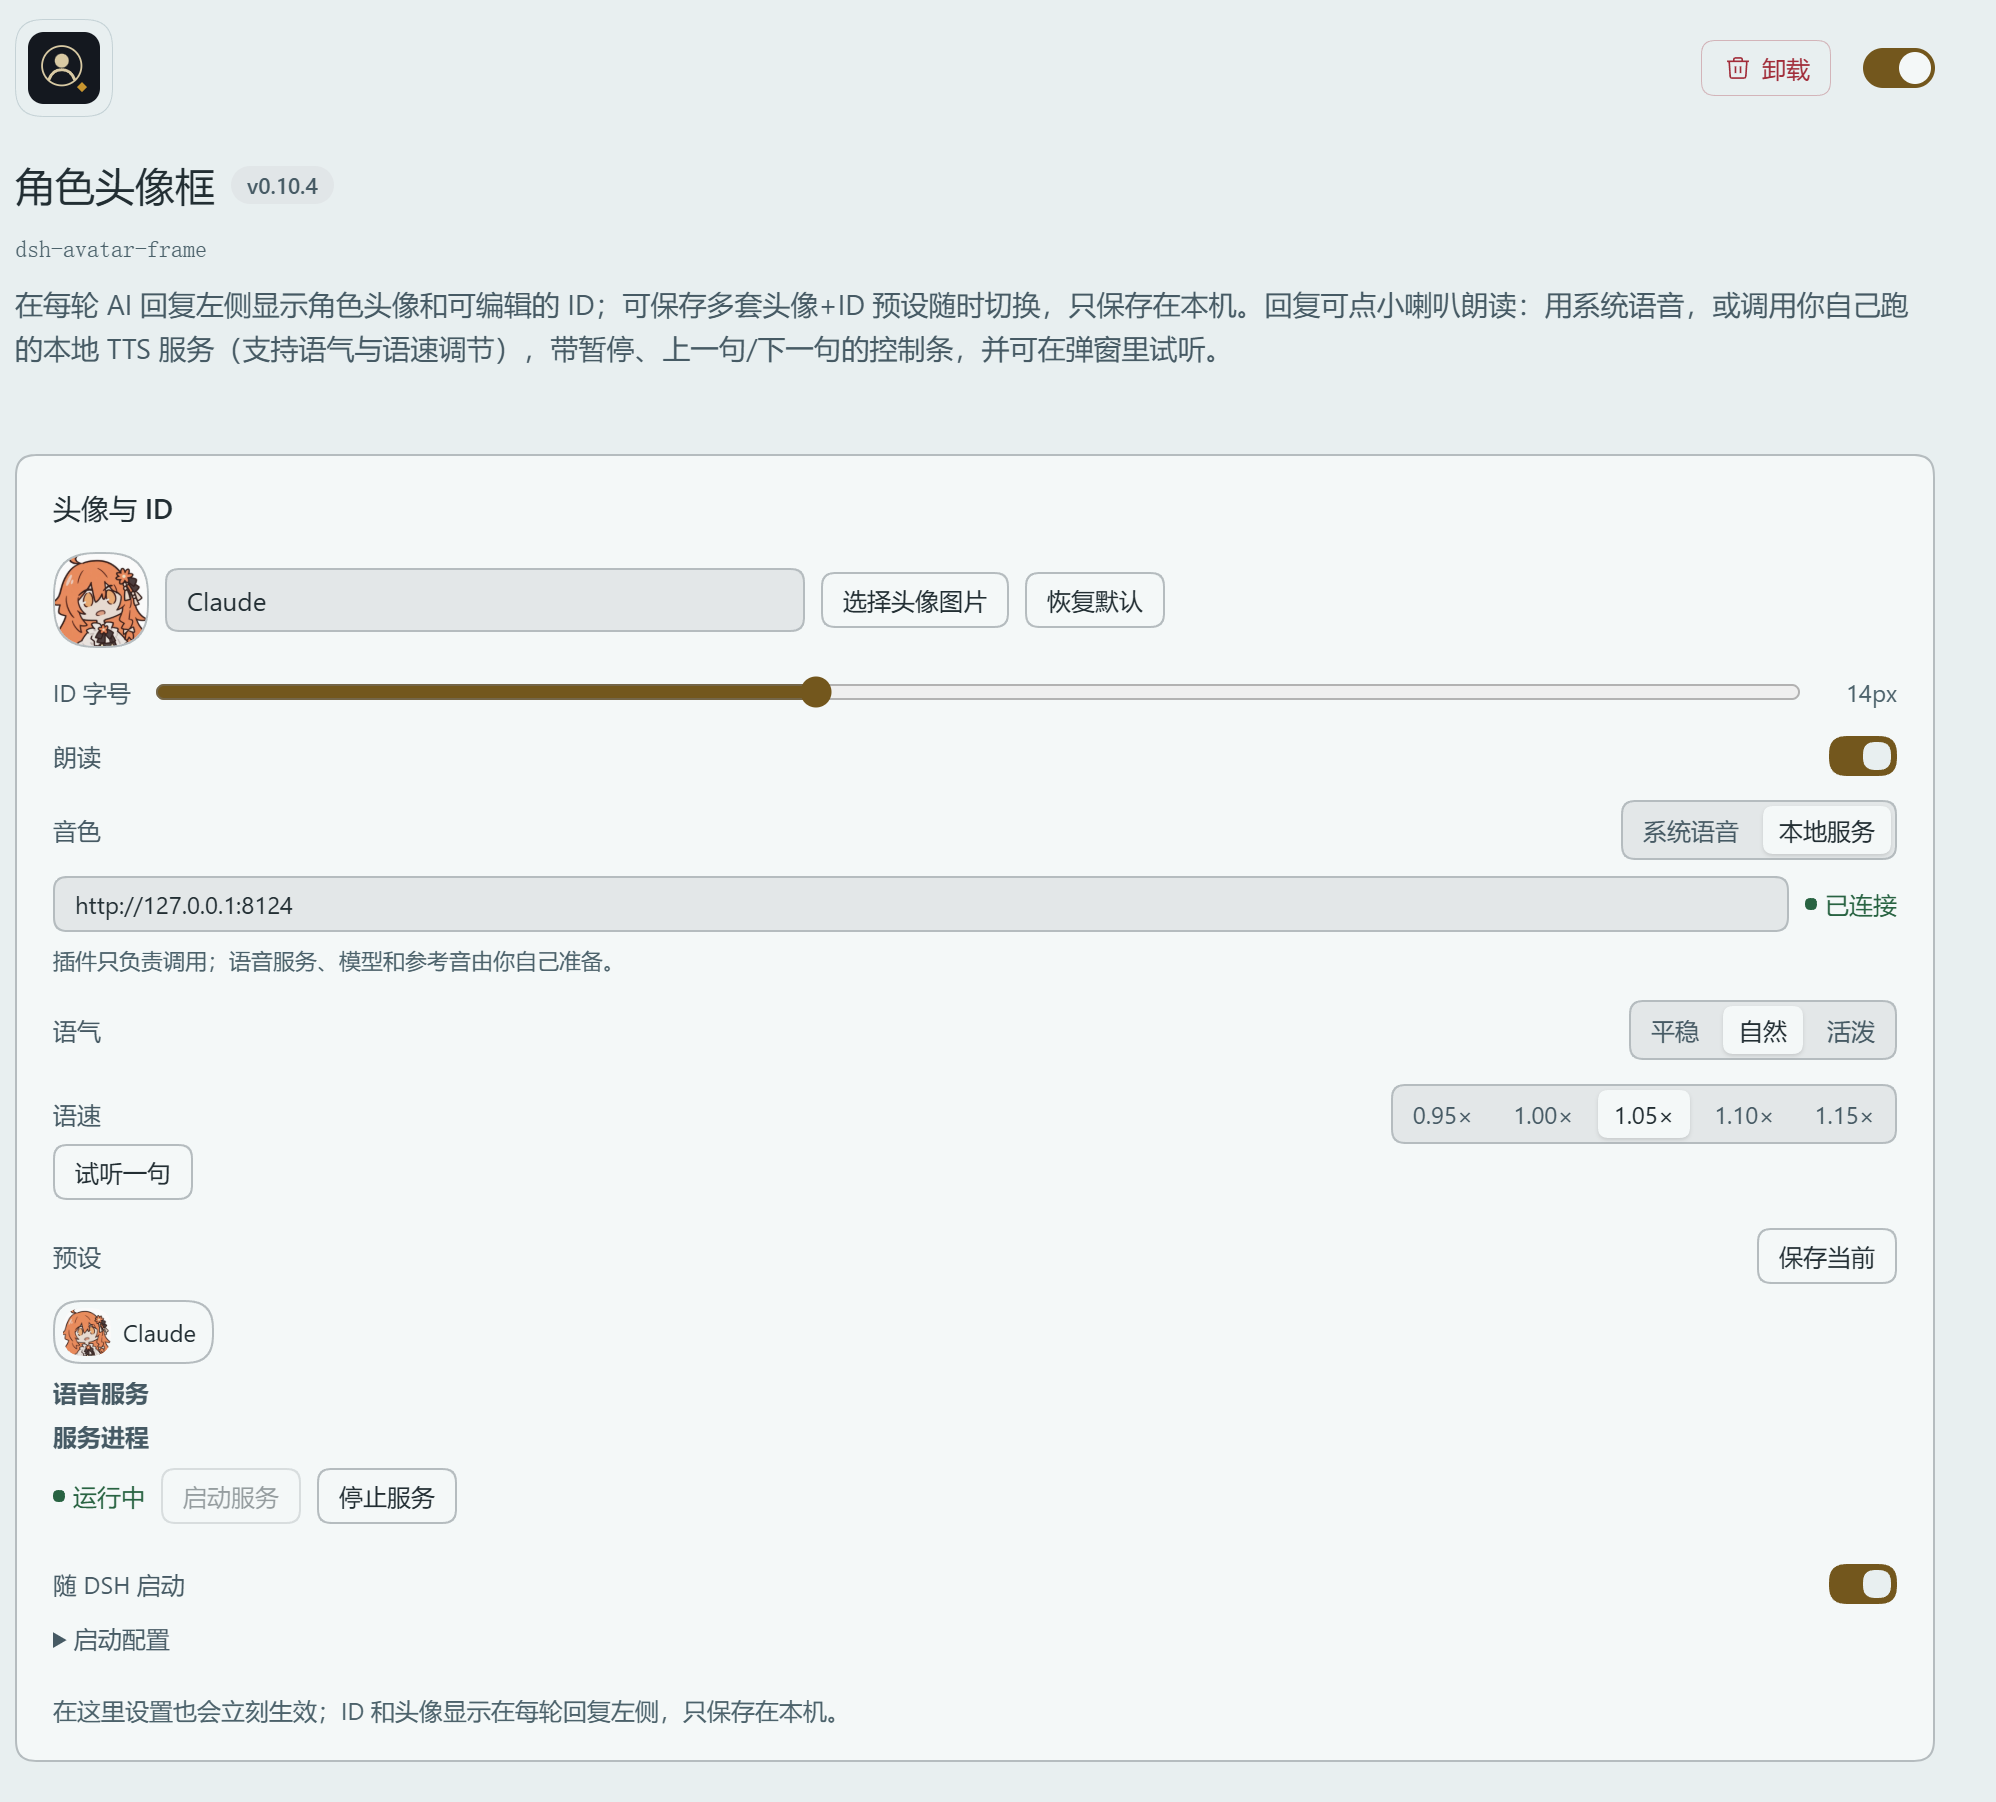
- 设置 → 角色头像:头像、ID、字号、预设、朗读、引擎、语气、语速、服务地址、试听、诊断都在这页;
- 语音服务进程:一键启动/停止你自己配置的服务进程,可勾选「随 DSH 启动」(设置页与插件详情页都能操作);
- 诊断信息:服务状态与模型名、上一句合成耗时、播放进度、最近一次错误;
- 中文 / English 双语文案;
- 所有数据只在本机
localStorage,不上传、不联网(除非你把服务地址指向远程)。
安装
从本地目录安装
- 把本仓库放到任意目录;
- 打开 DeepSeek Harness → 插件管理 → 安装外部 bundle,指向这个目录(含
package.json与cordis.patch.yml); - 打开一次界面;插件的前端模块在页面加载时注入,必要时刷新(Ctrl+R);
- 「启动服务」那一块跑在宿主端,首次安装、以及每次升级这个插件后,需要重启一次 DSH 才生效。
从 GitHub 安装
git clone https://github.com/vioeveann/dsh-avatar-frame.git
然后同上,把插件管理指向克隆下来的目录。
使用
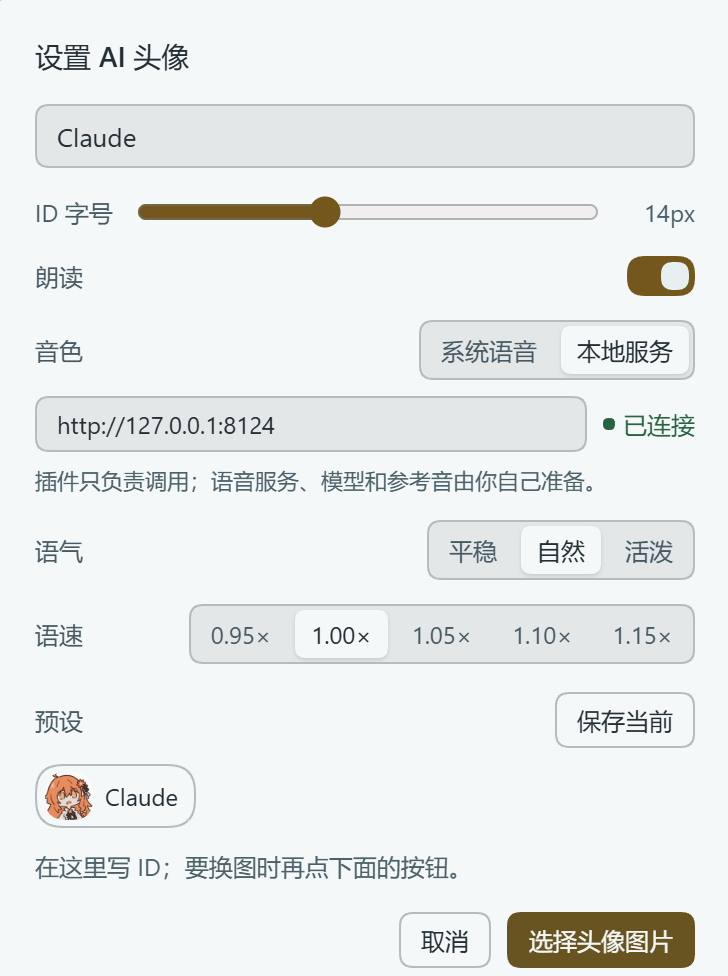
- 点任意一轮回复左侧的头像,或「已完成」那一行的 ID,打开设置面板;
- 点「选择头像图片」上传图片,在裁切框里拖动、滚轮缩放,确定;
- 在面板顶部的输入框里写 ID(角色名、代号都行),字号按需调;
- 想留一套搭配就点「保存预设」,最多 8 套;
- 需要朗读就把「朗读」打开,然后点回复旁边的小喇叭。
语音
插件本身不下载模型、不附带参考音频、不启动任何服务。它只做两件事:用系统语音读,或者调用你给的 HTTP 服务。
默认地址 http://127.0.0.1:8123,可在面板、插件详情页或设置页修改,旁边会显示「已连接 / 未连接」的实时状态。服务不可用时会自动退回系统语音。
状态点每 8 秒自动重试一次,所以先启动服务、再看那一点变绿即可,不用刷新界面。
先用一个示例跑通
仓库里带了一个最小实现,用微软 Edge 的在线语音,够你确认整条链路:
pip install edge-tts
python examples/simple_tts.py          # 监听 127.0.0.1:8123
然后把插件里的服务地址填成 http://127.0.0.1:8123,点小喇叭。想要自己的音色,把示例里的 synthesize() 换成你的引擎即可。
一键启动服务(可选)
插件的宿主端可以替你启动那个服务进程,入口有两处、内容一致:设置 → 角色头像 → 语音服务,以及插件详情页的同名区块。
- 「启动服务 / 停止服务」:执行你填的那条命令;
- 「随 DSH 启动」:DSH 启动时自动把它拉起来(不是开机自启);
- 「启动配置」里填:启动命令、工作目录、环境变量(每行
KEY=VALUE)。
例如:
启动命令   "F:\tts\python.exe" server.py
工作目录   F:\tts
环境变量   HF_HOME=F:\tts\hf-cache
想直接用仓库里的示例服务试这个功能:
启动命令   python examples/simple_tts.py
工作目录   <本仓库所在目录>
几点要说清楚:
- 命令是你自己填的,插件不附带任何服务;它只是替你执行、托管这个子进程。
- 进程的生命周期跟随 DSH:DSH 退出时它会被一起收掉;「随 DSH 启动」只在 DSH 启动时执行一次。
- 端口上已经有服务在跑时(比如你手动开的),插件会显示「端口上已有服务(非本插件启动)」,不会重复启动。
- 宿主端代码在 DSH 启动时加载,所以安装或升级插件后要重启一次 DSH,这一块才可用;界面会提示「宿主端未加载」。
接口契约
完整说明见 docs/tts-contract.md。核心是三个请求:
GET  /health
  -> 200 {"ok": true, "model": "任意字符串"}

POST /tts
  {"text": "要读的文本", "speed": 1.05, "tone": "normal"}
  -> 200,Content-Type 为音频(audio/wav、audio/mpeg 均可),body 为音频数据
另外需要允许 CORS(Access-Control-Allow-Origin: *,并响应 OPTIONS 预检),因为插件在网页里请求它。
tone 是建议值,服务端不认识就忽略;speed 范围 0.7–1.3。
设置与数据
入口:设置 → 角色头像。所有设置都存在本机浏览器的 localStorage:
| 键 | 内容 |
|---|---|
dsh-avatar-frame/image/v1 |
头像图片(data URL) |
dsh-avatar-frame/id/v1 |
ID 文本 |
dsh-avatar-frame/size/v1 |
ID 字号 |
dsh-avatar-frame/presets/v1 |
预设列表 |
dsh-avatar-frame/speech/v1 |
朗读开关 |
dsh-avatar-frame/engine/v1 |
引擎(system / clone) |
dsh-avatar-frame/endpoint/v1 |
服务地址 |
dsh-avatar-frame/rate/v1 / tone/v1 |
语速 / 语气 |
同一个浏览器的多个窗口之间会同步。换电脑、清缓存会丢,插件没有云同步。
已知限制
- 只支持 Web 平台的 DeepSeek Harness;
- 插件接管了「已完成,用时 …」这一行的渲染,用来把头像放进左侧留白。停用或卸载插件后请刷新一次界面,否则这一行会显示「未知 surface 事件:turn-process」;
- 头像只在一轮结束后出现,流式输出过程中没有——那需要接管整个回答渲染器,代价太大;
- 与同样接管
turn-process的其他插件会冲突; - 朗读是按句切分的,句子之间靠播放器衔接;如果某一句失败,会跳过该句继续读后面的;
- 「一键启动服务」的宿主端代码在 DSH 启动时加载,升级插件后要重启一次 DSH;
- 该功能会按你填写的命令执行本机程序,请只填你自己的服务;路由走 DSH 本机同源请求,没有额外鉴权,别把 DSH 暴露到公网。
目录结构
.
├── package.json          # bundle 元信息与前端入口声明
├── cordis.patch.yml      # 插件装配
├── index.js              # 宿主端:语音服务的启动/停止与配置(同源路由)
├── client.js             # 前端:界面、播放、设置页(单文件、无构建)
├── locale/               # zh / en 文案与插件描述
├── icon.svg
├── README.md
├── CHANGELOG.md
├── LICENSE
├── docs/                 # 接口契约、截图、发布步骤
└── examples/simple_tts.py
client.js 是单文件、无构建、无依赖(除 React 由宿主提供):改完刷新界面即可生效。
index.js 只在 DSH 启动时加载:改动它需要重启 DSH。
发布新版本的流程见 docs/releasing.md。
许可
代码以 MIT 发布。
插件不包含任何语音模型、参考音频或音色文件。你用到的模型、参考音频、第三方语音服务的许可与版权,需要你自行确认与遵守;请勿把他人声音素材随本插件分发。
No comments yet. Be the first to write one.