dsh-find-ideas





动手造轮子之前,先看看有没有人已经做过。
DeepSeek Harness 插件 · 四个工具 · 零运行时依赖 · Node ≥ 22
看效果 · 安装 · 四个工具 · 卡片结构 · 已知边界 · 版本
中文 English
效果示例
用一句话描述你的想法,agent 去 GitHub 上搜索同类项目,按「相关性 × star」加权打分排序后返回一张卡片。从卡片里挑几个仓库,它再去读它们的 README、依赖清单、目录树和关键文件,整理出一份可以借鉴的技术方案。
下面是一次调用会返回的卡片:
🎯 针对 idea 排序后的候选(共 3 个,按 relevance × (1 + log10(max(star,10)+1)) / 2 排序)
   "a local-first Markdown note-taking app with wiki links"
   候选池来源:scout_projects

【代码计算区】本区字段分三类,按类读取:
  · relevance:调用方自己的判断(0-10),工具不计算、也不校验它是否正确;新输入由 problem/workflow/technical 维度派生,旧输入保留为 legacy。
    维度缺失显示为未知,不会被当成 0;borrowability 只表示潜在借鉴价值,不进入主排序。
  · stars / pushed_at / description:调用方传入的元数据,来源未经工具核实;
    调用方自带候选时,工具不会去 GitHub 复查这三项。
  · 得分 / 评级 / 顺序:由上面两类派生,可按公式复算(评级是 relevance 的纯函数,本表不单列)。
  算术可复算,不等于输入是真的;工具没有报警,也不等于它核实过任何东西。

──────────────────────────────────────────────────────────────
| # | 项目 | 最近更新 | relevance | stars | 得分 | 语言 | 简介 |
|---|---|---|---|---|---|---|---|
| 1 | [siyuan-note/siyuan](https://github.com/siyuan-note/siyuan) | 2026-10-16T04:07:45Z | 9/10 | 46.8k | 22.7 | TypeScript | A privacy-first, self-hosted, fully open source personal knowledge management software |
| 2 | [logseq/logseq](https://github.com/logseq/logseq) | 2026-10-16T03:56:13Z | 8/10 | 45.2k | 19.8 | Clojure | A privacy-first, open-source platform for knowledge management |
| 3 | [tstapler/stelekit](https://github.com/tstapler/stelekit) | 2026-10-16T04:06:37Z | 6/10 | 7 | 6.1 | Kotlin | Local-first outliner |
──────────────────────────────────────────────────────────────
排序与星级均由代码按公式计算,不可由模型指定。
复述本卡时,每一行与每一列都必须保留(共八列,含「简介」列):删掉一行或一列是丢失信息,不是缩短表格。

【代码计算区】评分分布:打分 3/3 个候选,噪声(relevance 0)0 个(0%),弱相关(1-2)0 个,入选 3 个。
【代码计算区】长尾:候选池里 star ≤ 100 的小项目 1 个,进入最终榜 1 个。

【调用方说明区】以下文字由调用方提供,未经工具验证,不参与排序与评分。
 · siyuan-note/siyuan:Same problem space: local-first Markdown notes with wiki-style links. [未验证]
 · logseq/logseq:Outliner rather than wiki links, but the same local-first store. [未验证]
 · tstapler/stelekit:Same idea, tiny project, worth reading for the data model. [未验证]
调用无法完成时,它同样返回一个值:
🎯 检索 idea:"一个本地优先的笔记应用"

检索失败,无候选项目。

拒绝执行:idea 含中文,但 keywords 未提供。
  `一个本地优先的笔记应用` 需要英文检索词才能触达值得对标的项目:GitHub 搜索对多词做 AND 匹配,中文句子本身不是好查询,而 logseq、siyuan、Trilium 这类项目都用英文自我描述,中文查询在任何精度下都够不到它们。
  实测:`本地优先的 Markdown 笔记应用,支持双向链接` 单独检索返回 total_count: 0,而 `local-first markdown notes` 返回 30 条并命中 codexu/note-gen。
  请先把 idea 的核心概念翻成 3-6 个英文检索词,再带上 keywords 重新调用(例如把「本地优先的笔记应用」写成 `local-first note-taking`)。
  注意:本工具只能检查是否提供了英文检索词,无法判断翻译质量。

未翻译:本机没有可用的 LLM 服务(`ctx.get('llm')` 为空),无法把「一个本地优先的笔记应用」翻成英文检索词。没有英文词的检索够不到用英文自我描述的项目(logseq、siyuan、Trilium 都属此类)。请把 idea 的核心概念翻成 3-6 个英文词后带上 keywords 重新调用,例如把「一个本地优先的笔记应用」写为 `local-first note-taking`。
安装
# 从 npm 安装(推荐)
dsh plugin --profile web add dsh-find-ideas

# 或从 GitHub 安装
dsh plugin --profile web add github:tianyao2003/dsh-find-ideas
配置 GitHub token(推荐)
GitHub 对未认证的搜索请求限制为每个公网 IP 每分钟 10 次,同一个出口 IP 背后的所有人共用这份额度。配置 token 后提升到每分钟 30 次,按账号计算。
插件通过 DSH 的凭据存储读取 GITHUB_TOKEN。在启动 DSH 的环境里设置它:
export GITHUB_TOKEN=ghp_...          # bash
$env:GITHUB_TOKEN = 'ghp_...'        # PowerShell,仅当前会话
没有 token 也能用,只是 inspect_projects 会拒绝预计超过 10 次请求的匿名批次。
使用
装好后重启 dsh,然后直接说出你的想法,agent 会自己调用四个内置工具。不需要说「GitHub」——只要你的话里有一个想做的东西(哪怕还很模糊)或一句求建议,它就会先打一声招呼,再去小搜一下:
- 「我想做一个本地优先的 Markdown 笔记应用,帮我看一下 GitHub 上的项目。」
- 「我想做个番茄钟,有什么建议?」
- 「要是有个能自动整理小红书收藏的工具就好了。」
它会忍住不搜的情况:你已经在写代码、改 bug 或问实现细节;同一个想法这次会话已经搜过;你在问纯技术概念(比如「什么是 CRDT」);或者你明确说了不用搜。自动搜索每个会话最多两次,之后它会先问你要不要搜。
它会先打招呼再搜:说一句「我先去 GitHub 小搜一下有没有现成的,稍等」再调工具——你能看见它要干什么,不想搜可以当场叫停。这条规则是机械强制的:没打招呼的调用会被工具拒绝一次,让它先补上那句话。
先给你看名字,还是先打分:scout_projects 有个 mode 参数。默认 brief——只把项目名和一句话简介给你看,不跑打分,因为给「有什么建议」这种随口一问先花一次十几 KB 的打分调用不划算。你说「对比一下这几个」「帮我挑一个」时它才用 full,那时才会调 rank_candidates 出卡片。
搜索没结果不是坏事:它会告诉你「GitHub 上没有现成的类似项目」,并把这当作一个空白——可以帮你从零设计。
自动搜索的开关
默认 always:有了想法就自己小搜一下。想让它每次先问你,或干脆不主动搜,在 profile 的 cordis.patch.yml 里给插件加一段 config:
- id: find-ideas
  name: dsh-find-ideas
  config:
    autoScout: ask   # always(默认)| ask | off
always:自己判断,打招呼后搜,每个会话最多两次没人要求的搜索。ask:把「先问一句再搜」写进引导,你点头它才搜;打招呼和预算规则照旧。off:不再主动提这件事(不注册引导段落、不拦截调用),四个工具仍然可以手动用。
配错值(比如 autoScout: alway)会让插件加载失败并指出是哪个值不对,而不是悄悄退回默认。
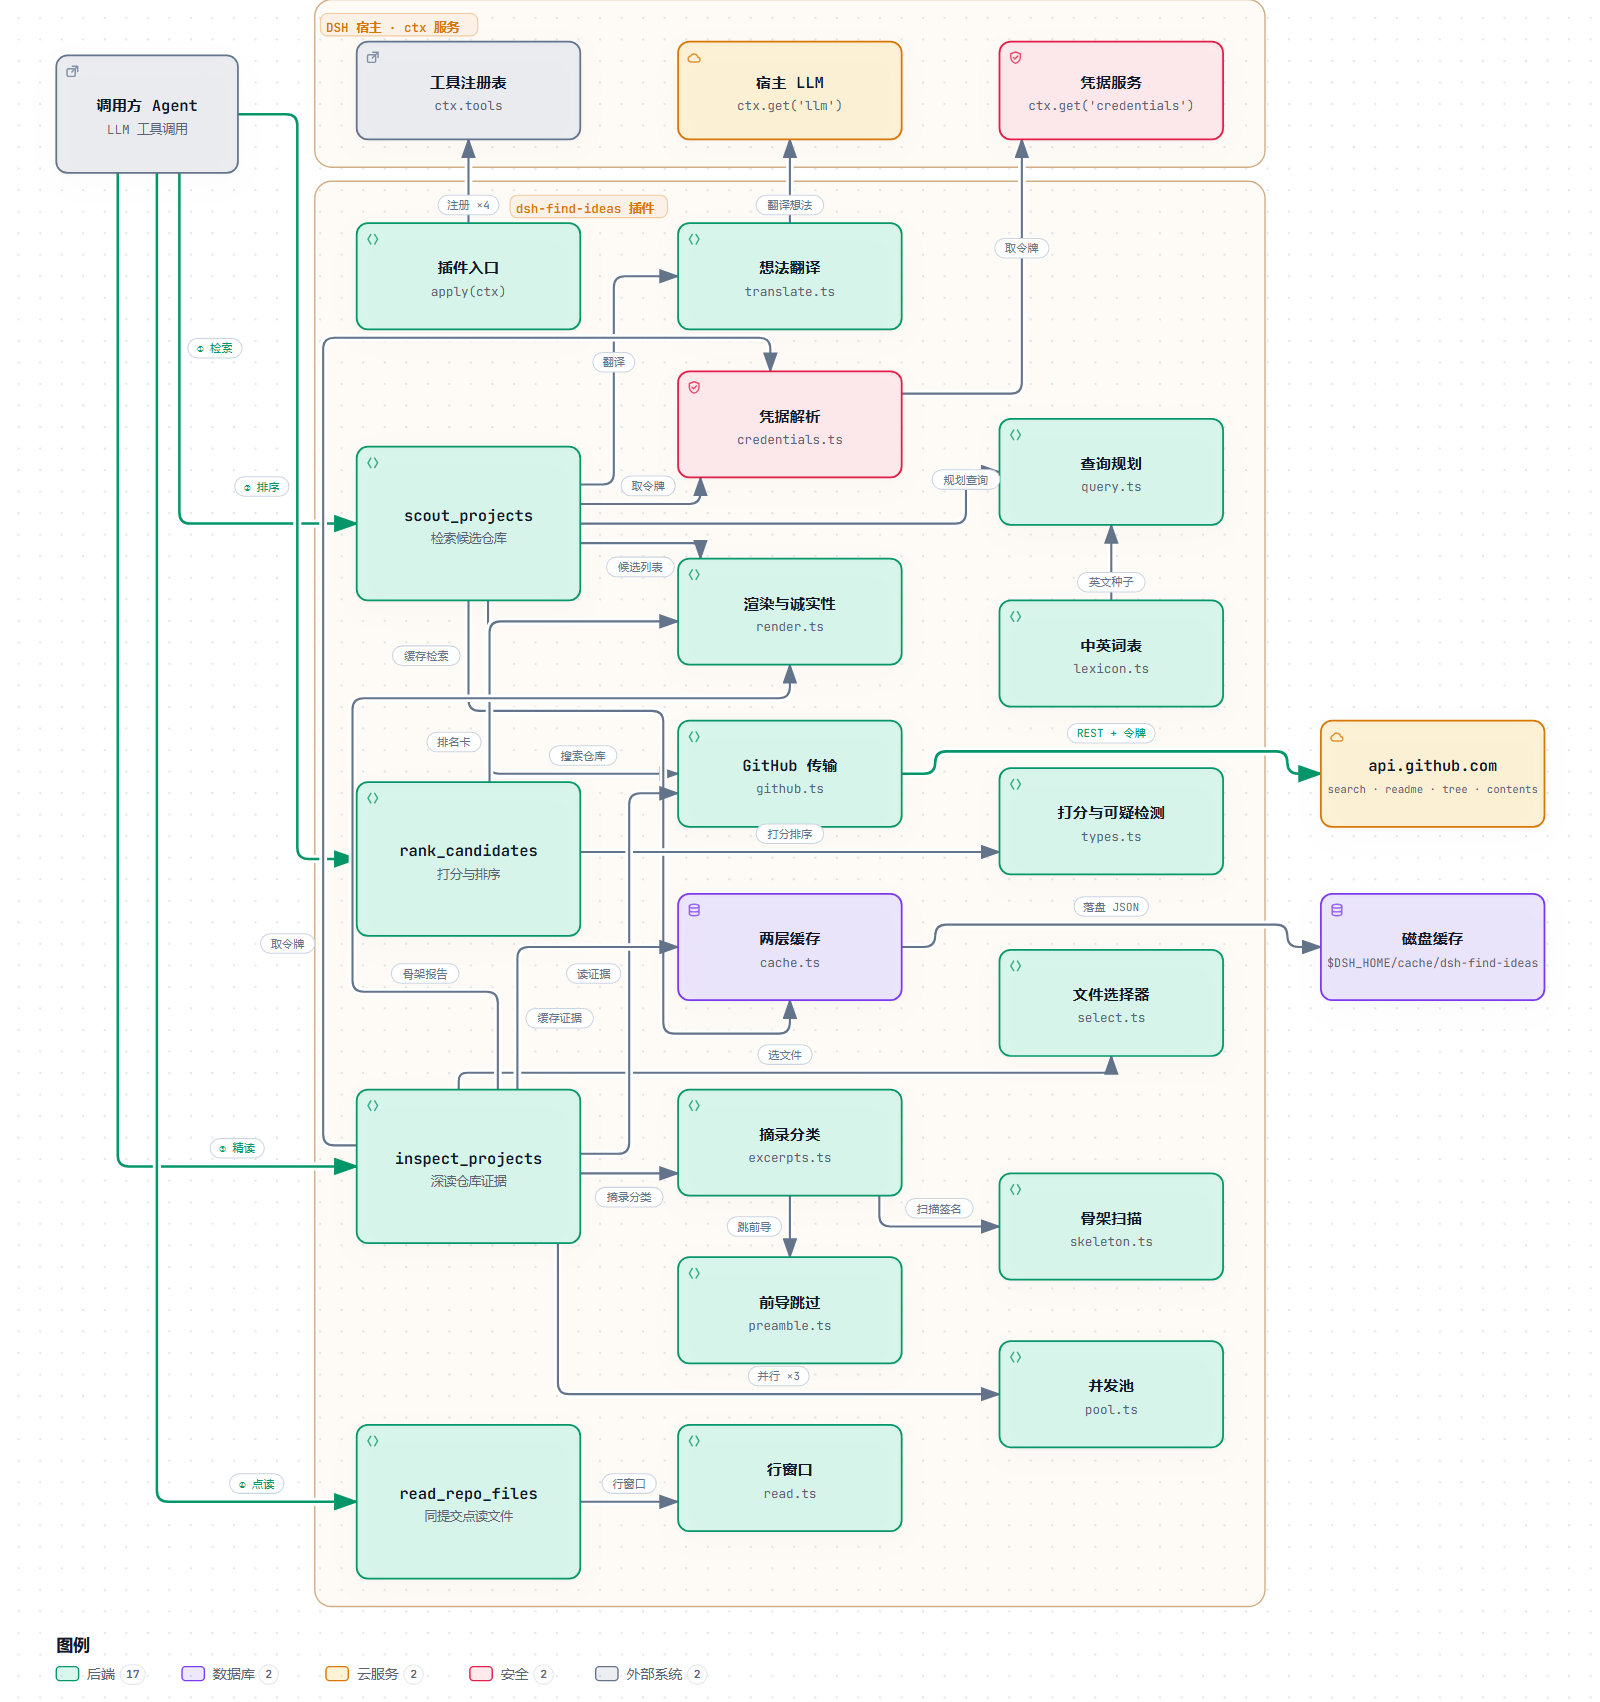
四个工具
| 工具 | 做什么 | 边界 |
|---|---|---|
scout_projects |
把想法拆成多条 GitHub 搜索查询,返回按 star 排序的候选池——刻意不按相关性排序 | 想法里不含拉丁字母时先翻译成英文检索词;做不到就返回 plan_failed。mode="brief"(默认)只作速览、不要求打分,mode="full" 才把打分当作下一步 |
rank_candidates |
按公式给候选池打分并生成卡片 | 接受单个 0–10 relevance,或 problem_fit / workflow_fit / technical_fit 三维(0–5)派生 |
inspect_projects |
读仓库的 README、依赖清单、目录树摘要和关键文件 | 一次最多 5 个仓库;shallow 约 6 次请求/仓库,deep 约 10 次;卡片封顶 24 KB |
read_repo_files |
在同一个提交上点读一个仓库里的文件,返回行窗口和带提交号、行范围的永久链接 | 一次最多 4 个文件;max_bytes 默认 8000(4000–8192),是上限不是建议值 |
read_repo_files(view="architecture") 额外做一次有界的架构侦察:入口文件、直接依赖、路由或命令注册、数据模型、保守的两跳调用链、外部服务边界、观察到的测试行为。每条证据尽量带文件路径和行号;读不到或不支持的部分明确写成未知,不声称完整调用图。
卡片结构
- 固定八列,顺序固定:序号、项目链接、最近更新时间、relevance、star 数、综合得分、开发语言、一句话简介。
- 排序公式是
relevance × (1 + log10(max(stars, 10) + 1)) / 2,由代码计算,不能由模型指定。 relevance是调用方的判断,工具不计算也不校验对错;用三维时卡片另起一段列出各维度、borrowability和置信度,?表示未测量。- 没测到的数量不会写成
0:查询词没单独测过显示未知(未测得),归档数量缺失显示数据缺失。 - 仓库里的文字一律当数据引用,README 里的一行没法冒充卡片结构;能作为链接输出的只有
github.com和raw.githubusercontent.com。 - 工具不抛异常:失败会返回
reason和detail,结果不完整时会说明为什么不完整。
缓存与数据去向
- 内存里最多 64 条,5 分钟。
- 磁盘上搜索结果存 24 小时、源码读取存 10 分钟,总量不超过 64 MB,大约每小时清理一次。
- 本地先验文件只保存仓库名、时间、次数、提交/路径元数据和想法 hash,不保存源码或原始想法;最多 256 条记录 / 64 KB,只作为上下文展示,不自动改变排序。
- 都在
$DSH_HOME/cache/dsh-find-ideas/下,删掉这个目录永远安全。 - 搜索查询和仓库路径会发到
api.github.com;inspect_projects和read_repo_files只读取 GitHub 上的仓库内容,不会上传你本地的代码。另一处出口是运行插件的 DSH 所用的模型,只在想法不含拉丁字母、调用方又没给拉丁字母的keywords时,才用来翻译——纯英文的想法不会为了翻译而发给模型。
已知边界
- 排序是启发式,不是推荐系统。 公式把 star 数当权重,star 高的项目天然占优;更贴题但冷门的项目需要你从候选池里自己挑。
- 搜索只覆盖名称、描述和 topics。 GitHub 搜索不索引 README 正文和文件内容,只在 README 里描述自己的项目搜不到,这要靠
inspect_projects补。 - 中文想法没有英文检索词就够不到。 用英文自我描述的项目在中文查询下命中率接近零,所以工具宁可拒绝并说明原因,也不返回一堆无关结果。
inspect_projects是抽样读,不是通读。shallow每个仓库最多 4 个文件,deep最多 8 个;架构视图不会声称完整调用图。- 卡片 24 KB 封顶。 装不下时按「最便宜的损失优先」裁剪(依赖清单 → README → 逐文件摘录 → 声明骨架),并说明扣掉了什么、怎么补读——用
read_repo_files点读,或下次少传几个仓库。
兼容性
需要 Node ≥ 22;兼容 DSH:0.1.0-rc.6+、0.1.1-rc.1+、0.1.2-alpha.2+、0.1.3-alpha.2+、0.1.5-alpha.1+、0.1.6-alpha.1+、0.1.7-alpha.1+、0.2.0-rc.1+、0.2.1-alpha.1~0.2.1-rc.5。
版本
| 版本 | 更新 |
|---|---|
| 0.5.0(当前) | 触发面加宽 + 三档开关。scout_projects 的 description 不再把「说 GitHub」当作触发条件,改为描述情境(用户有了一个想做的想法、哪怕还很模糊),并列出中文场景例句与四条禁搜边界;新增一段 system prompt 引导(order 160),在工具可见时说明何时该搜、何时该忍住、先打招呼再搜;「先打招呼再搜」做成机械硬约束——tools.guard 会在本轮没有任何 assistant 文本时拒绝一次 scout_projects 调用并返回补救说明。新增 mode 参数(brief 默认 / full):速览只给名字和一句话简介、不要求打分,full 才要求调 rank_candidates。新增 autoScout 三档配置(always / ask / off,默认 always)与会话内最多两次自动搜索的机械预算(用户回复后放行一次)。新增触发率评测集 eval:trigger(28 个场景)。 |
| 0.4.1 | 新增可解释 relevance 维度(problem_fit / workflow_fit / technical_fit,0–5,按固定权重派生 0–10 relevance,旧的单 relevance 输入继续兼容);read_repo_files 增加证据锚定的 view="architecture";新增只存元数据的有界本地先验(256 条 / 64 KB),只作上下文、不改变排序。 |
| 0.4.0 | 新增 read_repo_files;inspect_projects 卡片固定封顶 24 KB,并说明超限后的补读路径;四个工具 schema 小 1.7 KB,仓库改为三路并行读,卡片版式只声明一次。AB 实验:工具调用少 44.8%,工具结果载荷少 10.8%,计费输入基本打平。 |
| 0.3.0 | 缓存与包体。简介按 512 字符存储而不是无限长,内存缓存上限 64 条,磁盘缓存会清理过期条目并保持在 64 MB 以内,发布包里不再包含 src/、test/、scripts/ 和 source map——解包 805 KB,原来是 2.07 MB。工具名、参数和输出都没变。 |
| 0.2.1 | 发布到 npm,功能与 0.2.0 相同。 |
| 0.2.0 | 卡片标出每行被几个查询命中、榜上有多少行是归档仓库。 |
| 0.1.0 | 首个可用版本:scout_projects → rank_candidates → inspect_projects 三工具链路。 |
开发
npm install
npm run build         # tsc -> lib/ ;必须先跑,测试 import 的是 lib/
npm test              # node test/run-all.test.mjs
npm run check         # typecheck + build + readme:check
npm run typecheck     # tsc --noEmit
npm run check:peers   # 检查 peer range 是否覆盖当前的 DSH 版本
npm run eval:gate     # 用冻结数据复核实验数字
npm run eval:trigger  # 复核触发率评测集:28 个场景是否都被引导语覆盖
贡献
欢迎 Issue 和 PR!
- 报问题 / 提需求:开 issue,写清你输入的想法、期望的结果和实际结果。
- 改代码:fork → 从
master切分支 → 改代码并补测试 →npm run check && npm test全绿 → 提 pull request。CI 在 Node 22 和 24 上跑的也是这两条命令。 - 一次只做一件事:一个 PR 解决一个问题;提交信息用
feat:/fix:/docs:/chore:等前缀。
许可证
MIT LICENSE。
MIT License © tianyao2003
No comments yet. Be the first to write one.