dsh-hotspot
热点采集 → 去重 → 确定性排序 → 草稿落地。当前只适配 VitePress 博客,同时是一个 DeepSeek Harness 插件。
零运行时依赖,纯 ESM JavaScript(Node ≥ 20.6)。npm test 用内置 node:test,不需要装任何东西。
界面
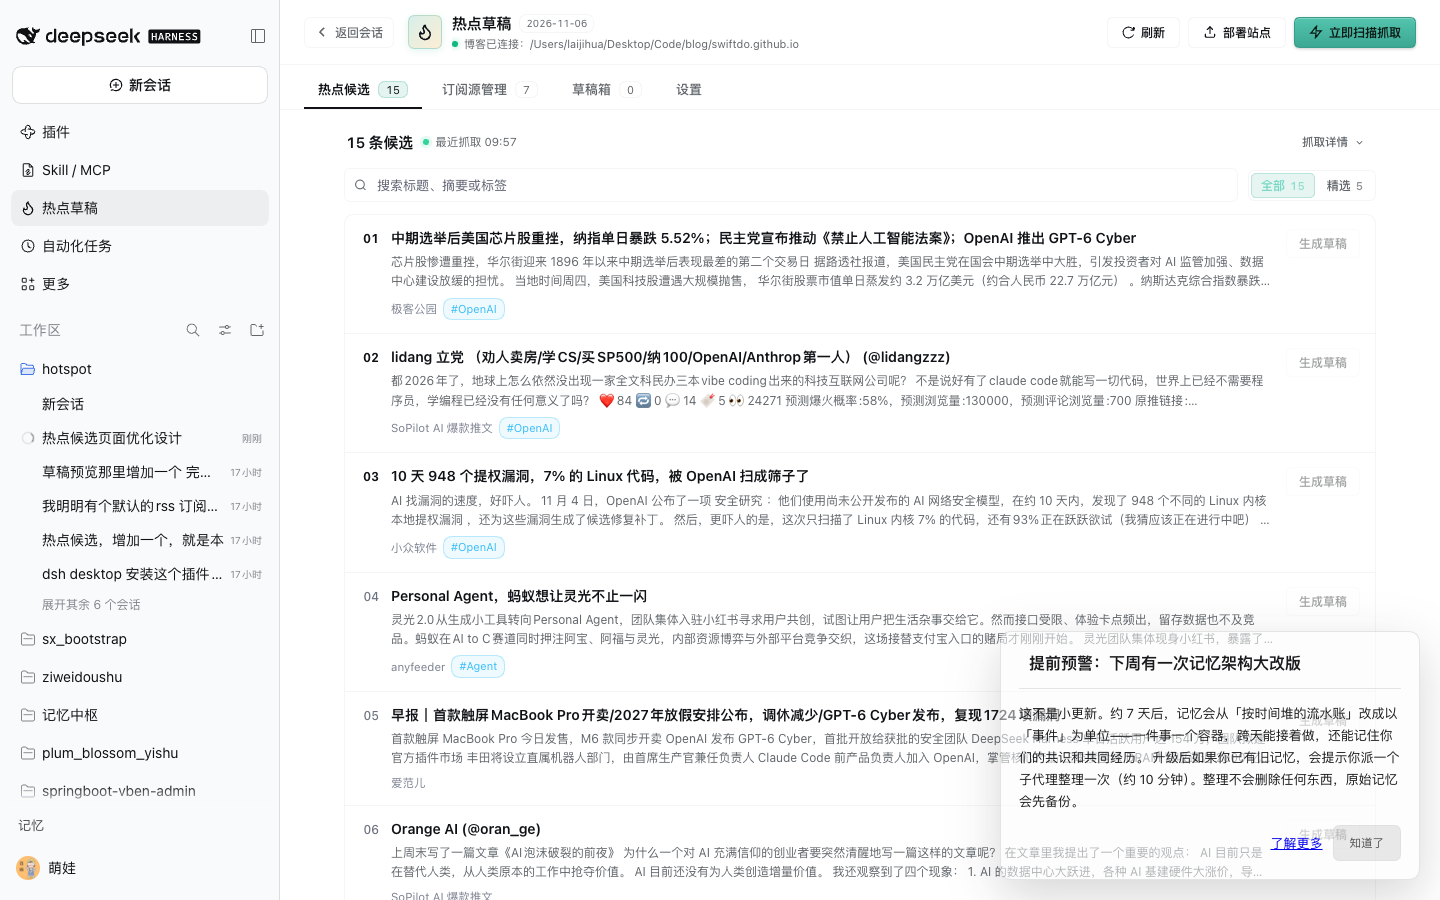
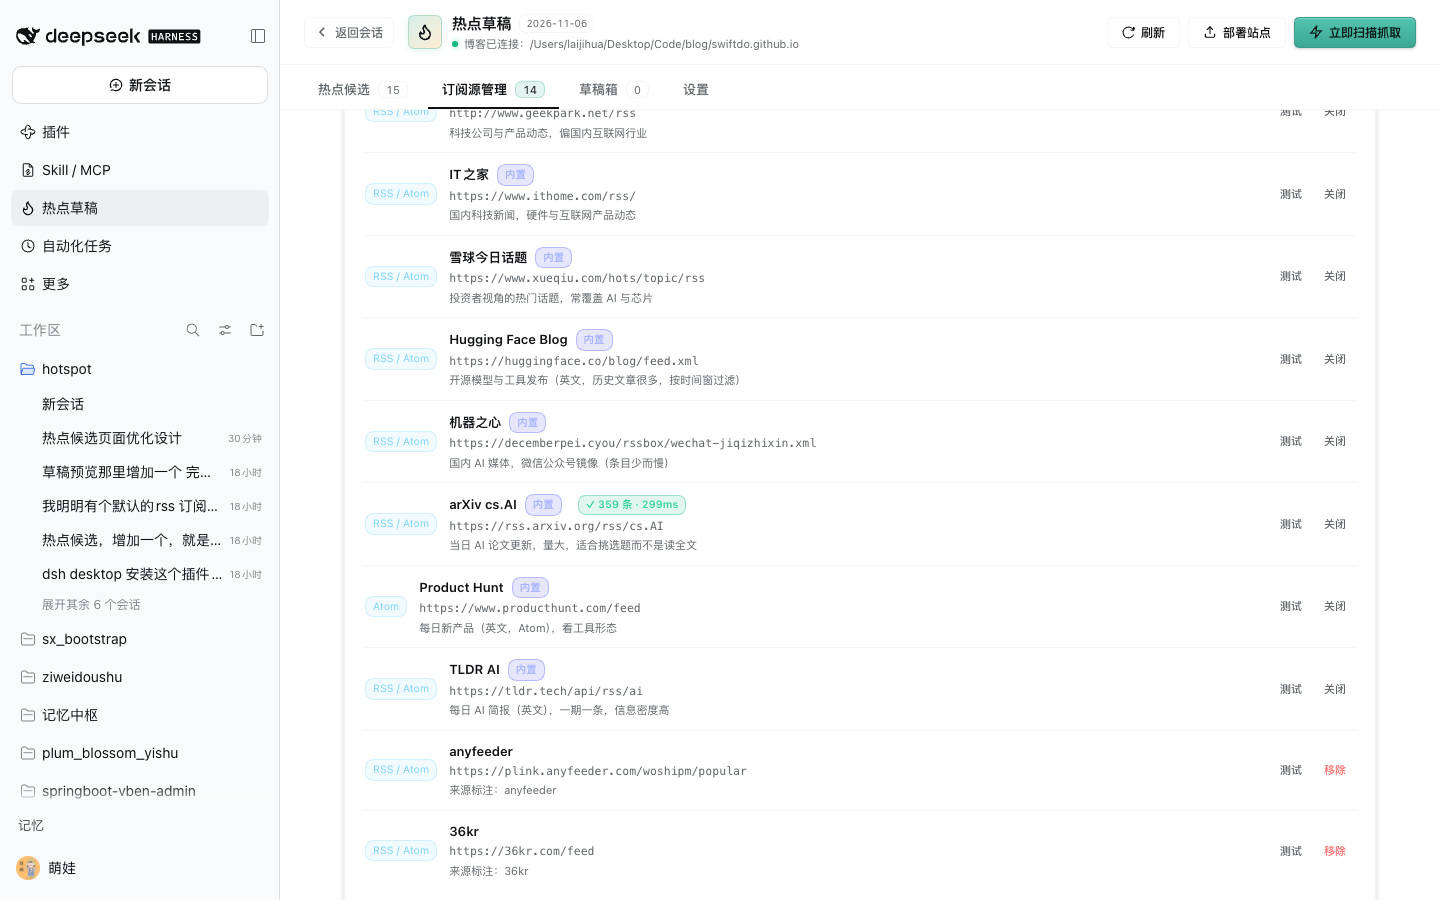
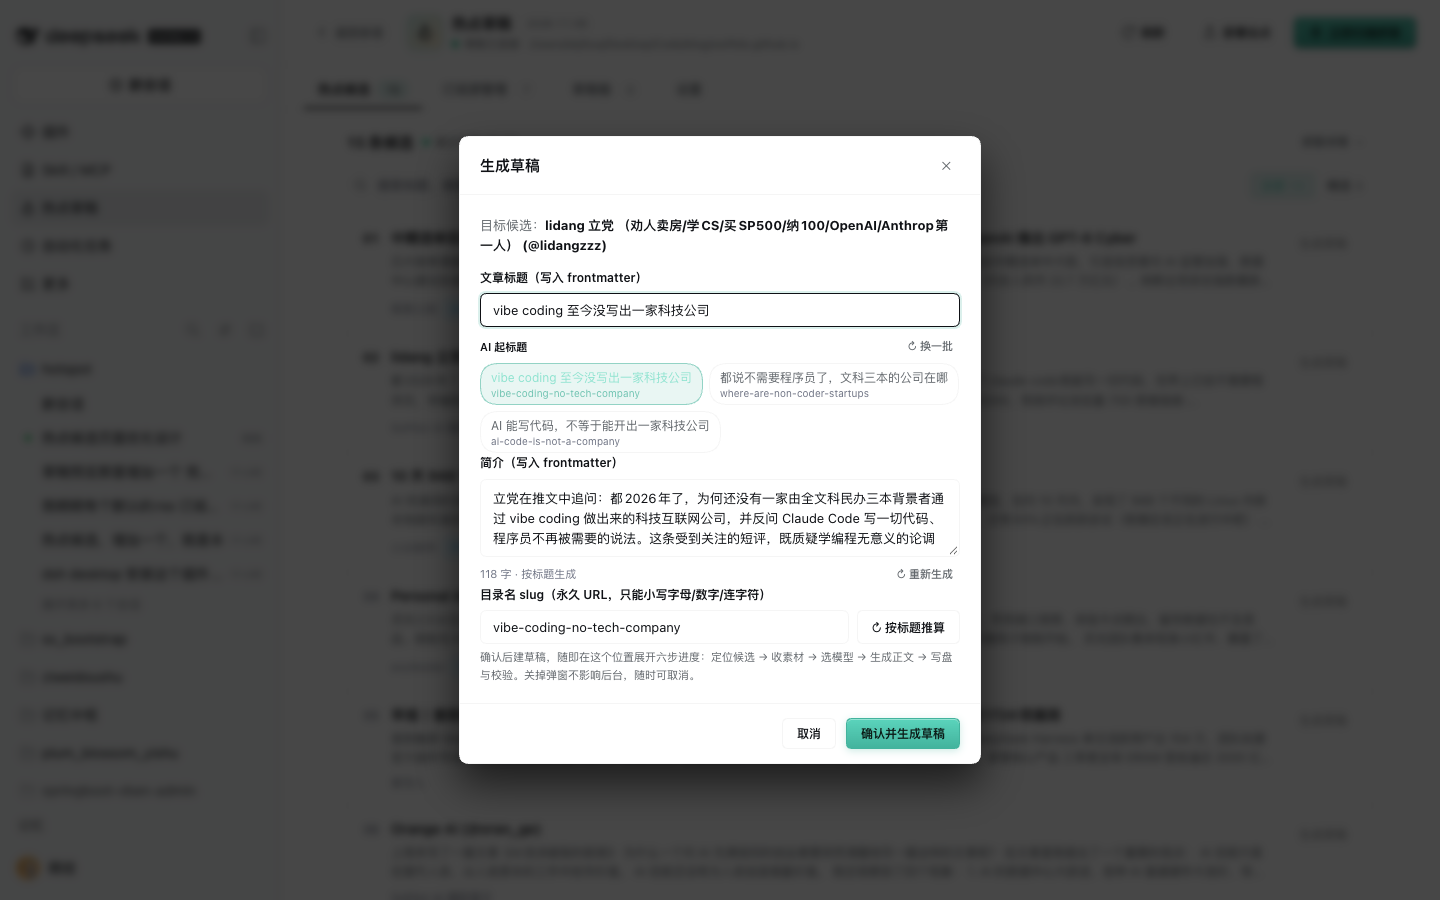
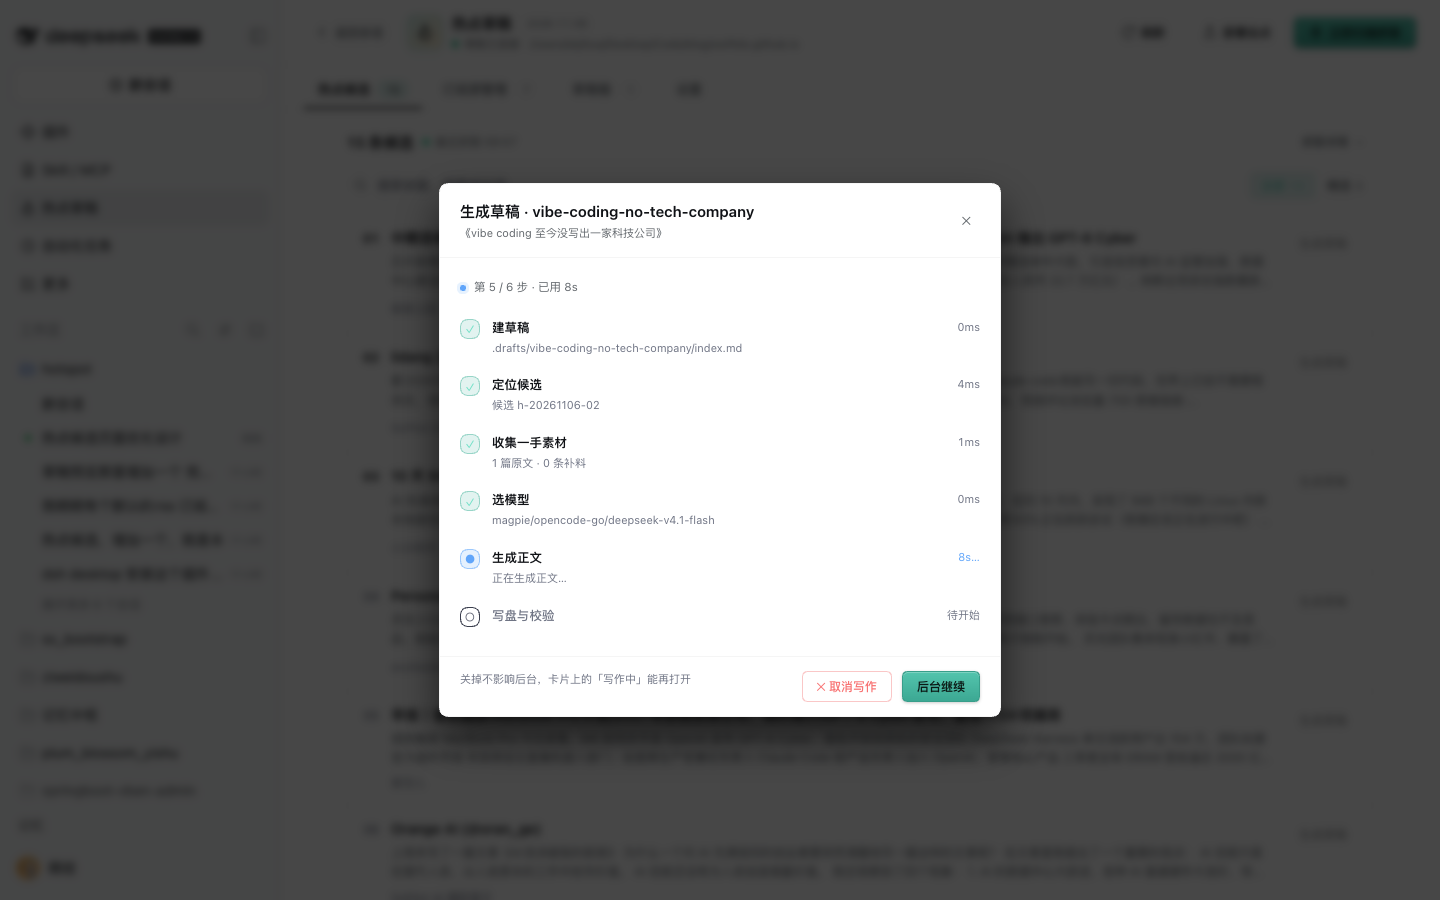
截图来自真实运行(DeepSeek Harness 侧栏里的 dsh-hotspot 面板),不是设计稿。
候选:每天 15 条,跨源共现与新鲜度算分
订阅源:内置源常驻(可关不可删)+ 自定义源,id 自动推导,每行可测连通性
生成草稿:模型起 3 个中文标题,定稿后按标题重写简介
六步链路进度:关掉弹窗任务照跑,回来点卡片上的「写作中」能再看
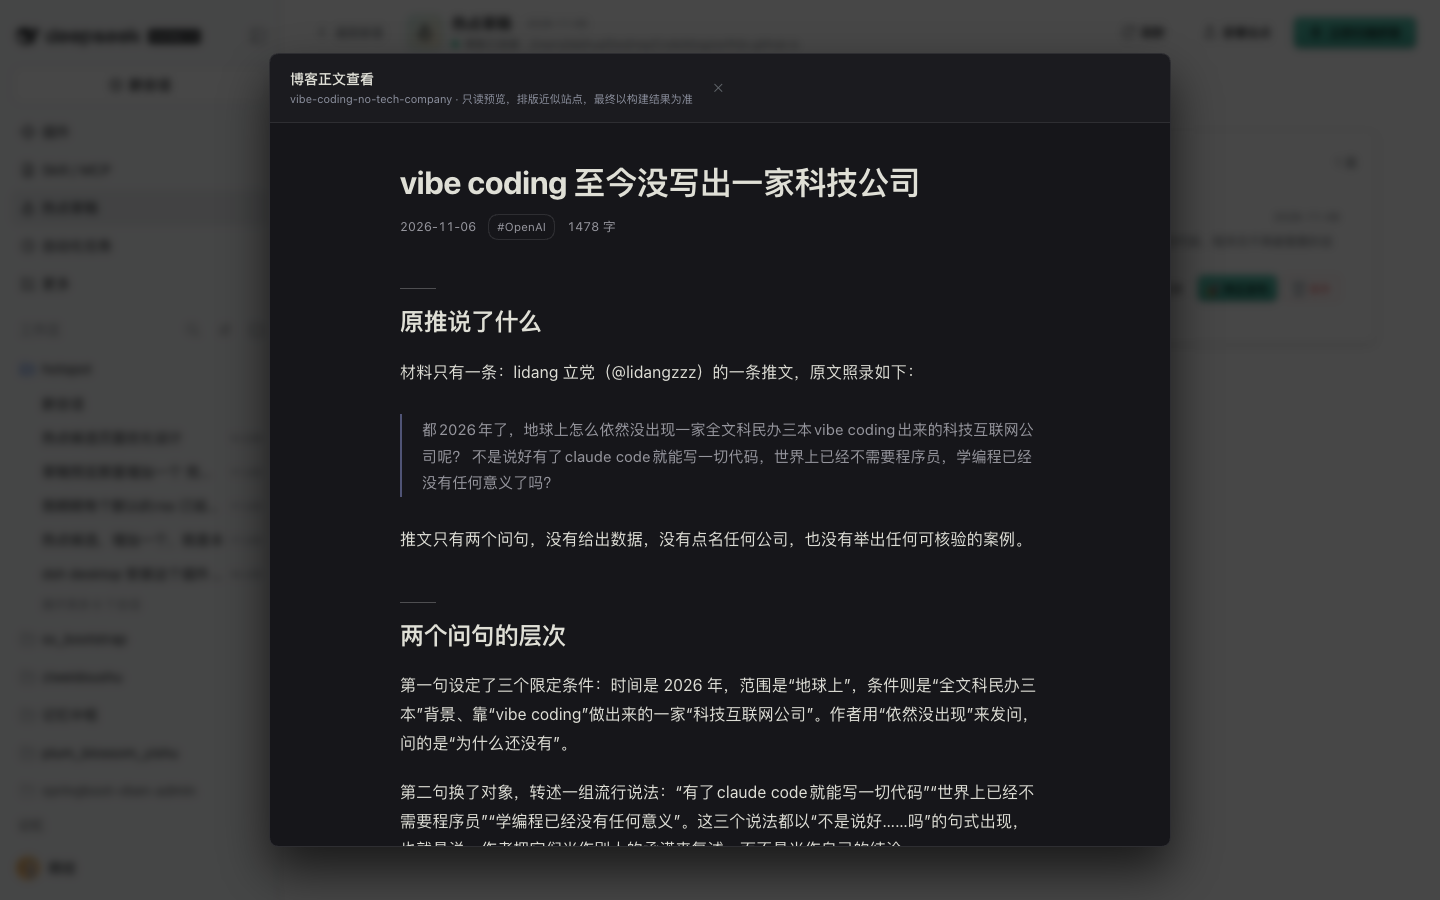
博客正文查看:草稿落在站点目录外,先按站点排版近似预览
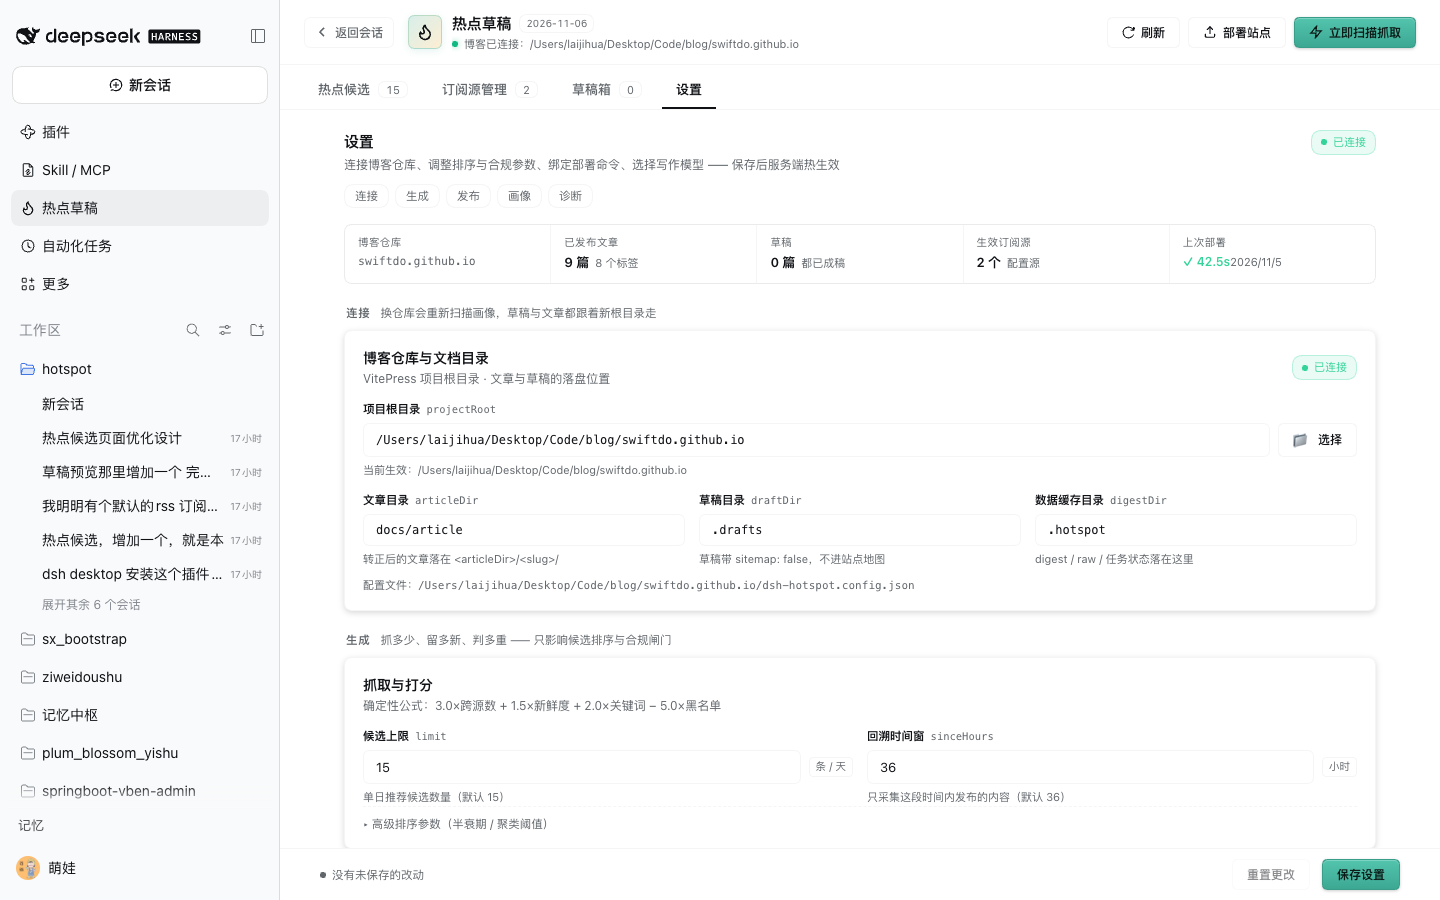
设置:连接 / 生成 / 发布 / 画像 / 诊断,保存后服务端热生效
支持哪些博客
目前只有 VitePress。 其他生成器(Hexo、Hugo、Astro)需要另写一个 Target 适配器——core 不用改,但适配器现在还不存在,target.kind 只认 vitepress。
"支持 VitePress" 具体意味着这些约定:
| 约定 | 说明 | 可改 |
|---|---|---|
文章是 <目录>/<slug>/index.md 或 <目录>/<slug>.md |
两种布局都能扫到 | — |
| 已发布文章目录 | 默认 docs/article |
target.articleDir |
| 草稿目录 | 默认 .drafts(站点目录之外) |
target.draftDir |
| frontmatter 字段 | title / description / createTime / date / tags,不写 permalink |
— |
| 草稿不进站点地图 | 草稿在站点外时不需要;在 docs/ 内才写 sitemap: false,promote 时删掉 |
— |
| tag 词表 | 从存量文章归纳,同一 tag 的多种写法按小写归并 | — |
init 时项目里要有 docs/ |
没有就判定"这不是一个 VitePress 项目" | — |
docs/ 之下怎么分层随你:文章直接在 docs/ 一级就把 articleDir 设成 docs,放 docs/posts/ 就设成 docs/posts。草稿目录同理。
草稿默认放在 docs/ 外面(.drafts/),这是有意的:VitePress 只构建 srcDir,站点目录之外的 Markdown 根本进不了产物,也就不需要任何博客侧配合。把草稿放在 docs/ 里会有三个麻烦——它们照样被构建成页面、只靠 sitemap: false 从站点地图里剔除、而那个字段能不能生效取决于你博客侧的插件。hotspot doctor 在检测到草稿目录落在站点内时会给出警告。
只有草稿确实配置在 docs/ 内时,scaffold 才会写 sitemap: false(那种布局只能靠博客侧解释这个字段来兜底)。转正时无论有没有这个字段都会删掉。
为什么不用模型打分
排序是确定性的算术:
score = 3.0 × log2(1 + 跨源数)
      + 1.5 × 新鲜度(0..1, 半衰期 24h)
      + 2.0 × 关键词命中(权重和, 封顶 1)
      - 5.0 × 黑名单命中
理由有三条,都不是"省钱":
- 可复现。同一批数据跑两次结果一致,你能判断候选质量下降是源变差了还是算法抖了。
- 可解释。每一条的分都拆进
scoreParts,digest 里能直接算给人看。 - 不引入新的故障模式。模型排序会编造来源、抬高评分、把转载当首发;那些只能靠"候选集 URL 白名单"打补丁,而补丁本身就是新的耦合。
whyNow / angle 这类判断留给"你拍板之后"——那时 agent 在会话里有完整上下文,比流水线里盲猜一遍准得多。
架构:端口与适配器
core 只认五个接口,不知道自己跑在 DSH 还是 CLI 里:
| 端口 | 职责 | 适配器 |
|---|---|---|
Source |
拉取条目 | rss / atom / github-release / hn |
Ranker |
排序 | 确定性公式 |
Store |
落盘 digest 与原文 | 文件系统 / 宿主 storage |
Clock |
当前时间 | 系统时钟 / 冻结时间(测试) |
Target |
项目知识与草稿落地 | VitePress / (可扩展 hexo、plain、outbox) |
src/core/ 里不出现 ctx、不出现 article、不出现 sitemap——那些词只准出现在 src/adapters/target-vitepress.js。
处理流程
整条链路是三段:采集是批处理,写作是会话里按需触发,校验是发布前的硬闸门。三段之间只通过磁盘上的文件交接(digest、raw、index.md、sources.json),没有常驻进程、没有内存状态依赖——所以任何一步都可以隔天重跑。
1 采集:一次 run 里发生什么
flowchart LR
  A["配置里的 sources"] --> B["并发抓取<br/>rss / atom / github-release / hn"]
  B -->|"单源失败只记录,不中断"| C["同源去重<br/>source + canonicalUrl"]
  C --> D["聚类<br/>titleKey 字符 bigram<br/>Jaccard ≥ 0.6 且 72h 内"]
  D --> E["打分<br/>3·log2(1+源数) + 1.5·新鲜度<br/>+ 2·关键词命中 − 5·黑名单"]
  E --> F["digest(瘦)<br/>.hotspot/digest/YYYY-MM-DD.json"]
  B --> G["原文(全)<br/>.hotspot/raw/YYYY-MM-DD.json"]
  F --> H["候选表"]
  G -.->|"check 的数字比对读这里"| I["一手源全文"]
  H --> I
三个关键性质:
- 单源失败不拖垮整体。失败的源名进
status.failedSources,成功源不足一半时degraded: true,候选表顶部会标「严重降级」。 - 只压同源内部的重复,绝不按 URL 全局去重。两个源订阅同一个 URL 时会被吞掉一条,而「跨源共现」正是排序里最强的信号(
3.0 × log2(1 + 源数))——吞掉就等于把这个信号永久归零。跨源合并是聚类那一步的职责。 - digest 瘦、raw 全。digest 只留标题、URL、分数与来源列表;raw 存每个源的完整正文,专门给
check做数字比对用。
2 写作:一次成稿的调用顺序
sequenceDiagram
  autonumber
  participant U as 会话(你或 agent)
  participant T as 插件工具
  participant B as 博客仓库

  U->>T: hotspot_run
  T->>B: 写 digest + raw
  T-->>U: 候选表

  U->>T: hotspot_get 3(registerSlug=my-post)
  T->>B: 读 digest/raw,写 .drafts/my-post/sources.json
  T-->>U: 多源原文(核对版本号、日期)

  Note over U: 联网搜官方 release notes / issue,综合后写正文,再去 AI 味

  U->>T: hotspot_supplement(边搜边登记,可多次)
  T->>B: sources.json 追加一条(正文 ≤ 4000 字)

  U->>T: hotspot_scaffold 3(slug=my-post,body=写好的正文)
  T->>B: 写 .drafts/my-post/index.md + sources.json(记下 candidate.id)

  U->>T: hotspot_check my-post(改稿走 hotspot_write,写完自动复核)
  T->>B: 读正文 + 一手源 + 补料
  T-->>U: 三道检查 + frontmatter 结果,违规逐条列出

  U->>T: hotspot_promote my-post
  T->>B: 再过一次闸门 → 搬到 docs/article/,sources.json 一起搬
CLI 里对应 hotspot check / hotspot promote,面板里对应「转正」按钮 —— 三处走的是同一段 src/core/promote.js。
每步落在磁盘上的东西,决定了下一步能看到什么:
| 步骤 | 写入 | 为什么必须落盘 |
|---|---|---|
run |
.hotspot/digest/*.json、.hotspot/raw/*.json |
check 要拿一手源原文比数字 |
get --registerSlug |
<draftDir>/<slug>/sources.json |
digest 按天滚动,隔天 latest 里已无该 cluster,来源会丢 |
scaffold |
<draftDir>/<slug>/index.md、sources.json 的 candidate |
frontmatter 由程序生成;传 body 时正文一起落盘;candidate.id 是 check 定位证据的唯一依据 |
write |
同一个 index.md(保留 frontmatter) |
改稿是迭代的:scaffold 只能建一次,改正文走 hotspot_write |
supplement |
同一个 sources.json |
补料是证据账本,不是笔记 |
promote |
<articleDir>/<slug>/{index.md,sources.json} |
转正后仍要答得出「这段数字从哪读来的」 |
面板的「生成正文」是同一套落盘的另一种触发:一次 completion 直接返回 Markdown,宿主写进草稿并跑校验(见「面板里一键生成成稿」)。
3 校验:四道闸门
flowchart TD
  A["文章 markdown"] --> B["数字字面比对"]
  B -->|"不在证据边界内"| X1["number-not-in-source"]
  B --> C["站内链接集合"]
  C -->|"目标页不存在"| X2["internal-link-missing"]
  C --> D["外链白名单"]
  D -->|"域名未登记"| X3["external-link-untrusted"]
  D --> E["frontmatter 规则"]
  E -->|"缺字段 / 超长 / permalink / 日期 / tag"| X4["fm-title · fm-description · fm-description-length<br/>fm-permalink · fm-date · fm-tag-uncontrolled"]
  E -->|"全过"| P["promote → 文章目录"]
  P --> Q["publish(可选的五步)"]
  X1 --> R["登记补料,或改稿"]
  X2 --> R
  X3 --> R
  X4 --> R
  R --> A
「证据边界」是三层叠加的:候选源原文(digest + raw)、已登记的补料(sources.json)、配置里的 publish.allowedHosts。闸门不会因为 --allow 变松——它只会因为「你真的读过」而变宽。
有三件事是这版才硬起来的:
promote必须过闸。CLI、面板「转正」、hotspot_promote三处都走src/core/promote.js,违规就拒绝,草稿留在草稿目录。没有 force 开关。- 候选定位不再靠猜。
scaffold把candidate.id写进sources.json;check按 id 在最近 14 天的 digest 里找回它当时所在的那份,证据取自那一天的 raw。定位不到就判candidate-unresolved—— 以前会退化成「当天全部原文都是证据」,等于没有数字闸门。 - 中文标题不再漏闸。老实现靠
slugHint或标题反查候选,中文标题两条都匹配不上,于是走了上面那条宽松路径。现在有candidate.id就不再依赖标题。
快速开始
在你的博客仓库根目录下跑(--root 就是博客项目路径,不是本仓库):
node src/cli.js init --root <你的博客目录>   # 生成配置文件,并从存量文章归纳 tag 词表
# 编辑配置里的 sources,换成你关心的源
node src/cli.js run --dry-run                # 只看不落盘
node src/cli.js run                          # 落 .hotspot/digest/YYYY-MM-DD.{json,md}
node src/cli.js scaffold '#3' --body-file post.md  # 一次成型:正文随草稿落盘(省略 --body-file 只写骨架)
node src/cli.js supplement <slug> --url <页面> --file <正文>  # 联网补到的证据,登记后 check 才认
node src/cli.js check <slug>                 # 三道机械校验
node src/cli.js promote <slug>               # 过闸后转到文章目录,去掉 sitemap:false(违规就拒绝)
node src/cli.js publish <slug> --yes         # 校验 → 构建 → 只提交这一篇 → 推送 → 部署
node src/cli.js doctor --online              # 自检:配置 / 目标项目 / 每个源 / DSH 安装状态
init 写出的 sources 只是示例,务必换成你自己领域的源——跨源共现信号要多个源覆盖同一领域才有意义(见「已知限制」)。
内置源常驻、默认全开,与 sources 里的自定义源叠加(内置在前)。内置源可以关闭,但不能删除、不能改地址——关闭记在配置的 disabledBuiltins: ["ifanr"] 里,只记「关掉的」,所以升级新增内置源时你不用补任何配置。这条判定由 src/core/sources.js 的 resolveSources() 统一给出,面板的「订阅源清单」和 hotspot_run 读的是同一个结果——面板显示的生效源一定就是实际被抓的源。
| 内置源 | 地址 | 说明 |
|---|---|---|
sopilot-hottweets |
https://sopilot.net/rss/hottweets |
SoPilot AI 爆款推文 |
appinn |
https://www.appinn.com/feed/ |
小众软件 |
people-headlines |
https://plink.anyfeeder.com/people |
人民网头条(anyfeeder 镜像) |
ifanr |
https://www.ifanr.com/feed |
爱范儿 |
geekpark |
http://www.geekpark.net/rss |
极客公园 |
ithome |
https://www.ithome.com/rss/ |
IT之家 |
xueqiu-hot |
https://www.xueqiu.com/hots/topic/rss |
雪球今日话题 |
huggingface-blog |
https://huggingface.co/blog/feed.xml |
Hugging Face Blog(英文) |
jiqizhixin |
https://decemberpei.cyou/rssbox/wechat-jiqizhixin.xml |
机器之心(微信公众号镜像) |
arxiv-cs-ai |
https://rss.arxiv.org/rss/cs.AI |
arXiv cs.AI(当日论文) |
producthunt |
https://www.producthunt.com/feed |
Product Hunt(Atom,英文) |
tldr-ai |
https://tldr.tech/api/rss/ai |
TLDR AI 每日简报(英文) |
36氪(
https://36kr.com/feed)没进内置池:直连返回的是火山引擎的人机校验页(HTML),服务端拿不到 RSS,anyfeeder 的36kr镜像同样是 HTML。放进来的话每次扫描都会多一条「抓取失败」。量大不等于候选多。arXiv cs.AI 一天三百多条、Hugging Face 的历史文章近九百条,它们都会进当天 raw(
sinceHours只挡超过时间窗的),但候选仍按rank.limit(默认 15)截断 —— 这些源的用处是「选题面宽」,不是「候选变多」。想压掉噪音就把它们的keywords/ 黑名单调严,或者直接在面板里关掉。
自定义源不用填 id:面板会从域名推导(www.ifanr.com/feed → ifanr、plink.anyfeeder.com/people → anyfeeder-people、GitHub Release apple/swift → apple-swift、HN → hn),撞上已有 id 自动加 -2。id 只用于「来源:xxx」标注,推导结果在表单里只读展示。
添加前必须先测通:点「测试」就地抓一次,行内显示 ✓ 12 条 · 380ms 或失败原因,不入库、不改配置。
- 判定「通」= HTTP 能取到且能解析成 feed,窗口内 0 条也算通(冷门源可能一天都不更新,拿条数当门槛会误杀);
- 没测过 → 添加按钮不可点,提示「先点测试」;改任何一个字段都会让上一次的通过失效(
forKey是测试时的表单快照); - 测不通 → 按钮变成「仍然添加」,点了会展开一条二次确认(带失败原因),确认后才写进配置 —— 临时超时和真挂了在面板上分不出来,硬拦会让人卡在一个其实能用的源上。
怎么确认它真的可用
分三层,从便宜到贵。下层不过就别看上层,否则会把"配置错"误判成"插件坏了"。
| 层 | 命令 / 动作 | 通过的标准 |
|---|---|---|
| 1 项目侧 | hotspot doctor --online |
没有 ✗;源能连通、能扫到文章、tag 词表非空 |
| 2 打包侧 | dsh --profile <名字> --dump-config | grep -A6 hotspot |
配置树里出现 - id: hotspot,config 正确 |
| 3 运行时 | 启动后在 App 里打开 <地址>/dsh-hotspot/ |
页面能开、/api/state 有数据、会话里能调 hotspot_run |
第 2、3 层依赖 DSH 装好并重启。第 3 层是最关键的一层,因为前两层都可能"看起来正常但实际没生效"——踩过的两个坑(output.render 返回裸字符串、output.schema 写了 required)都属于这种静默失败。判断办法:cordis.patch.yml 里把 verbose 设成 true,启动日志应出现
[dsh-hotspot] dsh-hotspot: 插件已加载,projectRoot=/path/to/blog
[dsh-hotspot] tools 服务就绪=true
[dsh-hotspot] 已注册 7 个工具:hotspot_run / hotspot_get / hotspot_scaffold / hotspot_supplement / hotspot_check / hotspot_promote / hotspot_write
[dsh-hotspot] 已注册 N 条路由,管理页 /dsh-hotspot/
四行缺哪一行,问题就在哪一层:第一行缺失 = 模块没被加载(看 did not activate 列表);第二行 false = tools 服务没起来;第三行缺失 = 注册抛异常了(异常被 Cordis 吞掉,插件里的 try/catch 会打出来);第四行缺失 = webServer 没就绪。
写正文:先补料,再去 AI 味
骨架是确定性生成的,正文不是。正文要有信息量,就得离开候选源去查官方 release notes、作者博客、issue/PR——那些页面里的版本号和日期,一手源里没有,check 会把它们判成编造。
补料(supplement)是这条缝的解法:把"实际读过什么"登记成证据,让闸门知道证据边界在扩,而不是用 --allow 把闸门关掉。
node src/cli.js supplement <slug> --url <页面> --file <本地正文> --kind official
node src/cli.js supplement <slug> --list     # 看已登记的补料
登记后 check 做三件事:补料原文并入数字比对、补料 URL 与域名并入外链白名单、配置里的 publish.allowedHosts 继续生效。文件落在 <draftDir>/<slug>/sources.json,promote 时一起搬到文章目录——转正之后仍答得出"这段数字是从哪读来的"。
草稿要一次成型:写完、去完 AI 味,再用 scaffold --body-file 把正文一起落盘,草稿目录里不会出现「(正文待写)」。
node src/cli.js scaffold '#3' --slug my-post --title '中文标题' --body-file post.md
# 落盘即校验:违规直接列出来,草稿保留,改完重跑 hotspot check
--title / --description 覆盖 frontmatter(正文是中文时基本都要传,否则会沿用英文 RSS 标题)。正文自带 # 标题 就原样使用,没有才自动补一个。
顺序是硬的:写 → 去 AI 味 → check。去味会改数字写法(6.1.2 → v6.1.2)和删链接,先 check 等于白跑一遍。
DSH 里对应 hotspot_supplement 工具:边搜边登记,别等 check 报错再回头补。
两处配套,省掉手工登记:
hotspot_get带registerSlug:把该候选的多源原文一次性登记成补料,并把candidate.id记进sources.json。digest 按天滚动,隔天再写这篇草稿时latest里已经没有这个 cluster——写之前先固化一份,check 才能按 id 找回当时的证据。- 面板里的证据条:打开草稿/文章的「预览与修改」后,正文上方有一条
📎 证据 N 条,展开可看每条补料的标题、类型、字数与正文摘要。转正后这条也还在,因为 sources.json 跟着一起搬走了。
面板里一键生成成稿
候选页点「生成草稿」会先弹一个小窗确认标题与目录名(标题预填候选标题、目录名预填 slugHint,没有就按标题推算、纯中文标题退到 hotspot-MMDD-NN)。目录名是永久 URL,改起来比看一眼贵;而且纯中文标题推导不出 ASCII slug —— 以前这一步直接 500。
确认后就是一次成稿,不再是空骨架:
POST /api/scaffold {id, slug, title, generate:true}
  ├─ 建草稿(frontmatter + sources.json 里的 candidate.id)→ 立刻返回 job
  └─ 后台任务:候选素材包(摘要 + tags + 一手源原文 + 已登记补料)
                → 一次 completion → 写盘 → 三道校验
面板每 4 秒 GET /api/jobs?slug=…  → 卡片上「✍️ 写作中」→ 完成变标题,失败变「⚠️ 正文失败」+ 重试
写作中可随时取消:POST /api/jobs/cancel  → 信号一路传到模型请求,真停(已写盘的内容不回滚)
草稿卡片上直接能看到状态:✍️ 写作中(带「✕ 取消写作」)、⚠️ 正文失败(带「🔁 重试写正文」)、⚠️ 校验未过 N(写完但闸门没过,鼠标悬停看违规清单)、正文待写 与 1234 字。
为什么是后台任务:一次 completion 几秒到几分钟,同步等会有两个问题——浏览器刷新就丢结果,面板也只能干等。任务状态落在 <digestDir>/jobs/<slug>.json,宿主重启后仍能看出上次失败的原因(但不会自动续跑)。
草稿已经建好后仍可以单独重跑:草稿箱卡片上的「🔁 重试写正文」打 POST /api/jobs,编辑器里的「✨ 生成正文」打 POST /api/generate(同步)。同一篇同时只允许一个任务,重复请求回 409 ERR_JOB_BUSY。
模型拿到的就是磁盘上已有的材料,写完按同样的规矩落盘:
一次 completion(system:只用给定材料写作,不编造事实)
  └─ 提示词 = 选题 + 摘要 + tags + 一手源原文节选 + 已登记补料
        └─ 返回 Markdown → 去掉自带 H1 → 写进草稿(保留 frontmatter)→ 立刻跑三道校验
为什么不用子代理:那条路要在 HTTP 路由里伪造一个「活着的父代理」才能被宿主接纳(startActivation 要求 request.parent 与注册表里的是同一个对象引用),宿主版本一变就断——我们已经在这上面摔过两次(parent 缺失、方法未绑定 this)。它唯一多出来的是「联网搜几篇」,现在由「生成前补齐补料」替代:材料不够就先 hotspot_supplement,闸门与落盘完全不变。
入口都收在草稿箱里:卡片整块可点,和「✏️ 编辑正文」进的是同一个编辑器。正文还是空壳时,预览区给出一张「✨ 生成正文」卡片,打 POST /api/generate;正文写完以后,编辑器头部的「🎨 正文润色」会展开润色面板,填不填要求都能跑,打 POST /api/polish。两种操作完都重新读回磁盘内容并刷新证据条,不用关掉重开。
喂给模型的不只是标题。写正文前会按 sources.json 的 candidate.id 找回候选,连同当天 raw 里的一手源原文组成素材包(摘要、tags、每条最多 2000 字、总量 6000 字)。以前只给标题和一串链接,中文标题还会直接定位不到候选——提示词里连选题是什么都没有。
润色和写正文是两条路:
写正文  POST /api/generate  一次 completion(素材包)→ 写盘 → 校验
润色    POST /api/polish    一次 completion(正文 + 你的要求)→ 清洗产物 → 写盘 → 校验
润色面板里的要求是自由文本,也可以点预设(去 AI 味 / 更口语 / 精简七成 / 每节加例子 / 先结论后解释 / 只修语病)往里追加。润色可以反复做:每次都以磁盘上的最新正文为底稿,改完要求再润一遍即可。
润色的硬边界写在提示词里:只改表达,不改事实;数字、版本号、日期、百分比、引语、人名、公司、职位、链接原样保留;不许新增原文没有的信息,也不许把「据报道」改成肯定句;小标题层级与「## 参考」里的链接一条不少。落盘前还会把润色前后的数字与链接抽出来比一遍,缺了或多了不拦截,但会在面板上点名(例如「少了 1 个数字(如 42)」),让人自己决定要不要留。
一个例外:正文为空时没有可润色的东西,润色面板会直接提示并给出「先生成正文」的入口。
几处刻意的设计:
- 写盘和闸门不在模型手里。模型只返回 Markdown,写正文、跑校验都是确定性的宿主代码——模型再能编,也进不了「已校验通过」。
- 来源原文一起交回来。产物里的
sources[].content会进sources.json,数字闸门才认得出正文里的版本号;没带原文的来源只记一条「没有原文,数字无法比对」,不当作证据。 - 不联网。写正文只用磁盘上的材料,所以「材料够不够」变成看得见的事:不够就先登记补料。联网找来源留给人在会话里做(或 agent 用
hotspot_supplement登记)。 - 慢是正常的。一次几秒到几分钟,按钮期间禁用;默认 8 分钟超时,超时抛错不写草稿。
- 没接 llm 就明说。宿主没提供
llm服务时接口回 501,面板提示「当前环境没有接入 llm 服务」,不会假装写成。
产物落在 <digestDir>/writer/<slug>.json,跟 digest 同生命周期,方便事后查「这次是谁、读了什么、写了多少字」。
写作方式与模型选择
设置页有一张「模型与写作方式」卡,三行选择 + 两个方式按钮:
默认       —— 没被覆盖的用途都用它
写正文     —— 默认「跟随默认」;材料多、要长上下文时挑大模型
润色       —— 默认「跟随默认」;短任务,可以挑更便宜更快的模型
存盘结构 <digestDir>/writer-config.json:
{
  "version": 2,
  "mode": "agent",
  "global": { "provider": "", "model": "" },
  "writer": { "provider": "", "model": "" },
  "polish": { "provider": "", "model": "" }
}
覆盖项必须成对出现(provider + model 都给),只给一半等于没选;清空即回到跟随默认。旧版扁平的 { provider, model, mode } 读进来当成 global,行为不变。
接口:
GET  /dsh-hotspot/api/models   # 模型目录 + 完整选择 + writer/polish 各自解析到的路由
POST /dsh-hotspot/api/models   # 局部更新:{"mode"?, "global"?, "writer"?, "polish"?}
面板选的模型是真的会生效的:写正文与润色各自解析成一条路由,直接作为 llm.stream({ provider, model }) 的参数;解析不到就明确报「没有可用的模型路由」,不会悄悄用别的模型跑一遍。
证据只有一处来源:提示词里的材料就是 digest 的候选源原文 + 已登记的补料(sources.json)。模型看不到别的,所以它不会「顺手搜到一段网上没有出处的话」——材料不够时它会写「尚未披露」,而不是编。
落盘与闸门固定一条路:writeBody + checkDraft,没有「模型直接写进文章目录」的通道。
模型目录的读取是容忍式的:宿主的 listProviders() / listModels() 返回形状随适配器版本变化(provider/route/id、model/id/name),拿不到路由的条目直接不显示——宁少一个选项,也不给一条会在生成时才炸的假路由。
错误日志
出错时只有一条 toast,刷新就没了;写作任务失败也只留在 jobs/<slug>.json 里。所以插件把错误记到 <digestDir>/errors/YYYY-MM-DD.jsonl(一行一条 JSON):
{ "at": "...", "source": "writer", "code": "", "message": "模型没有返回正文", "slug": "demo", "detail": "..." }
- 默认只留当天(
log.keepDays默认 1):写入时顺手删掉超期的文件。错误日志的价值随时间掉得很快,留久了只是占磁盘,而清理又常被忘掉。 - 记哪些:抓取失败、生成草稿与重写正文的每一次失败、写作任务失败、润色失败、工具与路由注册失败、CLI 命令失败。不记每次请求——一旦变成访问流水就没人看了。
- 失败带上来源与 code:
scaffold(目录名推导不出、slug 非法、标题为空、已经写过)、writer(后台任务失败)、writer-sync(同步生成 / 重试没起来,含并发 409)、scan、polish、tools、routes、cli:<命令>。面板「诊断」里一眼能看出是哪条流程。 - 怎么清:面板「设置 → 诊断」里有「刷新 / 清空日志」,或者
DELETE /dsh-hotspot/api/errors;POST { "date": "2026-11-04" }只清那一天。 - CLI 也记:
hotspot命令失败时用同步写入落一条(process.exit等不及 Promise)。 - 写日志失败不影响主流程:它只是诊断设施,出问题只会打一行 console。
三道机械校验
发布前必须全过,否则文章只能留在草稿目录:
| 检查 | 拦什么 | 实现 |
|---|---|---|
| 数字字面比对 | 把 24.9 写成 24.10、把版本号记错 |
文章里的 \d+(\.\d+)+ 必须出现在一手源或已登记的补料原文里 |
| 站内链接集合 | 死链 | 扫站点 docs/ 下所有含 index.md 的目录建 URL 集合(外加 docs/public/*.html),逐个命中 |
| 外链白名单 | 编造来源 | 必须来自候选源、已登记的补料域名,或配置里登记的域名 |
外加 frontmatter 规则:description ≤ 120 字、不写 permalink、date 格式、tag 必须来自受控词表(词表从存量文章归纳,同一 tag 的多种写法按小写归并)。
一手源原文单独存 .hotspot/raw/<date>.json,不放进 digest——digest 要瘦,数字校验要全。
自动发布:三档,默认只开第一档
| 档位 | 产物 | 判定 |
|---|---|---|
auto |
直接进文章目录 | 一手 release 类,白名单源,版本号跨源一致 |
draft |
草稿目录(默认 .drafts/,在站点外) |
默认档 |
manual |
只进 digest | 传闻、冲突、黑名单命中 |
publish.autoTiers 默认为空数组。要开自动直发就往里加源类型,不要改代码。
publish 会执行什么
publish 只做五步,且只 git add 这一篇的目录:
# 1. 构建(可选):配置里的 deploy.build
yarn build
# 2-4. 只 add 这一篇 → 提交 → 推送
git add <articleDir>/<slug>
git commit -m "post(auto): <slug>"
git push origin HEAD
# 5. 部署:配置里的 deploy.script
./deploy.sh --no-git --skip-build
构建与部署两条命令都从配置读(deploy.build / deploy.script),和面板「部署站点」用的是同一份配置。没配 deploy.script 时 publish 直接失败并提示去配置,不再有写死的默认流水线。
不用 git add -A 是有意的:自动发布时工作区通常有你的半成品,一个 add -A 就把它们全提交并发上线了。
deploy.build 留空就跳过构建,只跑 deploy.script——如果你的 deploy.sh 自己会构建(很多站点脚本都是这样),这样配就不会重复构建一遍。
面板里的「部署站点」按钮(可配置)
控制面板与插件页头各有一个「部署站点」按钮,它执行的命令由配置决定,不写死在代码里:
{
  "deploy": {
    "build": "yarn build",
    "script": "./deploy.sh --skip-build"
  }
}
- 配置写在博客仓库里:保存时写入
<projectRoot>/dsh-hotspot.config.json(该仓库若已有hotspot.config.json会同步一份),配置卡片底部显示实际路径;改绑根目录后写到新根,不再写回旧目录。服务端代码更新后需重启 DSH 宿主才生效——运行中的进程不会热加载插件模块。 deploy.build可选,deploy.script必填;面板按 build → script 顺序执行,任一步失败即停,不会带着构建失败的旧产物去上线。- 用你的登录 shell(
$SHELL→/bin/zsh→/bin/bash→/bin/sh,以-l -c调用)执行,PATH 和终端里一致:从 Finder 启动的 GUI 也能找到 nvm 装的node/yarn与ssh-agent里的 key。原先用/bin/sh -c时终端能跑的脚本在面板里会command not found,这是「部署没打通」最常见的原因。 - 没配也能开始:面板会只读探测博客根目录(
deploy.sh/scripts/deploy.sh/bin/deploy.sh,以及package.json的scripts.build搭配pnpm-lock.yaml/yarn.lock),在配置卡片里给出建议值,点「使用探测结果」填入表单,保存即生效。探测本身不写盘、不冒充已绑定。 - 留空即解绑:
deploy.script为空时接口返回ERR_NO_DEPLOY_SCRIPT;页头按钮此时只在探测到候选脚本时显示,点了会跳到配置页。 - 单步超时 10 分钟,stdout/stderr 各保留末尾 64KB;结果弹窗按步骤分块展示命令、退出码、耗时与输出,失败时标出是构建还是部署阶段。
- 部署过程中能看见日志:点按钮立刻弹窗,按步骤分块、块内 stdout/stderr 按到达顺序混排,边跑边长;面板每 1 秒读一次
GET /api/deploy/status(快照比单次请求活得久)。弹窗右上角「关闭」只关面板,部署照跑——页头按钮此时变成「查看部署日志」,点它随时接回;刷新页面或重开面板也会自动接回正在跑的那次。跑完同一个位置换成结果弹窗。 - 没有「取消部署」:
build跑到一半被杀会留下半截产物,比等它超时更难收拾,所以只提供关闭不提供中断。 - 最近 10 次部署写入
<projectRoot>/<digestDir>/deploy-history.json,配置卡片底部显示「上次部署」并可回看详情。 - 并发请求会被
ERR_DEPLOY_BUSY(409)挡住,同一时间只跑一次;根目录失效则返回ERR_NO_BLOG_ROOT。 - 路由和其他面板接口一样只接受 loopback 同源请求,不额外做命令沙箱——谁能拿到这个面板,谁就能执行这条命令。
插件原理
插件只做三件事:把 core 的端口接到 ctx 上、把能力暴露成工具、把状态暴露成页面。它自己不实现任何业务逻辑——src/plugin.js 里出现的最复杂的判断是「有没有配置博客根目录」。
flowchart TB
  subgraph HOST["DeepSeek Harness 宿主"]
    TOOLS["tools 服务"]
    WEB["webServer 服务"]
  end

  CFG["cordis.patch.yml<br/>projectRoot · articleDir<br/>draftDir · digestDir · verbose"]

  subgraph PLUGIN["src/plugin.js 薄壳"]
    APPLY["apply(ctx, config)"]
    RT["运行时状态<br/>projectRoot · target · store"]
    T4["4 个工具"]
    RTES["路由 + 零依赖面板"]
  end

  subgraph CORE["src/core 端口层(不认识 ctx)"]
    PIPE["pipeline 编排"]
    RANK["rank 打分"]
    VAL["validate 闸门"]
    SUP["supplement 证据"]
  end

  subgraph ADAPTERS["src/adapters"]
    SRC["source-rss<br/>rss / atom / github-release / hn"]
    ST["store-fs<br/>digest + raw"]
    VP["target-vitepress<br/>profile · scaffold · promote"]
  end

  CFG --> APPLY --> RT
  RT --> T4
  RT --> RTES
  T4 --> CORE
  RTES --> CORE
  CORE --> ADAPTERS
  TOOLS -.->|"注册"| T4
  WEB -.->|"注册"| RTES
  ADAPTERS --> FS[("博客仓库磁盘")]
三条边值得单独说:
- 宿主 → 薄壳是注册,不是调用。工具和路由都是
ctx.inject([服务名], sctx => sctx.effect(...))里注册进去的,effect返回的 disposer 负责卸载。所以插件热重载不会留下僵尸路由。 - 薄壳 → core 是端口注入。
runScan每次调用都现场createPipeline({ sources, ranker, store, clock }),core 拿到的全是函数和对象,没有一个是ctx。 - core → 适配器是唯一的落盘口。
src/core/里没有一处writeFile,写博客目录的代码只在target-vitepress.js里。
服务端文件分工
薄壳之外,src/ 下这几块各管一件事(2026-11 的一次纯结构重构拆出来的,行为未变):
| 文件 | 职责 |
|---|---|
plugin.js |
装配:读配置、建 target/store、注册工具与路由、生命周期 |
tools.js |
七个工具的契约(参数、output schema、render、execute),依赖全部注入 |
server/api.js |
路由表 + 配置读写 + 换绑逻辑 |
server/state.js |
/api/state 的状态聚合(配置 / 生效源 / 草稿 / digest / 订阅文章 / 任务) |
server/deploy.js |
执行部署命令、截留输出、记部署历史 |
server/http.js |
响应、请求体解析、loopback + 同源守卫 |
server/jobs.js |
后台写作任务的状态机 |
server/prefix.js |
/dsh-hotspot 与旧前缀 /hotspot |
拆分时踩到的一个坑值得记下来:搬移代码要重新审导入。detectDeployPlan 和 readDeployHistory 里的 readFileSync / readFile 都写在 try/catch 里,漏了导入不会报错,只会安静地返回空值——yarn build 探测变成空、部署历史变成 0 条。是测试把它们抓出来的,所以重构必须跑全量,不能只看 node --check。
配置从哪来
| 来源 | 生效时机 | 能改什么 |
|---|---|---|
cordis.patch.yml 的 config |
apply 入参,启动时 |
projectRoot / articleDir / draftDir / digestDir / limit / verbose |
工作区根目录的 dsh-hotspot.config.json 或 hotspot.config.json |
启动时读一次(projectRoot 为空则整段跳过) |
projectRoot 及其 digestDir / articleDir / draftDir |
| 面板「设置」页 | 运行时,走 onConfigUpdated → updateRuntime |
projectRoot / 目录名 / digestDir(rank、publish 写回配置文件;rank.limit 当场对下一次 hotspot_run 生效) |
工具参数 projectRoot |
单次调用 | 临时指定另一份博客仓库,不改全局状态 |
优先级从上到下后者覆盖前者(工具参数只影响那一次调用)。
两个已知的不一致,写在这里免得踩坑:
- 缺省文章目录不同。插件侧
articleDir缺省docs(最早只服务「文章直接放docs/下」这种布局),而 CLI 走适配器默认值docs/article(src/adapters/target-vitepress.js里的config.articleDir ?? 'docs/article')。插件的默认值会盖掉适配器的默认值,所以同一个仓库在插件里和 CLI 里可能指向不同目录——配置里显式写死articleDir就没有歧义。 - 配置键不同。插件读顶层的
articleDir/draftDir/digestDir,CLI 读target.articleDir/target.draftDir。两个键写在同一个文件里,各读各的。
目录的合并顺序是 面板/宿主显式配置 > 博客仓库配置(顶层键或 target.*)> 适配器默认值。插件以前只认第一层:仓库里写着 draftDir: ".drafts",它的 target 却按默认值去 docs/draft 找,于是面板顶部显示一套目录、草稿列表却是空的。现在 /api/state 的 blog.articleDir / blog.draftDir 报的也是 target 实际使用的目录。
候选上限的优先级是 工具参数 limit > 项目配置 rank.limit > cordis.patch.yml 的 limit。早期版本把 config.limit 写在前面,而 patch 里默认就有 limit: 15,于是面板里改的上限永远不生效——现在按上面这个顺序解析。
没配置博客目录时会怎样
projectRoot 为空或路径不存在 → 进入未绑定状态:target = null。
| 能力 | 未绑定时的行为 |
|---|---|
hotspot_run |
照常跑,但画像为空(没有 tag 词表、没有关键词加权),排序只剩新鲜度与源数;digest 只落在进程内存里,返回 persisted: false |
hotspot_get |
读同一份内存 digest(本次会话内能读,重启就没了);带 registerSlug 会返回「尚未配置博客项目根目录」 |
hotspot_scaffold / hotspot_supplement / hotspot_check / hotspot_promote / hotspot_write |
返回同一条提示,不抛异常 |
| 面板 | 能开,能在「设置」里填路径,填完立即生效 |
刻意的取舍:没有默认目录。猜一个 ~/blog 或者往宿主进程的 cwd 写 .hotspot/,比明确报错糟糕得多——所以在未绑定时抓取照常进行,只是不落盘。
七个工具
| 工具 | 参数 | 读 | 写 |
|---|---|---|---|
hotspot_run |
limit? |
配置文件里的 sources | .hotspot/digest/*.json、.hotspot/raw/*.json(未绑定时不写) |
hotspot_get |
id、registerSlug? |
digest + raw | 仅当传 registerSlug:<draftDir>/<slug>/sources.json |
hotspot_scaffold |
id、slug?、title?、description?、body?、projectRoot? |
digest | <draftDir>/<slug>/index.md + sources.json 的 candidate |
hotspot_supplement |
slug、url、title?、content?、kind?、projectRoot? |
sources.json |
同文件追加/覆盖(保留 candidate) |
hotspot_check |
slug、projectRoot? |
正文 + 一手源 + 补料 | — |
hotspot_promote |
slug、projectRoot? |
同上 | <articleDir>/<slug>/{index.md,sources.json} |
hotspot_write |
slug、body、projectRoot? |
已有草稿 | 覆盖正文(保留 frontmatter),写完立刻复核 |
三件事值得单独说:
scaffold只能建一次,改稿走write。草稿已存在时scaffold会拒绝并提示改用hotspot_write—— 早期版本这里没有出口,agent 拿到违规清单后只能请人去面板改。promote必须过闸。它内部就是checkDraft→target.promote,违规就拒绝、草稿留在原处。没有 force 开关:要放行只有改稿或登记补料两条正路。hotspot_get是唯一「读的时候可能写」的工具,因为 digest 按天滚动:隔天写同一篇草稿时,latest 里已经没有那个 cluster。registerSlug会把该候选的来源原文登记成补料,同时把candidate.id写进sources.json,写正文前先固化一次是最省事的做法。
路由与面板
每个路径同时注册在两个前缀下:/dsh-hotspot 和旧前缀 /hotspot。所以启动日志里的路由条数是路径数的两倍——看到数字对不上先想想这一条。
面板是一个零依赖 HTML(src/web/panel.html,脚本内联),不打包、不引框架,由路由直接吐出字符串。所有数据走 /api/* 的 JSON 接口,所以面板坏掉时可以直接 curl 排障。
POST /api/generate 与 POST /api/jobs 是两个会调模型的入口(前者同步、后者后台任务);宿主没提供 llm 服务时前者回 501、后者不建任务并把草稿留在原地。GET/POST /api/models 读模型目录与保存按用途的模型选择——没接 llm 时 GET 仍回 200 空目录,面板照常打开。
刻意没做的:不注册 /slash 命令、不注册定时任务。前者要猜命令 outcome 的契约;后者宿主已有「自动化任务」,让它定时调 hotspot_run 就行。少两处耦合,就少两处随 DSH 版本失效的地方。
DSH 插件
src/plugin.js 是薄壳(结构见上一节):把 core 的端口接上 ctx,然后就没它的事了。
已在真实运行时验证(DeepSeek Harness 0.2.1-rc.5,dsh web --port 0):apply 执行、tools 服务就绪、工具注册成功。
接口是从已安装插件的源码里读出来的,不是猜的:
import { defineTool } from '@deepseek-ai/dsh-tools'

export function apply(ctx, config) {            // 具名导出,不用 export default
  ctx.inject(['tools'], (sctx) => {
    sctx.effect(() => {
      const dispose = sctx.tools.register(defineTool({
        name: 'hotspot_run',
        description: '...',
        parameters: { limit: { type: 'number', description: '...' } },  // 扁平 map,不是 JSON Schema
        output: {
          schema: { type: 'object', additionalProperties: false, properties: {...} },
          render(_args, value) { return [{ type: 'text', text: '...' }] },  // 必须返回 ContentBlock[]
        },
        async execute(args) { return {...} },
      }))
      return () => dispose?.()
    })
  })
}
三个踩过的坑,写在这里免得再踩:
output.render必须返回ContentBlock[]。返回裸字符串不会立刻报错,而是在tools/post-execute阶段把下游消费者(如 hooks)打崩。output.schema不支持required: [...]。DSH 用的是自有 value schema DSL,写了会抛unsupported JSON schema: schema.required is not supported,而 Cordis 会把inject回调里的异常静默掉——表现是"插件加载了但工具不存在"。所以plugin.js里注册块被 try/catch 包住并显式console.warn,这个包装不要拆。llm.stream的 chunk 形状随宿主版本变,两种都得认。老版是{ type: 'chunk', chunk: { type: 'text-delta', text } },新版直接吐扁平的{ type: 'text-delta', text }(前后还有block-start/block-end/usage/finish)。collectStreamText只认嵌套形状时,表现是**「模型没有返回正文」**——模型明明回了 1745 字,被整段丢掉,而错误信息完全指错方向。现在两种形状都认,test/writer_route.test.js各有一条用例;同理,给思考型模型留的maxTokens不能太小,预算先被思考吃掉时会表现成「返回空」。
刻意没做的:不注册 /slash 命令、不注册定时任务。前者要猜命令 outcome 的契约;后者宿主已有「自动化任务」,让它定时调 hotspot_run 就行。少两处耦合,就少两处随 DSH 版本失效的地方。
安装
# 官方入口(走 pnpm,会写 profile 的 dependencies)
dsh plugin --profile <profile> add <本仓库路径>

# 然后把 hotspot 加进 profile 的 dsh.profile.bundles
#   ~/.dsh/profiles/<profile>/package.json
cordis.patch.yml 会作为一层 patch 自动应用(见 package.json 的 dsh.bundle.patch),里面的 config 就是配置面,改它不用改代码。
装进 DeepSeek Harness Desktop
Desktop 的 desktop profile 由 Electron 独占管理,dsh plugin --profile desktop add ... 会直接报 profile "desktop" is managed exclusively by the Electron application。Desktop 内改走应用自己的插件管理:
一次性接入:profile 的
dependencies用 link 指回本仓库,并把dsh-hotspot写进dsh.profile.bundles(~/.dsh/profiles/desktop/package.json):"dsh-hotspot": "link:/Users/laijihua/Desktop/Code/hotspot"还要让插件启动即知道博客仓库在哪:宿主是从进程 cwd 读工作区配置的,Desktop 下这个 cwd 是
~/.dsh/profiles/desktop。在那里放一份只含projectRoot的dsh-hotspot.config.json:{ "projectRoot": "/Users/you/Code/my-blog" }不然每次重启 App 后都是未绑定状态(面板显示「未绑定路径」),要手工再绑一次。真正的配置(sources / publish / deploy)仍以博客仓库里那份为准——插件读到这个
projectRoot后会跟随过去读它。改完代码怎么让它生效:宿主加载插件用的是裸
await import(url)(cordis-plugin-loader的import()),Node 在同一个进程内会复用已求值的模块 —— 所以plugin_manager的禁用再启用拿到的仍然是内存里那份旧代码。改src/plugin.js/src/server/**/src/core/**/src/adapters/**之后必须完全退出并重开 DeepSeek Harness(不是关窗口)。src/web/panel.html每次请求读盘、src/client.js由页面加载,改这两处刷新页面即可。旧文档说「禁用再启用就能生效,不需要重启」——那条是错的:它看起来生效过,是因为当时改的恰好是 panel.html 或 client.js。判断办法写在下面。
验证:
/hotspot/返回 200;/dsh-hotspot/rss.xml返回 200 且content-type: application/rss+xml;/dsh-hotspot/api/state的feed里有rssPath。怎么确认进程里跑的是不是最新代码:设置页 →「诊断」会显示「插件代码载入于 …」;如果磁盘上有文件比这个时间新,它会直接标黄:
磁盘上的插件代码比进程里新(N 个文件…),要完全退出并重开 DeepSeek Harness 才生效。对应的接口字段是/api/state的runtime.loadedAt与runtime.stale。
验证加载是否成功:cordis.patch.yml 里把 verbose 设为 true,启动后应看到
[dsh-hotspot] dsh-hotspot: 插件已加载,projectRoot=...
[dsh-hotspot] tools 服务就绪=true
[dsh-hotspot] 已注册 7 个工具:hotspot_run / hotspot_get / hotspot_scaffold / hotspot_supplement / hotspot_check / hotspot_promote / hotspot_write
管理界面
插件启动后会在 DSH 的 web server 上挂一组路由。管理功能在 DeepSeek Harness 侧栏的 dsh-hotspot 面板里(候选、草稿箱、写正文/润色、设置页)。同一组路由下还留着一个独立的兼容页面:
<你的 DSH 地址>/hotspot/
它只做快速查看(候选、订阅源、RSS 地址),页面顶部有醒目提示;标题/简介生成、六步进度、看正文、写正文、转正、模型选择这些能力只在应用内面板里。保留它的理由有两条:书签与 shell 里的 curl 还能用,以及面板本身坏掉时能拿来对接口。
订阅源这一页与应用内面板是同一套语义:内置源常驻、可关不可删(关闭走
POST /api/sources/builtin),自定义源 id 自动推导、可以删;每行都能点「测试」,添加前必须先测通(测挂了要再点一次「添加」确认)。早期这一页还停留在「手填 id + 删内置源」的老模型上,点删除会被接口以ERR_BUILTIN_ID拒掉 —— 已对齐。
四个页签:
| 页签 | 能做什么 |
|---|---|
| 源 | 增删 RSS / GitHub releases / HN 三种源,保存即写回配置文件;底部是 RSS 订阅地址(复制 / 打开) |
| 候选 | 一行候选计数 + 最近抓取时间,搜索与「全部 / 精选 / 多源」筛选;每条只看标题、两行摘要与来源,直接生成草稿;候选之外的原始条目折叠在「今日其他文章」里 |
| 内容 | 草稿列表:可「看正文」按站点排版预览、在线编辑、转正 |
| 设置 | 候选上限、时间窗、半衰期、去重阈值、外链白名单、构建与部署命令;画像 tag 与关键词只读展示 |
生成草稿:AI 起标题与简介 + 六步进度
「生成草稿」弹窗里的标题不再默认复制原文:打开即请求 POST /api/title-suggest,模型给 3 个中文标题、每个各带一个英文 slug;第一个自动填入,点其他候选会连 slug 一起换,之后仍可手改。拿不到标题(没接 llm / 超时 / 输出认不出来)时不阻断:标题回退原文,弹窗里只多一行灰字提示——标题是建议,不是建草稿的前置条件。
标题定下来后,简介按这个标题重写(POST /api/description-suggest):弹窗里多一个可编辑的多行框,初值是候选摘要,选完标题就换成模型写的 60–110 字(一句事实 + 一句为什么值得读)。换标题会连带换 slug 与简介;手改标题不自动重发,改完点「↻ 重新生成」。写不出来就保留候选摘要 + 一行提示,同样不阻断。
连点几个标题时会有多个请求在飞,面板用自增 token 只认最后一次的结果——否则会出现「第 2 个标题配第 3 段简介」这种错配。
确认后弹窗原位换成进度面板,把这条链路按 6 步摊开:
| # | 步骤 | 谁打点 |
|---|---|---|
| 1 | 建草稿 | POST /api/scaffold 同步落盘,起任务时直接预置成完成 |
| 2 | 定位候选 | createWriter |
| 3 | 收集一手素材 | createWriter(篇数 · 补料条数) |
| 4 | 选模型 | createWriter(provider/model) |
| 5 | 生成正文 | createWriter(模型返回字数) |
| 6 | 写盘与校验 | 写盘 + 三道闸门;校验不过标黄不标红 |
- 步骤定义收敛在
src/server/write-steps.js:服务端打点与面板渲染共用同一套 key/label,面板不会把「第 3 步」画成另一件事; - 每切一步落一次盘(
<digestDir>/jobs/<slug>.json),面板 1.5 秒轮询一次/api/jobs?slug=—— 轮询慢于切步就等于没有进度; - 关掉弹窗任务照跑,草稿卡片上的「✍️ 写作中」可以点开回看;失败时弹窗停在那一步并给「重试」,卡片上留 ⚠️ 徽标;
- 失败/取消只把当前那一步标成 failed/cancelled,没跑到的步骤保持 pending —— 「没跑过」不会被写成「跑完了」。
订阅今日候选(RSS)
订阅地址在「源」页底部,点「复制地址」即可;也可以直接在阅读器里添加:
<你的 DSH 地址>/dsh-hotspot/rss.xml
排序与去重规则是确定性的:
- 候选在前:当天候选按排名写入,
pubDate取 digest 的生成时间,所以按时间倒序展示的阅读器也会把候选排在最前; - 文章在后:随后是当天订阅源抓到、但没有进入候选的原文,按各自的发布时间倒序,没有发布时间的垫在最后;
- 单次最多 80 条,以避免一次把一天上千条原文推给阅读器;
- 候选 URL 与它命中的来源 URL 会先做规范化,同一篇不会在源里出现两次;正文不会进订阅源,
description只有摘要; - 每条都标来源:
description首行是来源:<订阅源名>,带源地址的源同时输出 RSS 2.0 的<source url="…">元素;候选是多源共现,会写成来源:A、B、C,方便判断这条是单源还是跨源撞出来的; - 源名优先用配置里的
name,没配就按类型兜底(github-release 用GitHub · owner/repo、hn 用Hacker News、rss 用域名),面板与订阅源用的是同一套映射; - 与
/api/*使用同一道 guard:只接受本机同源请求。要从别的设备订阅,请走 SSH 隧道之类的方式,不要把端口直接暴露到公网。
接口都在 /hotspot/api/ 下,普通 Node http handler,可直接 curl:
| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /hotspot/api/state |
一次返回 sources / config / articles / drafts / 最新 digest |
| POST | /hotspot/api/sources |
整体写入自定义源列表(id 可省略,服务端从域名推导;与内置源同 URL → 409 ERR_BUILTIN_URL,占用内置 id → 400 ERR_BUILTIN_ID) |
| POST | /hotspot/api/sources/builtin |
开关内置源 { id, enabled };关闭记进 disabledBuiltins,未知 id → 404 ERR_UNKNOWN_BUILTIN |
| GET | /hotspot/api/sources/derive |
只读推导源 id(?kind=&url= 或 ?kind=github-release&repo=),面板表单的只读预览用它 |
| POST | /hotspot/api/sources/test |
连接测试:真的抓一次,返回 { ok, items, ms, sample, error };抓取失败仍是 HTTP 200(测试完成了,只是源不通) |
| POST | /hotspot/api/config |
局部更新 projectRoot / 目录 / rank / publish / deploy.{build,script}(合并语义,只传 build 不会抹掉 script) |
| POST | /hotspot/api/run |
触发一次抓取;已有一次在跑时回 409 ERR_SCAN_BUSY |
| POST | /hotspot/api/scaffold |
按候选 id 生成草稿(slug / title / description 可覆盖);generate:true 时建完立刻在后台写正文并返回 job;slug 推导不出回 400 ERR_SLUG_REQUIRED |
| POST | /hotspot/api/title-suggest |
按候选 id 让模型起 3 个中文标题 + 英文 slug(复用写正文的模型选择);失败回 500 ERR_TITLE_SUGGEST,面板据此回退原文标题 |
| POST | /hotspot/api/description-suggest |
按候选 id + 定稿标题写一段 60–110 字简介(title 必填,空了回 400 ERR_TITLE_REQUIRED);失败回 500 ERR_DESCRIPTION_SUGGEST,面板回退候选摘要 |
| GET | /hotspot/api/jobs |
后台写作任务列表(?slug= 过滤);每条任务带 steps 六步进度 |
| POST | /hotspot/api/jobs/cancel |
取消正在跑的写作任务;没有在跑的回 404 ERR_NO_RUNNING_JOB |
| GET | /hotspot/api/errors |
当天的错误日志(?date= / ?limit=),附现有日志文件列表 |
| POST / DELETE | /hotspot/api/errors |
清空错误日志;带 { date } 只清那一天 |
| POST | /hotspot/api/jobs |
按 slug 重跑写正文(失败重试);同篇在跑时 409 ERR_JOB_BUSY |
| GET | /hotspot/api/article |
读正文,附带 supplements(补料条数与摘要) |
| POST | /hotspot/api/article |
保存正文 |
| POST | /hotspot/api/article-promote |
草稿转正(过闸;违规回 409 ERR_CHECK_FAILED + 违规清单) |
| POST | /hotspot/api/deploy |
按 deploy.build → deploy.script 顺序执行(未绑定 → 400,已在跑 → 409),返回分步退出码与输出,并落一条部署历史 |
| GET | /hotspot/api/deploy/status |
部署实时快照:state / cwd / 每步的 output(块内混排、截到 64KB)/ 退出码与耗时;没跑过返回 null,跑完保留上一次 |
| GET | /hotspot/rss.xml |
今日候选(前)+ 今日订阅文章(后)的 RSS 2.0 订阅源,content-type: application/rss+xml |
为什么不做 React 客户端插件:dsh.client 需要引入客户端构建链,还要绑定预发布期的客户端 UI API。这几个页面都是表格和表单,单个零依赖 HTML 足够;省下的是一整条会随 DSH 版本失效的耦合。
安全:插件路由不走平台鉴权(webServer.register 的语义如此),所以自己守一道——只接受 loopback 来源、拒绝 sec-fetch-site: cross-site、origin 与 host 必须同源。这三条对应 src/server/api.js 的 isAllowed()。
已知限制
- 只支持 VitePress。换生成器要写
Target适配器(src/adapters/target-vitepress.js是唯一实现)。 - 部署靠你自己配的命令:插件只负责按
deploy.build→deploy.script顺序执行、截留输出、记历史;构建产物目录、上传方式、探活地址都在你的脚本里,插件不猜。 github-release源走 releases.atom,不需要 token。本地网络若访问不了 github.com,该源会失败并在 digest 状态行里列出来——单源失败不影响其他源。- 跨源共现信号要有重叠才生效。如果几个源各覆盖一块不重叠的领域(比如 HN + 一个官方博客),所有条目
sourceCount都是 1,共现项退化成常数,排序实际由新鲜度和关键词决定。想让这个信号有意义,得让多个源覆盖同一领域。 - 「看正文」是近似预览,不是真站。草稿默认落在站点目录之外(
.drafts/),VitePress 根本看不到它,所以面板只能把 markdown 按站点版式(40rem 行宽、16px 正文、h2/h3 阶梯、代码块与表格)渲染一遍。结构问题(漏标题、表格错列、代码块没闭合)看得出来;主题组件、::: details的交互、代码高亮的配色仍需转正后到站上确认。真站预览要起 vitepress dev 并把草稿临时挂进docs/,没做。 - 中文标题不生成拼音 slug,
slugHint可能为空,scaffold会要求显式--slug。这是刻意的:拼音目录名后面还得手工重命名。面板里这条老问题由「AI 起标题」顺带解决——模型同时给一个英文 slug;CLI 与hotspot_scaffold工具没有这一步。 .hotspot/errors/默认只留当天,与 raw/digest 的 30 天保留策略分开(错误日志过期更快)。.hotspot/raw会自动清理。每次抓取结束后删掉超过store.keepDays(默认 30 天)的 digest 与 raw,latest.*/writer//jobs// 部署历史都不动。check只往回找 14 天,30 天够用;要留更久就把它调大。promote是硬闸门,没有 force。要放行只有两条路:把正文改到证据边界内,或把真正读过的页面登记成补料。MCP/宿主级强行改文件当然绕过它——闸门防的是流程上的惯性,不是防有磁盘权限的人。- 同时只允许一次抓取。两次并发 run 会互相覆盖当天的 digest 与 raw,所以入口用单飞挡掉:第二次直接回 409
ERR_SCAN_BUSY,不排队——排队会把「点两下」变成「跑两次」。 - 同一天重跑
run会覆盖当天 digest(<date>.json与latest.json),候选 idh-YYYYMMDD-NN会按新排序重新分配。草稿不受影响(它记的是candidate.id,check 按 id 往回找),但对话里的「#3」会指向新的第三条。 hotspot_write不建草稿。它只往已有草稿写正文;没有草稿就先hotspot_scaffold。- 后台写作任务不跨宿主重启续跑。状态文件(
<digestDir>/jobs/<slug>.json)留着,所以失败原因还看得到;但进程没了就是没了,重开面板后要点「重试写正文」。 - 写正文不联网。提示词里只有候选源原文与已登记补料,所以「这篇文章的材料够不够」直接决定了成稿质量:不够就先
hotspot_supplement登记真正读过的页面。联网找来源不在流水线里,这是刻意的(见「为什么不用子代理」)。 - digest 不进版本库(
.hotspot/已 gitignore)。它是过程产物;真正要留痕的判断应该写进文章或 commit message。
No comments yet. Be the first to write one.