dsh-voice-mode
DeepSeek Harness 全双工语音插件 —— 实时识别 · 按句朗读 · 开口即打断


Full-duplex voice mode for DeepSeek Harness —— 在会话内用语音完成整轮对话:说话时边说边出字、停顿后自动发送;回复按句朗读并跟随实时字幕;朗读中开口即打断。识别在本地推理、无需 API Key;朗读默认 Edge 云端(快且自然),本地 VITS / Kokoro 可选(隐私优先)。兼容 dsh 0.1.1 → 0.1.5 多版本。
💡 它是什么
在 DeepSeek Harness 的会话里,点一下麦克风就能用语音完成整轮对话:
- 🎤 你说 —— 一边说一边实时出字(流式识别),停顿约 700ms 自动发送;
- 🔊 它答 —— 最终回复按句朗读,全程实时字幕跟随;
- ⏸️ 随时打断 —— AI 还在朗读时开口即打断,你的话直接被听见。
零 API Key:识别在宿主端本地推理(zipformer2 流式 + SenseVoice 定稿);朗读默认 Edge 云端(快、自然),可选本地 VITS 纯中文 / Kokoro 中英混读(回复文本不出本机,隐私优先)。
✨ 为什么值得用
| 亮点 | 说明 |
|---|---|
| 🔒 零 API Key · 识别本地 | 识别本地推理;朗读默认 Edge 云端,本地 VITS / Kokoro 可选(隐私优先) |
| ⚡ 全双工对话 | 边说边出字、停顿自动发;AI 朗读时开口即打断,节奏接近真人对话 |
| 🗣️ 按句朗读 + 实时字幕 | 只读最终答复(跳过 reasoning / 工具调用),字幕跟随播放、可跳过 |
| 🎚️ 两种交互模式 | toggle 持续聆听自动断句 | hold 按住说话、松手即发;输入框旁一键切换 |
| 🎧 声学打断引擎 | 自适应阈值 barge-in(朗读时自动超灵敏),外放也能精准打断、不误判回声 |
| 🧩 多版本兼容 | 注入锚点取新旧交集 + 多版本 typecheck/冒烟回归;同一份代码跑 dsh 0.1.1 → 0.1.5 |
| 🌐 开箱即用 | 模型懒加载(断点续传 + 镜像回退);界面语言随浏览器(中 / 英);安全加固 |
🚀 60 秒上手
dsh plugin --profile web add dsh-voice-mode
bundle 插件安装后需重启 dsh 生效(Linux:
systemctl restart dsh;其他平台重启 dsh 进程)。
第一次用:
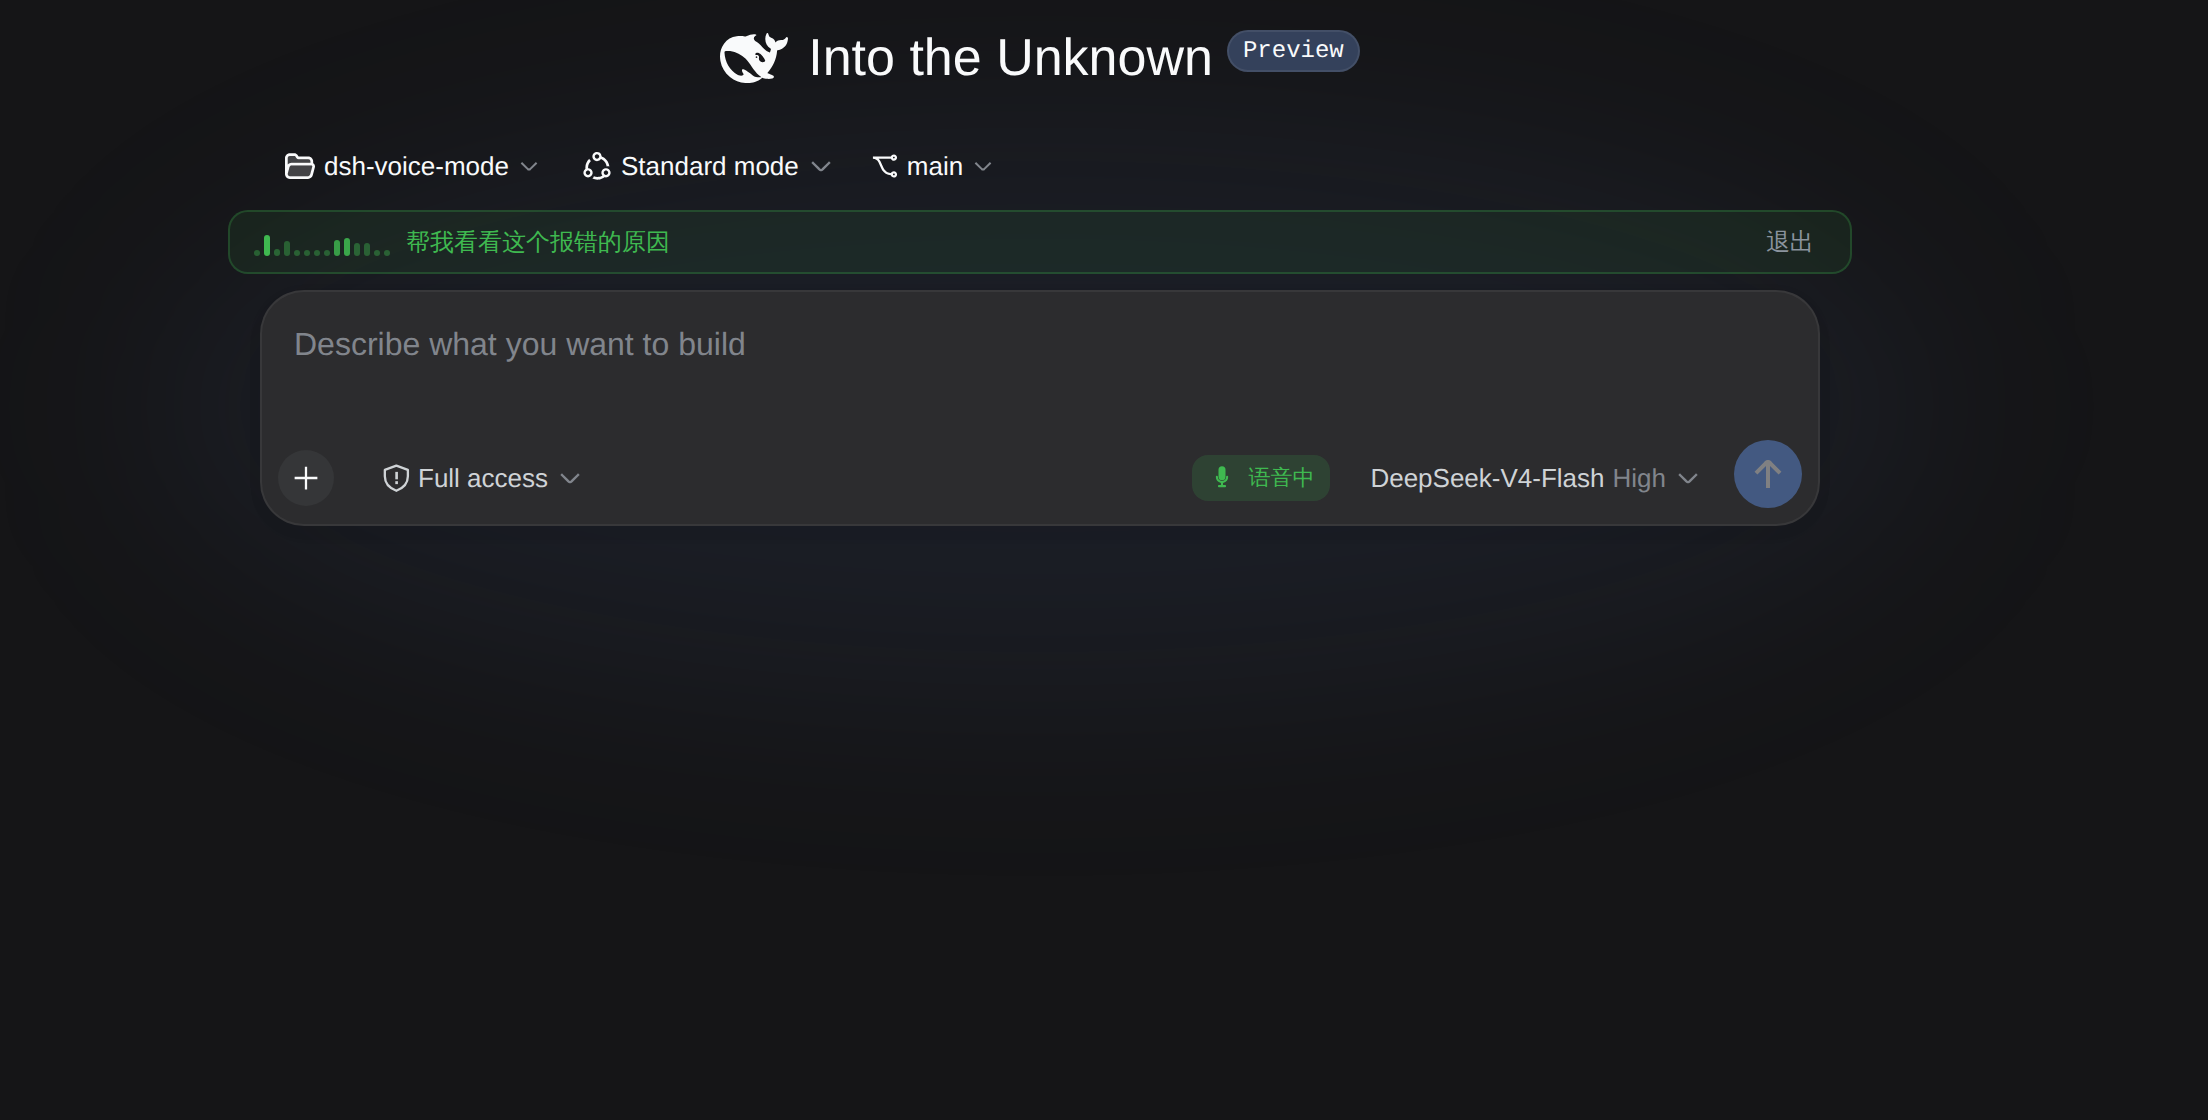
- 进入任一会话,按
Ctrl+Shift+V(或点输入区麦克风按钮)进入语音模式,状态条显示「聆听中…」; - 说一句完整的话(如「帮我看看今天的天气」)→ 实时字幕立即出现,停顿后自动发送;
- AI 回复开始朗读时,开口说话 → 朗读即刻停止,你的话被听见(这就是 barge-in)。
操作手势
| 手势 | 作用 |
|---|---|
Ctrl+Shift+V |
进入 / 退出语音模式 |
| 直接说话(toggle) | 边说边出字,停顿 700ms 自动发送;按住 Ctrl 强制立即发送 |
| 按住麦克风按钮(hold) | 松手发送;短按退出;滑出 / Esc / 失焦放弃本段 |
| 点输入框旁模式按钮 | 在「持续聆听 ⇄ 按住说」间切换(保存到设置) |
| AI 朗读时开口说话 | 打断朗读并取消当前回合 |
| 点状态条「退出」 | 退出语音模式 |
| 点字幕浮层「跳过」 | 跳过当前句朗读 |
⚙️ 在哪设置
设置 → Plugins → 插件配置 → 语音模式(voice-mode)。最常用的几个:
| 你想调什么 | 改哪个键 | 默认 | 说明 |
|---|---|---|---|
| 朗读引擎 | ttsEngine |
edge |
edge 微软云端(默认,快)/ vits 本地中文 / kokoro 本地中英;即时生效 |
| 模型精度 | kokoroModel |
int8 |
Kokoro 精度:int8(默认 109MB,CPU 推荐)/ fp32(311MB,音质更好,独显/大内存推荐) |
| 音色 / 语速 | voice / rate |
zh-CN-XiaoxiaoNeural(Edge)/ 1.0 |
按引擎取值:edge 用 ShortName(下拉全量加载 322 个)/ vits 说话人名 / kokoro 编号或中文名;行内可试听 |
| 打断灵敏度 | interruptLevel |
0 |
0 高门槛 / 1 中 / 2 低 |
| 停顿自动发送 | silenceMs / autoSend |
700 / true |
停顿毫秒数;autoSend 关闭则只进草稿 |
| 交互模式 | mode |
toggle |
toggle 持续聆听 / hold 按住说话 |
| 口语化回复 | spokenFormat |
true |
语音会话的回复更口语、短句、无 Markdown 符号(朗读更顺更快) |
| 模型镜像 | modelHost |
默认源 | 国内网络填 https://hf-mirror.com |
| 空闲退出 | idleTimeoutMinutes |
10 |
无活动自动退出语音模式 |
ttsEngine/kokoroModel/voice/rate/spokenFormat立即生效;其余下次进入语音模式时生效。 说明:wakeWord(唤醒词,默认关)与toolBeep(工具提示音,默认关)已完整接入;早期 fork 的asrModel(双语 paraformer)与punctuate(神经标点)已移除——SenseVoice 定稿本身已带标点,流式识别固定为 zipformer2。 完整设置、常用音色表、schema 配置见 详细文档。
📦 功能全景
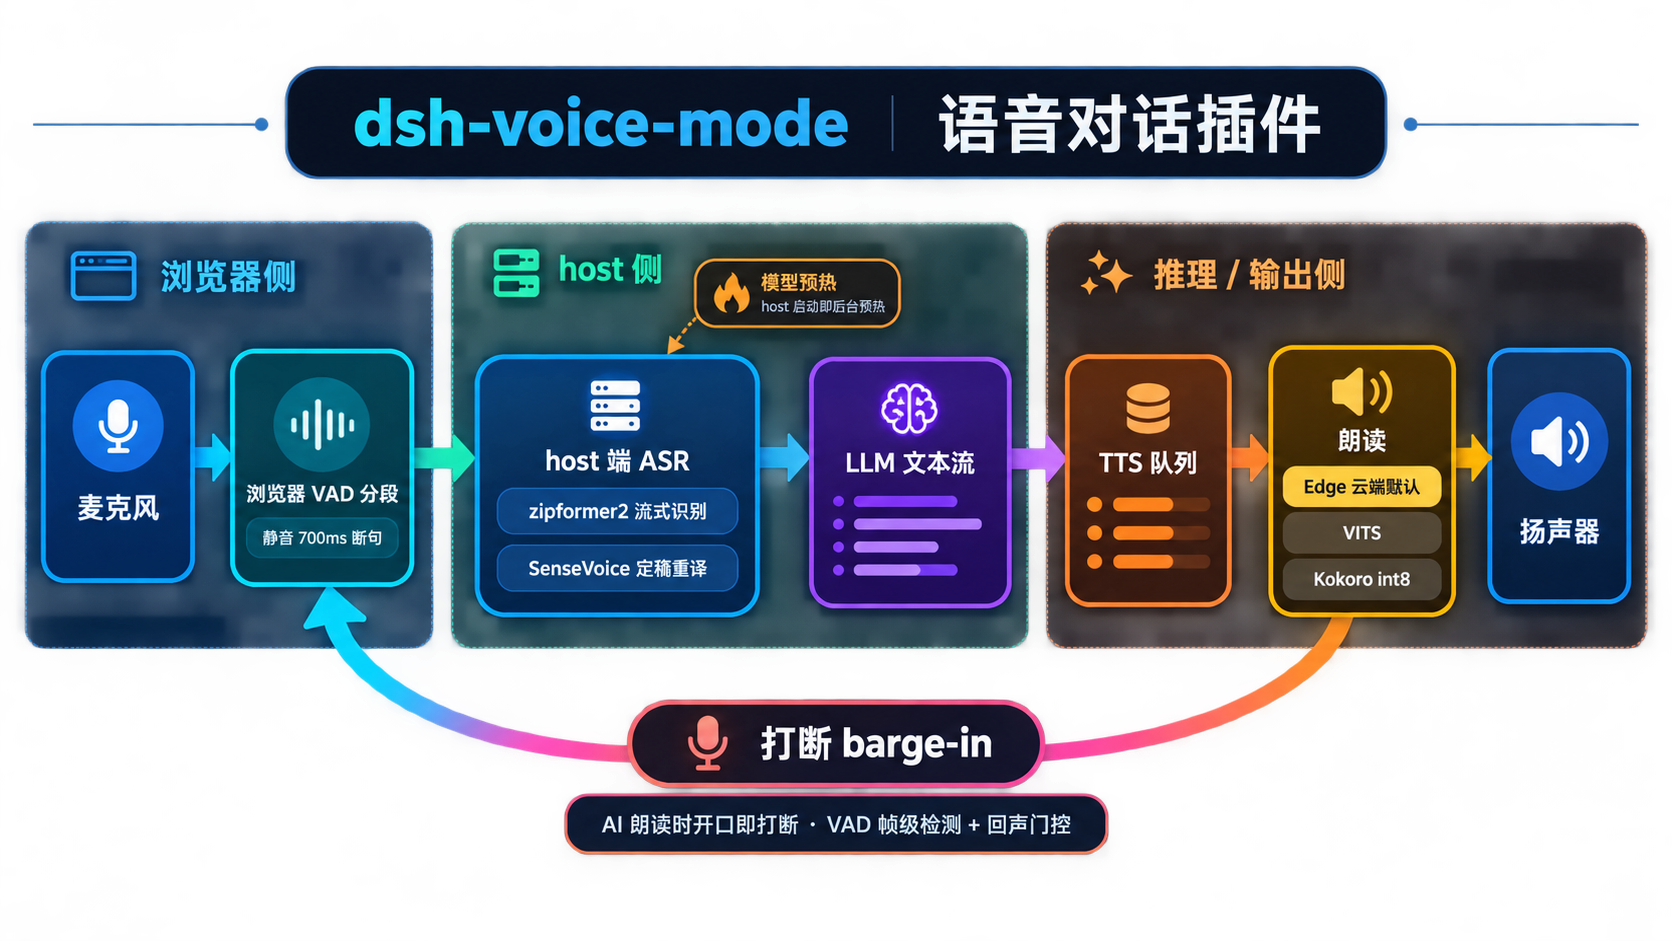
- 朗读:默认 Edge 云端;本地 VITS(纯中文 5 说话人)/ Kokoro(中英混读 103 音色,int8 默认 / fp32 可选),独立子进程、崩溃自愈
- 流式识别:zipformer2 流式(边说边出字)+ SenseVoice 定稿(带标点 / 数字归一化)
- 开口即打断(barge-in):自适应阈值(滚动噪声地板)+ 朗读时自动超灵敏;本地静音 + 合成队列作废 + 正在运行的回合取消
- 两种交互:
toggle持续聆听自动断句 /hold按住说话、松手即发;输入框旁模式切换按钮 - 模型预热 + 懒下载:ASR 模型 host 启动即后台预热(首次开语音零冷启动);本地 TTS 懒下载,
.part断点续传 + 镜像回退,状态条实时显示进度 - 安全加固:会话存在性校验 / 回环 + Origin 校验 / 全端点限流 / 模型 SHA256 固定 / 下载域名白名单
- 界面语言:跟随浏览器(中文 / English)
架构总览
🛠️ 故障排查
| 现象 | 处理 |
|---|---|
| 点麦克风无反应,状态条红字 | 浏览器拒绝麦克风:地址栏(iOS 为 设置 → Safari → 麦克风)开启后重试 |
| 状态条「正在加载模型… x%」卡住 | 检查网络;模型较大可先 npm run prefetch;国内网络 modelHost 配 https://hf-mirror.com |
| 朗读无声音 / 无字幕 | 本地引擎首次合成需加载模型;若持续失败看状态条提示(自动退避重试);确认页面前台且未静音 |
| 语音模式进不去 | 检查插件 enabled;多标签页时确认当前会话为活动会话 |
| 识别到但不是我要说的 | 环境噪声:降低音量或提高 interruptLevel(高门槛) |
已知限制:
Ctrl+Shift+V会覆盖浏览器「粘贴纯文本」快捷键(普通粘贴仍用Ctrl+V);识别为简体中文优先;Safari / iOS 需 HTTPS 或 localhost、首次需授权麦克风、后台 / 锁屏会暂停识别与朗读。
📚 文档
| 文档 | 说明 |
|---|---|
| 完整使用说明(中文) | 功能 / 手势 / 设置 / 配置 / 已知限制 / 故障排查 |
| English docs | Same, in English |
License
部分实现借鉴 haoku123/dsh-voice。
No comments yet. Be the first to write one.