dsh-web-search-fetch

面向资料研究的 DSH 插件:融合多来源搜索,整理网页正文,保留来源与差异。
面向 DeepSeek Harness(DSH)的网络搜索与网页提取插件。新安装默认启用 AnySearch、Firecrawl、Tavily,使用官方匿名额度开始,搜索与提取本身无需填写 API Key;自动预设另需配置决策模型凭证。配置更多服务后,通过原生 web_search 融合搜索结果,通过原生 web_fetch 整理多份正文。适合技术检索与资料研究。
快速开始 · 正文整理演示 · 真实对比 · 配置参考 · 参与贡献
dsh plugin --profile web add https://github.com/qikairo7/dsh-web-search-fetch/releases/download/v0.2.10/dsh-web-search-fetch-0.2.10.tgz
安装后在设置页选择决策模型并配置对应凭证,再请求搜索或读取公开网页。未配置决策模型时,可使用固定预设体验匿名搜索。匿名模式受服务方额度与限流约束,不能保证无限使用。未安装 DSH 的环境需先完成宿主安装。
项目特点
| 特点 | 当前实现 | 使用价值 |
|---|---|---|
| 多来源搜索融合 | 最多 16 个搜索服务并发调用,按 URL 去重,使用 RRF(Reciprocal Rank Fusion)融合排名 | 将多路可用结果整理为统一来源列表 |
| 无需密钥首次体验 | AnySearch、Firecrawl、Tavily 官方搜索与提取支持匿名额度,无需填写密钥 | 固定预设可直接体验;自动预设需先配置决策模型凭证 |
| 多来源正文整理 | 动态提取按章节和共同内容块去重、互补,保留提取来源及文本差异 | 将说明、表格、代码和独有段落整理到一份正文 |
| 原生双工具 | 仅注册搜索和提取 provider,不新增模型工具,也不需要额外 MCP 服务、浏览器自动化或外部 CLI | 沿用 DSH 的 web_search、web_fetch 调用方式 |
| 可选免费重排 | 调用硅基流动免费模型 BAAI/bge-reranker-v2-m3;不可用时保留融合顺序 |
对融合候选进行相关性排序,仍需配置 API Key |
| 服务统一管理 | DSH 凭证管理、服务开关、智谱通道选择,以及超时、取消、限流冷却和额度熔断 | 一处配置搜索、提取与重排;单路失败时继续使用其他可用结果 |
| 调用范围与预算 | 自动预设由快速决策模型判断 fast/balanced/deep;也支持免费接口/均衡/深度/自定义 |
不手动切换模式,由请求内容决定速度与覆盖范围 |
插件注册两个 ID 为 aggregated 的 provider。设置页覆盖 18 项搜索/提取/重排服务和 18 个凭证位,另提供五款决策模型选择。每项服务均提供独立启停开关。静态资源使用 DSH 内置 HTTP 提取器,AIHOT 专用 API 直接读取;其余 URL 按配置进入多服务提取。
动态网页提取默认将同一 URL 的多路结果整理成一份正文:按章节和共同段落去重,补充独有内容,保留提取来源和文本差异。代码、表格、链接和原文数字保留;不同标题、明确版本标记、语言或返回目标的内容放入补充片段,识别出的登录与挑战页面不混入正文。引用式链接与脚注按来源保留完整 Markdown 原文,避免同名定义串用。可切换旧版单份正文模式。规则边界见网页正文整理。
默认使用自动预设:决策模型先判断 fast(3 路)、balanced(5 路)或 deep(已选服务范围),再派发搜索和提取;外部决策模型是自动预设的必要依赖;超时或凭证缺失时返回明确错误,本次不派发服务。设置页也可固定为免费接口、均衡、深度或自定义,并独立选择搜索/提取服务、限制服务数量、HTTP 请求数、操作总限时和正文输出长度。保存后下一次调用生效;免费额度与付费服务不会自动纳入免费接口预设。
搜索融合和正文整理不构成事实交叉验证。多路并发会消耗对应服务额度。参数与使用边界见配置参考,离线验证方法见正文整理。
与 ModSearch 5.10.6 的 48 次真实调用均成功。多服务搜索中,ModSearch 的耗时与请求次数更低;本插件融合来源并整理多份提取,适合需要来源与差异记录的资料研究。样本与限制见真实对比。
完整接入清单
| 服务 | 搜索 | 网页提取 | 用途 |
|---|---|---|---|
| AnySearch AI | 支持 | 支持 | 搜索与正文提取 |
| 智谱 | 支持 | — | Anthropic 兼容通道与工具 API |
| 知乎 | 支持 | — | 内容搜索与额度查询 |
| Firecrawl | 支持 | 支持 | v2 Search 与 Scrape |
| Tavily | 支持 | 支持 | 搜索与 Extract |
| Exa | 支持 | 支持 | 搜索与 Contents |
| Keenable | 支持 | 支持 | 实时搜索与正文提取 |
| Crawl4AI Cloud | 支持 | 支持 | Cloud 搜索与 Scrape |
| GitHub | 支持 | 限定 URL | 公开仓库搜索,README / blob 文件提取 |
| 百度千帆 AI 搜索 | 支持 | — | 网页搜索 |
| 豆包 Custom | 支持 | 支持 | 搜索与 Fetch 分别配置凭证 |
| TinyFish | 支持 | 支持 | 独立 Search / Fetch API,共用密钥 |
| Serply | 支持 | 支持 | Google 搜索与 Markdown 提取 |
| Kimi | 支持 | 支持 | REST Basic / Pro 搜索与 Markdown 提取 |
| Bing RSS | 支持 | — | 匿名公开 RSS 搜索 |
| AIHOT | AI 资讯关键词 | 专用 API | 默认关闭,支持热点、事件、报告与精选读取 |
| 硅基流动 | 重排 | — | 融合结果相关性排序 |
| 阿里决策模型 | 自动预设路由 | — | decision-model-preview 判断覆盖范围 |
| TypeSafe | 自动预设路由 | — | jev-latest 判断覆盖范围 |
| 直接 HTTP 抓取 | — | 静态资源 | 复用 DSH HTTP 组件,无需服务凭证 |
新安装默认开启 AnySearch、Firecrawl、Tavily 三家推荐服务,其余远程服务与硅基流动重排作为可选增强,默认关闭。直接 HTTP 抓取保留为静态资源的基础提取能力。已保存的显式开关设置优先于安装默认;旧版未设置开关的服务采用新版默认。按需开启增强后,搜索最多 16 路;普通动态提取最多 10 路,适用的 GitHub URL 最多 11 路。Kimi Basic / Pro 二选一,只计一路。AIHOT 专用 API 直接读取,重排和 HTTP 抓取均不计入动态提取路数。实际参与调用的服务取决于配置、凭证、URL 适用范围及熔断状态。
智谱仅支持搜索,不包含阅读器。GitHub 提取限定仓库根 URL 和 /blob/<ref>/<path>。Bing RSS 使用公开搜索 feed,无需密钥;其可用性和格式可能变化。
AIHOT 搜索覆盖近 7 天 AI 资讯;启用后,原生 web_fetch 可读取热点、事件、日报、周报、月报、重置记录和精选快照/增量 API,不参与通用网页提取。使用方法见 AIHOT 接入。启用前请阅读 AIHOT 使用规则;服务数据授权与本项目 MIT 代码许可分别适用。
服务费用
各服务可按免费服务、免费额度和付费使用区分。免费额度可能是每日/每月额度,也可能是限时试用或赠送额度。
| 费用方式 | 服务 | 说明 |
|---|---|---|
| 免费服务 | TinyFish Search/Fetch、Bing RSS、GitHub 公开 API、直接 HTTP 抓取、硅基流动 BAAI/bge-reranker-v2-m3 与三款 SystemOne 决策模型、阿里 decision-model-preview |
受请求频率、访问权限或资源限制约束;硅基流动与阿里仍需配置 API Key |
| 免费服务(有用途限制) | AIHOT | 个人非商业、公益非商业及组织内部使用;其他用途按服务规则授权 |
| 提供免费额度 | AnySearch、知乎、Firecrawl、Tavily、Exa、Keenable、Crawl4AI Cloud、Serply | 免费额度的有效期、重置周期和超额计费以服务方及账号为准 |
| 按次计费或付费订阅 | 智谱当前搜索通道、Kimi REST 搜索与提取 | Coding Plan 为付费订阅;tools-api 使用按次计费的 search_pro,套餐额度不属于免费额度;Kimi REST 接口按次计费,账号赠送额度需另行确认 |
| 按区域限制 | TypeSafe jev-latest |
付费模型;直连返回 HTTP 451,配置 DSH 代理后可用 |
推荐服务支持匿名访问,匿名额度仍受 IP、请求频率及服务方额度限制:
| 推荐服务 | 未配置密钥时 | 配置密钥后 |
|---|---|---|
| AnySearch | 官方 /v1/search、/v1/extract 使用公共额度,按 IP 限流 |
使用对应账户的权限与额度 |
| Firecrawl | 官方 /v2/search、/v2/scrape 使用匿名额度 |
使用对应账户的权限与额度 |
| Tavily | 官方 /search、/extract 使用 keyless 模式,携带 x-tavily-access-mode: keyless,受共享限流约束 |
使用账户鉴权,不再发送 keyless 头 |
自定义端点仍需配置密钥;已有密钥失效时不自动降级为匿名请求。匿名模式不表示无限免费,也不保证结果质量或可用性。AnySearch 匿名额度耗尽的响应可能包含自动生成的账号信息,插件不记录、不保存,也不自动使用。接口依据:AnySearch Search、AnySearch Extract、Firecrawl 官方 Keyless 说明、Tavily 官方 SDK。
免费接口预设仍排除 AnySearch、Firecrawl、Tavily 等额度型服务;推荐默认组合使用自定义预设。
百度千帆和豆包 Custom 的免费额度、赠送额度及开通条件需按对应账号确认。选择服务时,同时检查搜索与提取接口是否都在免费范围内。插件按配置并发调用,不自动按价格排序,也不保证只使用免费额度。
硅基流动重排使用免费模型 BAAI/bge-reranker-v2-m3,需要注册账号并配置 SILICONFLOW_API_KEY。注册入口:硅基流动(邀请链接)。模型费用以硅基流动官方定价为准。
费用依据:AnySearch、知乎、Firecrawl、Tavily、Exa、Keenable、Crawl4AI、TinyFish、Serply、智谱 Coding Plan、Kimi REST 接口定价。
快速开始
环境要求
| 组件 | 要求 |
|---|---|
| Node.js | ^22.19.0 || >=24.0.0,不包含 Node.js 23 |
| DSH | 已安装,并具有 web 和 credentials 服务 |
| 开发工具 | pnpm 12.10.1 |
| 外部服务 | 网络连通性;推荐的 AnySearch、Firecrawl、Tavily 官方匿名模式无需凭证,增强服务按需启用 |
已在 Windows、Node.js 24.20.0、DSH 0.2.1-alpha.2 / 0.2.1-alpha.3 的正式环境及隔离 profile 中验证安装、原生搜索和网页提取。alpha.3 的 @deepseek-ai/dsh-tool-web 与 @deepseek-ai/dsh-web 运行时代码和类型声明相对 alpha.2 未变化,新增 locale 资源与依赖版本。CI 覆盖 Windows/Ubuntu、Node.js 22.19/24 的构建、类型检查与测试;CI 通过不表示这些组合均完成 DSH 实机验收。
| DSH 版本 | 兼容声明 | 验证范围 |
|---|---|---|
0.2.1-alpha.2 |
compatible | 上述 Windows 环境的安装、搜索与提取 |
0.2.1-alpha.3 |
compatible | 上述 Windows 环境的安装、搜索与提取 |
0.2.1-alpha.1 |
unknown | 尚未执行该版本运行验收 |
0.2.0-rc.2 |
unknown | 尚未执行该版本运行验收 |
默认分支的 package.json 提供 dsh.compatibility.dshReleases 精确版本声明;未验证版本保持 unknown。发布包包含这项兼容元数据。这里不声明所有版本的卸载或回滚已通过验收。
使用发布包安装
在已配置 DSH 的环境中执行:
dsh plugin --profile web add https://github.com/qikairo7/dsh-web-search-fetch/releases/download/v0.2.10/dsh-web-search-fetch-0.2.10.tgz
将 web 替换为实际使用的 profile,安装后重启宿主。本项目通过 GitHub Release 分发固定版本包;此命令不需要 npm 包发布账号或 GitHub 登录。
从源码安装
在已配置 DSH 的环境中执行:
git clone https://github.com/qikairo7/dsh-web-search-fetch.git
cd dsh-web-search-fetch
pnpm install --frozen-lockfile
pnpm run build
dsh plugin --profile <profile> add link:<absolute-repository-path>
将 <profile> 替换为目标 profile,将 <absolute-repository-path> 替换为仓库绝对路径。路径包含空格时,对整个 link: 参数加引号。
bundle patch 自动选择 provider。使用以下命令检查装载后的配置:
dsh --profile <profile> --dump-config
应出现 web-search-fetch 条目,以及 web 条目下的 searchProvider: aggregated 和 fetchProvider: aggregated。配置输出仅证明装载状态;还需实际调用工具检查响应。分享输出前应检查其他插件的私密数据。
配置凭证
在 DSH Web 的「设置 → 内置插件 → 网络搜索与提取」中填写所需凭证并保存。空白填写位保持已有凭证;状态区只显示配置状态。
也可通过 DSH 凭证服务管理以下引用:
| 默认引用名 | 服务 |
|---|---|
ZHIPU_API_KEY |
智谱搜索 |
ANYSEARCH_API_KEY |
AnySearch 搜索与提取 |
ZHIHU_ACCESS_SECRET |
知乎搜索与额度查询 |
FIRECRAWL_API_KEY |
Firecrawl 搜索与提取 |
TAVILY_API_KEY |
Tavily |
EXA_API_KEY |
Exa |
KEENABLE_API_KEY |
Keenable |
CRAWL4AI_API_KEY |
Crawl4AI Cloud |
GITHUB_TOKEN |
GitHub |
QIANFAN_API_KEY |
百度千帆 AI 搜索 |
DOUBAO_SEARCH_API_KEY |
豆包搜索 |
DOUBAO_FETCH_API_KEY |
豆包提取 |
TINYFISH_API_KEY |
TinyFish |
SERPLY_API_KEY |
Serply |
MOONSHOT_API_KEY |
Kimi 搜索与提取 |
SILICONFLOW_API_KEY |
硅基流动重排 |
DASHSCOPE_API_KEY |
阿里决策模型 |
TYPESAFE_API_KEY |
TypeSafe 决策模型 |
推荐的 AnySearch、Firecrawl、Tavily 官方搜索与提取无需凭证,状态显示“匿名额度”;配置密钥后使用账户模式。Bing RSS、AIHOT 和直接 HTTP 抓取无需凭证。豆包搜索与提取分别填写;服务总开关同时控制其搜索与提取。服务列表支持名称搜索、能力筛选和配置状态筛选;隐藏或折叠的草稿仍会保留。配置状态表示凭证存在,不证明服务健康。
配置文件只填写引用名。凭证值由 DSH 管理,每次操作重新解析。详细说明见配置参考。
使用
在启用本插件的 DSH 会话中使用原生工具,例如:
搜索 DeepSeek Harness 的插件开发文档,并列出来源链接。
读取 https://example.com/guide.md,概括主要内容。
动态提取默认单个服务限时 45 秒。需为会话实际使用的 tool-web 设置足够的提取预算;Web agent preset 中的嵌套工具配置也需检查。见工具超时配置。
设置界面
设置页使用 DSH 原生分段选择、输入框、复选框和开关。首屏显示当前调用方式与服务配置;展开“调用设置”可切换预设和正文处理方式,请求数、超时和正文长度在“高级调用限制”中调整。服务列表支持关键词搜索、能力筛选和逐项配置。推荐的三家服务置顶,其余标注“可选增强”;每行统一显示配置状态、启用开关和展开箭头。总开关保留凭证与参与范围;关闭直接 HTTP 抓取后,静态 URL 会报错,不会自动调用其他服务。
数值输入允许暂时清空,超出范围时显示提示并阻止保存;搜索框按 Enter 不会提交设置。保存前可以放弃修改,离开设置页会撤销未保存草稿。配置状态仅表示凭证是否存在。
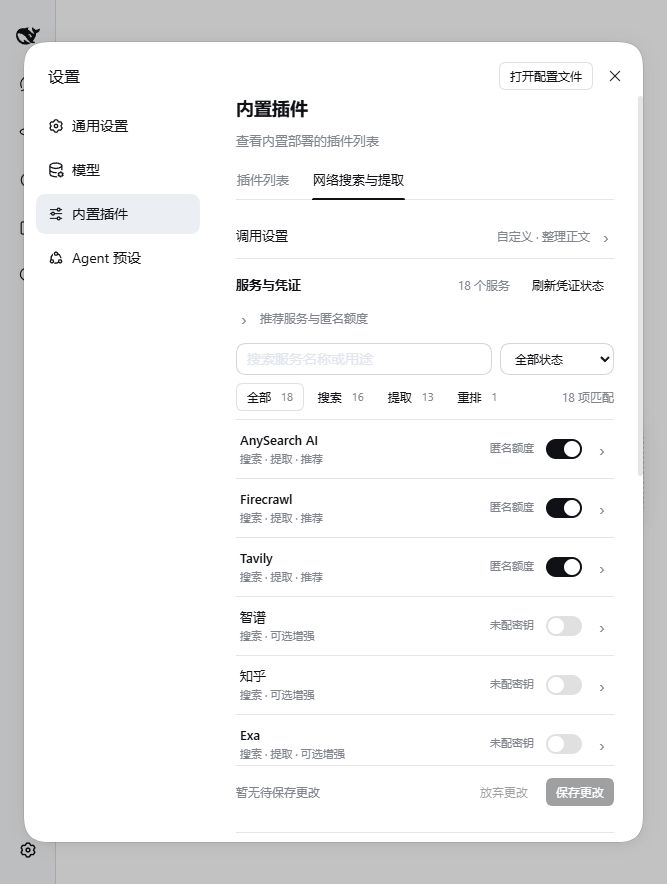
官方匿名额度、账户额度及自定义端点要求在服务说明中区分。已保存的密钥不会回显到填写位。
工作原理
flowchart LR
    Search[web_search] --> Fanout[多来源并发搜索]
    Fanout --> Fusion[URL 去重与 RRF 融合]
    Fusion --> Rerank[可选相关性重排]
    Rerank --> Sources[统一来源列表]
    Fetch[web_fetch] --> API{已启用的 AIHOT 专用 API?}
    API -->|是| AIHOT[读取 Markdown 或完整 JSON]
    API -->|否| Route{URL 分流规则}
    Route -->|静态资源| HTTP[DSH HTTP 提取器]
    Route -->|其他 URL| Extract[多来源并发提取]
    Extract --> Mode{正文处理模式}
    Mode -->|默认整理| Organize[内容块去重与互补]
    Organize --> Body[正文、来源与文本差异]
    Mode -->|旧版兼容| Select[评分后返回单份正文]
已启用的 AIHOT 专用 API 先直接读取,其他 URL 再进入分流。分流根据 URL 扩展名和配置的静态域名判断,不检测页面渲染能力。HTML、PDF、未知扩展名及无扩展名 URL 默认进入动态提取。静态提取失败时不会自动转入付费服务;动态提取失败时也不会自动回退到 HTTP。
文档
| 文档 | 内容 |
|---|---|
| 配置参考 | 参数、端点、凭证回落关系和工具预算 |
| 网页正文整理 | 整理规则、来源标记、差异处理和限制 |
| 与 ModSearch 的真实对比 | 方法、逐次指标、请求成本与证据边界 |
| AIHOT 接入 | 原生工具读取 Markdown、结构化报告及精选 API |
| 架构说明 | 模块职责、数据流、错误处理和扩展方式 |
| 术语表 | 项目术语与接口含义 |
| 常见问题 | 装载、凭证、超时和熔断排查 |
| 贡献指南 | 本地开发、测试和提交要求 |
| 安全说明 | 外部请求、凭证保护和漏洞报告 |
贡献与反馈
问题反馈和功能建议请通过 GitHub Issues 提交。提交代码前请阅读贡献指南。
许可与致谢
本项目采用 MIT 许可。AnySearch 服务包含来自 anysearch-team/anysearch-dsh 的 MIT 代码;智谱通道参考了 PartinGQAQ/dsh-web-search-zhipu 的方法与协议常量。来源、改造范围和第三方许可全文见 NOTICE。
No comments yet. Be the first to write one.