@nydsg/dsh-mindmap


中文 · English
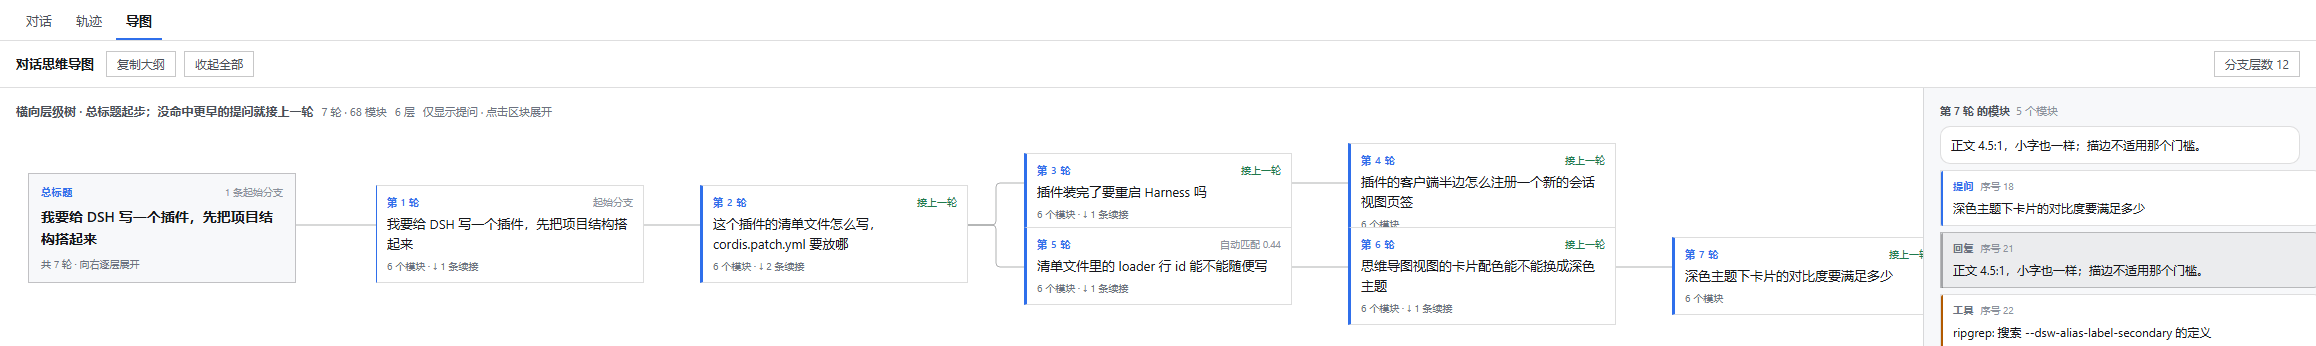
把 DSH 的对话轨迹渲染成一张横向层级树:最左侧是唯一的起始总标题节点(内容 = 第 1 轮提问),从左到右单向逐层展开(列 = 层级深度,行 = 排布),卡片表面只显示你的提问;插件拿本轮提问去和之前每一轮做比较——先比提问词面,词面对不上时再比那一轮已经在聊什么(它的回复与工具调用)——续接到最像的那条分支上,都不像就自己开一条新分支挂在总标题下。整张图扁平化简约:1px 实线描边、纯色填充、直角、无阴影、无渐变,连线是横平竖直的正交折线。选中卡片后右侧列出该轮全部模块(回复 / 工具 / 上下文),点某一行出详情;同一面板里还能手动改它接在哪条分支。
全部本地计算:零网络请求、零模型调用、零构建步骤。
1.4.0 起还有一条可选路径 ——「模型判定」。 它把文档规定的系统提示词(见下[智能分层])连同导图全局状态交给你自己已在 DSH 里配置好的模型,由模型判断这一轮该「下推 / 换行 / 回溯」,再把结果贴回同一张图。宿主半为此提供一条本地 HTTP 桥(
/plugin-mindmap/*),只有你点「运行模型判定」时才会发起调用;默认仍然是离线词面判定,不点就不联网。
安装
dsh plugin --profile web add @nydsg/dsh-mindmap
重启 Harness,会话顶部会出现第三个页签「导图」,与「对话」「轨迹」平级。
这条命令走 npm。若包尚未发布(
npm view @nydsg/dsh-mindmap查不到),请用下面的本地开发安装从源码挂载。
也可以在 DSH 插件市场里搜索安装——市场清单来自策展仓库 awesome-dsh-plugin(收录后)。
功能
| 能力 | 说明 |
|---|---|
| 导图页签 | 在会话顶部新增「导图」,与「对话」「轨迹」平级,不改动任何现有页签 |
| 起始总标题 | 最左列一个节点,内容取第 1 轮提问;它不是一轮对话,没有模块、不可选中,也不产生自己的连线 |
| 横向层级树 | 列 = 深度、行 = 排布;父卡片右侧折线连到子卡片左侧。卡片位置由布局算出来,不依赖测量 DOM |
| 单一入口 | 所有分支起点都挂在总标题下,因此只有一个起点;底部的「N 条起始分支」说明它下面挂了几条 |
| 自动分支 | 本轮提问与此前每一轮的提问比较,超过阈值就接到最像的那条;否则成为新的起始分支(评分规则见下) |
| 接上一轮 | 提问词面没有命中任何更早的轮次时,本轮就作为上一轮的子节点:对话里下一个问题跟在最后一个回答后面,这是结构而不是猜测。角标标为「接上一轮」,与「自动匹配」区分开 |
| 卡片只露提问 | 表面只有轮次号 + 分支标记 + 提问原文(最多 4 行)+ 模块数;回复不在卡片上 |
| 手动改分支 | 选中卡片后:填轮次号接到任意更早的问题下面 / 改为新分支 / 恢复自动;并可一键清除全部手动连接 |
| 相似度候选 | 右侧列出该轮最像的前 5 个前序提问及分数,点一条即手动接到它下面 |
| 持久化 | 手动连接按会话存本地,重载后仍在;手动指定永不被自动重算覆盖 |
| 模块面板 | 选中卡片后右侧列出该轮模块行,点任一行显示该模块回复原文、关键词权重条、前序分析与候选后续提问 |
| 层数控制 | 工具栏限制向下画几层分支(总标题不算一层);被折起的子树在那张卡片上给出「还有 N 条续接」按钮,就地再展一层 |
| 关键词过滤 | 命中的卡片正常显示,未命中的变暗而不移除(移除会让父节点消失、结构说谎) |
| 三操作标注 | 每张卡片的角标直接说明文档定义的操作:[下推] 接上一轮 / [换行] 同级新建 / [回溯] 匹配 {分数};工具栏同时给出三种操作的计数 |
| 层级上限 | 文档的最大层级 5 落成硬规则:再向下就会超过上限的一轮改为在上一轮旁边并列(换行新建),长会话因此横向生长而不是一路向右;可设 0 = 不限 |
| 智能分层面板 | 右侧面板给出文档的三操作说明、可替换变量({{MAX_DEPTH}} 等)、模型路由与温度,以及一次模型判定的进度与结果 |
| 提示词可复制 | 文档的系统提示词与用户输入模板原样内置,可一键复制(系统提示词会带上本次生效的配置值),导图状态与单轮片段同样可复制 |
| 模型判定(可选) | 逐轮调用你自己的模型判断操作,结果按会话保存;关掉开关即停止生效,手动指定永远压过模型结论,可一键清除 |
| 大纲导出 | 一键把整张导图复制成 Markdown 大纲 |
| 扁平化 | 卡片 1px 实线描边 + 纯色填充、直角、无阴影无渐变;连线为 1px 正交折线 |
| 离线 | 默认全部分析在浏览器本地完成,零网络、零模型调用 |
分支是怎么定的
规则只有两条,顺序就是全部设计:
- 提问词面命中就按它接。 本轮提问与此前某一轮的提问共享足够的信号词(分数 = 共享信号权重 ÷ 较小一方的信号权重,阈值
0.50),就接到那一轮下面 —— 这是唯一能说明「我在回到某个更早的话题」的证据; - 否则接上一轮。 对话里下一个问题跟在最后一个回答后面,这是结构,不是猜测,所以它不需要靠相似度赚取资格;
- 第一轮从总标题开始。
为什么「接上一轮」不能靠相似度判断(这是踩过的坑)
上一版把第 2 条当成了一个需要词面证据支撑的弱猜测:先要求提问词面达到 0.40,不够再要求「语境共鸣」达到 0.65,两者都不够才算新分支。
结果是它几乎从不生效。用 tools/measure-sessions.mjs 量本机真实会话(解压 ~/.dsh/sessions 的多帧 zstd 日志,只取真人提问):
| 指标 | 真实追问上的结果 |
|---|---|
提问词面达到 0.40 |
0 / 9 |
| 「对上一轮」的共鸣最大值 | 0.33 |
| 旧规则把追问判成「新分支」 | 9 / 9 |
根因是真实追问是指代性的短句(「是对的」「那接下来呢」「我在终端执行完了」),它几乎不重复上一轮回复里的任何名词。所以:
- 用相似度阈值判断「是否接上一轮」在真实数据上不可能成立 —— 门槛高到能拒绝一个换话题的问题,也就高到拒绝掉真实追问;
- 相似度只在第 1 条里有意义:回到旧话题时,提问确实会重新说出那个话题的词。
修正后同一批数据:9 条追问全部接上一轮,0 条误判。
代价说清楚:一个真正换话题的问题(比如中途问「晚饭吃什么」)也会作为上一轮的子节点,而不是另起一棵树。这是刻意的取舍——「按对话顺序展开」优先于「按话题聚类」,而且手动固定(把某轮改为新分支)随时可以纠正。
词面分数怎么算
每个问题有两套词:全会话共享的背景词(产品名、"怎么"、文件名),和只属于少数问题的信号词(会话内出现 ≤2 次,或高于该问题自身的 IDF 中位数)。分数 = 共享信号权重 ÷ 较小一方的信号权重,阈值 0.50。
为什么不用余弦:实测(见 tools/TEST-REPORT.md)真连接的余弦落在 0.29–0.72,而只共享背景词的伪匹配余弦是 0.16–0.20 —— 没有一条余弦阈值能把它们分开。换成信号占比后,真连接 0.44–1.00、伪匹配 ≤0.28,断层干净。0.40 是这条断层的中间值;1.4.1 起按「更严苛」的要求上调到 0.50 —— 它离伪匹配的上限(0.28)很远,同时高于真连接带的下沿,于是 0.44–0.50 那段边缘对(实测一例:深色主题下卡片的对比度需要满足 4.5:1 吗 接 思维导图的卡片配色能不能换成深色主题 = 0.4391)不再被声称为「回到旧话题」,而是按对话顺序下推。代价就是:回溯变少、但每一条的回溯证据更硬;顺带一提,这两轮本来相邻,下推与回溯指向的父节点恰好相同,所以图基本不动,只是那句断言更诚实了。这条取舍在 behaviour.mjs 里被直接钉住(LINK_MIN_SCORE >= 0.5),test.mjs 也有一个「把它降回 0.40」的变异用例证明门禁会红。
三种连接在界面上是分开标注的,因为它们是三种不同的断言:自动匹配 {分数}(词面命中)、接上一轮(结构延续)、手动指定。1.4.0 起这些标注同时带上文档的操作名([回溯] / [下推] / [换行]),因为「接在谁下面」和「这是哪一种操作」是同一个判断的两面(见[智能分层])。
自动结论是猜测,所以任何一轮都能被手动改掉(接到任意更早的轮次 / 改为新分支 / 恢复自动);被改过的一轮不会再被自动重算覆盖。父节点必须是严格更早的轮次,这条不变量在代码里强制执行(否则树会成环、渲染会无限递归)。
为什么最左侧一定是总标题
相似度判定的是「这一轮接在哪一轮后面」,它给出的是一个森林:几个互不相像的问题各自成为一棵树的根。直接画出来就是几棵并列的树,读者看不出这场会话从哪里开始 —— 这正是「没有起点」的问题。
所以布局层在森林之上加一个合成节点:它占据第 0 列,森林的每一棵树都挂到它下面,于是全图只有一个没有父节点的节点,从它向右逐层展开。这个节点:
- 文本取第 1 轮提问 —— 会话真正的开端,而不是一句通用文案;
modules为空、不是按钮、不可选中:它不是一轮对话,右侧面板、大纲、所有逐轮控件都以 turn 为准,所以它天然被排除在外;- 不参与层数计数:工具栏的「分支层数」数的是分支层,总标题不是一层,所以层数 = 1 时它和第一层仍然画出来;
- 自己的连线不画(左边没有东西可连),但从它出发到每条起始分支的连线要画 —— 否则几个分支就只是"排在后面",而不是"挂在它下面"。
布局为什么是算出来的,不是量出来的
第一版连线看不见,根因是**「量出来的布局」**:卡片坐标来自渲染后 getBoundingClientRect,于是坐标永远比内容晚一帧,任何一次测量没跑到,连线层就是空的。
现在位置全部来自算术:
- 列 = 深度 ×(卡片宽 + 列间距),第 0 列(总标题列)再多留一点间隔,让入口和它拥有的树分开
- 行 = 整齐树(tidy tree)分配:叶子按顺序吃掉下一个行位,父节点在自己子树的区间里居中
第二点是关键。按前序遍历分配行位,父节点必然排在自己所有子节点之上,每条连线都得往回折——这正是横向树不可读的原因。居中父节点才能让连线自然成扇形。behaviour.mjs 对这两条都有断言:父节点中心必须落在子节点中心区间内;同一列内卡片不得重叠(跨列重叠是正常的,因为父节点本就居中于子节点之间)。
只有卡片高度需要测量(提问换行数无法预知),而且它只影响行距,不影响列、不影响父子关系——所以测量晚一帧也不会让连线消失。
连线是正交折线而不是贝塞尔:先向右出父卡片,在半途拐上/下,再水平进入子卡片左边缘。两行相同时退化为一条直线——那才是"这两张对齐"的诚实画法。曲线只会增加装饰,还会把"这条分支在哪一行拐弯"藏起来。
卡片上不出现回复:registration.mjs 用结构断言钉住这条——renderTreeCard 必须渲染 turn.promptText、不得出现 turn.answerText,也不得调用 renderCard(模块行归右侧面板,否则展开会挪动卡片高度、把所有连线推歪)。
智能分层:下推 / 换行 / 回溯
需求文档(DSH-Mindmap 智能分层提示词)要的是这样一件事:判断当前这一轮和已有节点是什么关系,在三种操作里选一个,并且每次只输出新增或调整的 Markdown 嵌套列表片段,同时标注操作类型。插件现在有两套判定,共用同一套操作词汇 —— 离线词面判定是默认,模型判定是可选项:
| 文档的操作 | 结构表现 | 离线词面判定(默认) | 模型判定(可选) |
|---|---|---|---|
| 父类下推 | 作为上一节点的子节点,向下缩进 | 提问没点名任何更早的轮次 → 接上一轮 | 模型判断为「追问 / 解释 / 细化 / 延续」 |
| 换行新建 | 与上一节点同级,横向并列 | 再向下会超过 {{MAX_DEPTH}}(默认 5)→ 在上一轮旁边并列 |
模型判断为「由上一回答引出的新问题」,或无法判断归属 |
| 回溯分支 | 从更早的祖先重新建立分支 | 提问命中更早某一轮的信号词(≥ 0.50)→ 接到那一轮下面 |
模型判断为「与更早的某个节点高度相关,而非延续上一节点」 |
判定结果就写在卡片的角标上:[下推] 接上一轮、[换行] 同级新建、[回溯] 匹配 0.67,模型判定的那几轮标为 [下推/换行/回溯] 模型判定,手动改过的仍然是「手动指定」。工具栏的计数行给出本图三种操作各有多少轮。
层级上限为什么会变成「换行」
文档的「判断逻辑」写着层级深度:一般不超过 5 层;若层级过深,可考虑合并或拆分节点,「插件配置建议」把最大层级定为 5。这条规则在离线判定里是一个硬约束:如果一轮按原规则会落在第 6 层,它就不再向下,而是在上一轮旁边并列(LINK_MAX_DEPTH,默认 5)—— 这正是文档的「换行新建」,而且它是一条结构规则,不是相似度猜测,所以不需要靠分数赚取资格。
于是长会话的形状变了:以前是 N 轮 = N 列,一路向右;现在是到第 5 层就横向生长,列数封顶。两个出口都在:把面板里的最大层级设成 0 就退回「不限层级」,而手动指定永远不受上限约束 —— 上限是默认值,手动是明确指令。
离线判定为什么把「无法判断」判成「下推」
文档的操作判定表最后一行是「无法判断归属 → 保守处理 → 换行新建」。离线判定故意不这么做,理由是本仓库自己量过(见上一节):真实追问是指代性的短句,与上一轮的任何重叠分数都落在 0.00–0.33,也就是「没有词面证据」恰恰是真实延续的常态。把「没证据」判成「同级并列」,等于把每一条真实追问都摆到上一轮旁边 —— 那正是 1.2.0 犯过的错(9 条真实追问 9 条被误判)。
所以两套判定按各自能承担的证据分工:
- 离线判定:「无法判断」按对话顺序下推,并在面板里把这条取舍写清楚;
- 模型判定:文档的「无法判断 → 换行新建」逐字执行 —— 模型确实能做出这个判断,词面引擎不能。
状态、片段与提示词
- 全局状态是算出来的,不是存下来的。
layerState把「轮次 + 已解析的连接」渲染成文档的{{MINDMAP_STATE}}:每个节点带操作、层级、父节点,外加 Markdown 嵌套列表。存一份状态就会有「状态与画出来的树不一致」的可能,所以它每次从树推导。 - 状态里不写操作标注,片段里必须写。 文档的「历史节点」示例是一棵干净的嵌套列表,标注属于模型返回的片段(「仅输出新增或调整的部分,并注明操作类型」)。
- 状态里没有总标题那一行。 画出来的图有一个合成总标题节点(它的文本就是第 1 轮提问),但它是渲染装置、不是节点;把它写进状态,模型会看到同一个问题一次当父、一次当子 —— 那正是文档「验收标准」里禁止的明显错误嵌套。
- 片段的两种写法都收。
parseLayerFragment读文档的 Markdown 形式([下推]/[换行]/[回溯]首行 + 嵌套列表;英文标记、代码围栏、前面还有解释性文字都能认),也读它「维护与迭代」里提到的 JSON 形式(operation+path/labels)。解析失败就如实报告(ok: false+ 原因 + 原文),绝不当成「下推」硬塞进树里。 - 节点名仍然是你的提问(按
{{NODE_MAX_CHARS}}裁剪)。模型自己起的节点名(比如「Web 框架」)会被记下来、用在状态与片段里、并显示在右侧面板,但卡片上不替换你的提问 —— 这是本插件的既有承诺:卡片只露提问。 - 文档的提示词原样内置。 系统提示词与用户输入模板都能在面板里一键复制;系统提示词后面会附上本次生效的配置(
MAX_DEPTH/NODE_MAX_CHARS/LANGUAGE/OUTPUT_FORMAT),所以你复制出来的就是真正发出去的那一份。
模型判定是怎么跑的
一次运行 = 逐轮一次模型调用,顺序执行,每次都带上「到上一轮为止」的全局状态(文档的「状态维护:每次操作后,更新思维导图全局状态,确保后续判断基于最新结构」):取当前轮的问题与回复 → 填进用户模板 → 连同系统提示词走宿主桥 → 解析回操作与目标父节点 → 更新状态 → 下一轮。运行有轮数上限(默认最近 24 轮)、可以随时停止(停止后迟到的回复会被丢弃,不会半途改图)、进度可见,结果按会话保存在本地。关掉模型判定开关只是让它不再影响树(结论仍留着,切回来立刻可用),而手动指定永远压过模型结论,「清除模型判定」一次清空。
模型桥:为什么是一条 HTTP 路由
客户端的 bundle 拿不到模型:它只收到 require,没有 llm 服务,也没有「客户端调用本包宿主半」的通道。所以模型的调用放在宿主半(lib/index.js),只做一件事 —— 把一次调用转发给 ctx.llm.stream 并把模型的原文回给页面:
| 路由 | 作用 |
|---|---|
GET /plugin-mindmap/info |
报告这条桥能不能用(本组合有没有 llm)、可用的 provider 列表,以及 profile 里已配置的默认 provider/model |
POST /plugin-mindmap/layer |
收下 {system, user, provider, model, temperature, maxTokens, timeoutMs},返回 {ok, text, provider, model, usage} |
为什么不是官方那条 Remote 通道:客户端的 Remote 需要随包发布的生成式 Typert schema,而这个仓库刻意没有构建步骤。ctx.webServer 上的具名路由不需要 codegen、不需要 wire schema、也不需要客户端注入服务,而页面本来就有 fetch。代价是它是一条本地 HTTP 面,所以它被收窄了:两条 exact 路由、只收 JSON、256 KiB body 上限、2000 token 上限、温度上限、超时,以及页面断开即取消;并且模型失败必须回失败(502),不能回一个空字符串让界面以为「判定完成、什么也没说」。
路由的路径前缀是本插件自己的 /plugin-mindmap(不是 /api),所以不会和网关的前缀路由撞车;inject: ["webServer"] 是硬依赖,缺少 Web 载体的组合里宿主半只会静静等着,客户端那半照常离线工作。
配置:文档的「插件配置建议」逐条落地
| 文档建议 | 插件里的实现 |
|---|---|
| 模型温度 0.2 – 0.5 | 面板里可填,越界会被夹回区间(1.5 → 0.5、0 → 0.2),非数字回落 0.3 |
| 最大层级 5 | LINK_MAX_DEPTH = 5,驱动「换行新建」;设 0 = 不限 |
| 节点最大字数 15 | {{NODE_MAX_CHARS}},用于状态、片段与节点名(超出加省略号) |
| 输出格式 Markdown 嵌套列表 | 默认;JSON 形式(保留 operation 字段)也能解析 |
| 操作标注 必须输出 | layerFragmentMarkdown 输出首行标注;解析缺标注的回复会报错而不是猜 |
| 状态维护 每轮更新 | 模型判定每轮重建状态后再判下一轮 |
| 不确定策略 换行新建 | 模型路径逐字执行;离线路径按下推(理由见上,面板里写明) |
| 语言 中文 | 默认中文,可切 English(节点命名语言写进系统提示词) |
本地开发安装
如果你要改这个插件,而不是只用它,就把仓库目录直接挂进 profile:
- 把本目录放到
%APPDATA%\dsh-desktop\harness\profiles\web\node_modules\@nydsg\dsh-mindmap; - 在
profiles/web/cordis.patch.yml的用户补丁层里加一行:
- insert:
    - id: '@nydsg/dsh-mindmap'
      name: '@nydsg/dsh-mindmap'
- 重启 DSH(菜单:重启 Harness)—— 客户端模块图与插件 bundle 路由在启动时一次性生成,热加载无法让新插件的 bundle 路由凭空出现。
改 lib/ 后覆盖回去再重启即可;无构建步骤。
注意桌面端安装的是一份拷贝(不是软链):dsh plugin add 之后要再跑一次才会把新的 lib/ 同步过去,然后重启 Harness。
为什么开发版走补丁层而不是
dsh plugin add:桌面端的 generation 维护只接管市场安装的插件并会重写package.json,补丁层是它不会碰的那一层。正式安装则应该用dsh plugin --profile web add @nydsg/dsh-mindmap,不要同时保留手写行——同 id 两个 loader 条目会让启动失败。
开发
无构建步骤:lib/client.js 是手写的 window.__ModuleLoader__.load({id, factory}) 懒 CJS 包,直接用 React.createElement,不依赖 JSX 编译。
改完把 lib/ 覆盖回 profile 目录,再重启 Harness。
node tools/test.mjs          # 跑门禁,并逐个重放历史 bug 证明门禁会红(CI 与 prepack 都用它)
node tools/showcase.mjs      # 用例展示:引擎在给定会话上实际做出的判定 + 树几何
node tools/make-report.mjs   # 把上面两者重新生成为 tools/TEST-REPORT.md
node tools/check.mjs         # 语法 + 插件面 + CSS 令牌完整性 / 零硬编码颜色
node tools/behaviour.mjs     # 分词、关键词、分支判定评分、层级上限、布局几何、投影适配器
node tools/registration.mjs  # apply()/inject() 契约 + 视图**真的渲染**后的结构不变量
node tools/layering.mjs      # 提示词资产、变量替换、配置夹取、片段协议、全局状态、落点判定
node tools/host.mjs          # 宿主模型桥:路由挂载、/info、/layer、拒绝、夹取、取消、失败即失败
node tools/verify-pack.mjs   # 发布前检查:清单身份、必需文件、无开发机绝对路径
node tools/screenshot.mjs    # 重新生成 docs/screenshot.png(需要 Edge 或 Chrome)
node tools/session-map.mjs   # 把**真实会话日志**按本插件的判定画成导图(HTML + PNG + 三操作文本报告)
node tools/measure-sessions.mjs     # 用本机真实会话量匹配规则(解压 ~/.dsh/sessions 的多帧 zstd 日志)
全部离线、确定性,无依赖(只有截图脚本需要一个 Chromium 系浏览器)。npm test 等价于 node tools/test.mjs;npm publish 的 prepack 钩子会自动先跑它。
README 顶部那张图不是屏幕截图,而是渲染预览:它取的真实素材是插件自己的样式表(从
lib/client.js里抽出来)和自己的布局算术(layoutTree/placeTree/edgePath跑同一段示例会话),所以卡片位置、连线路径、观感都是插件真的会画出来的东西;手写的是外面那圈 DOM 骨架(页签、工具栏、侧栏)与 DSH 主题令牌的取值。改完视觉跑一遍npm run screenshot即可更新。
三道代码门禁(check / behaviour / registration)都必须 PASS (0 problems);test.mjs 还必须报告 all mutations caught。verify-pack.mjs 是第四道,但只服务于发包,只在发布前跑。
门禁会红才算门禁。 test.mjs 逐个把历史 bug 塞回一次性副本,断言指名的那道门禁变红——包括 useChat 契约、手动分支被自动覆盖、前序遍历排布、连线缺失、评分退回原始余弦、总标题被层数折掉、总标题的连线被跳过、总标题换成通用文案、清单里的 @ 不加引号。只跑绿的门禁是自我安慰。当前运行记录见 tools/TEST-REPORT.md。
踩过的坑(别再犯)
cordis.patch.yml 里的 @ 必须加引号 —— 不加会让插件根本装不上。
# 错:@ 是 YAML 保留指示符,plain scalar 不能以它开头。
#     js-yaml 4 直接拒绝整个文件:bad indentation of a mapping entry (15:11)
- insert:
    - id: @nydsg/dsh-mindmap
      name: '@nydsg/dsh-mindmap'

# 对:两处都引起来
- insert:
    - id: '@nydsg/dsh-mindmap'
      name: '@nydsg/dsh-mindmap'
代价是整次安装被回滚(dsh plugin add 会校验清单,解析失败就恢复 package.json、pnpm-lock.yaml 与 node_modules),而当时三道门禁全绿:check.mjs 只解析 lib/,从没读过清单。清单是安装路径上唯一的输入,所以现在 check.mjs 用 tools/yaml.mjs 把它解析并校验一遍(只能有一行、包名可解析、id 不重复);两个变异用例(把 @ 的引号去掉、把 loader 行插两次)证明这道门禁会红。
inject() 返回面里,来源必须放在 hooks 下、用原名声明。
// 错:渲染器不认这个 useChat,会把它当普通 prop 原样透传,
//     视图拿到 source 对象而不是函数 → 运行时 useChat is not a function
return { useChat: chat, sessionId, writeDraft };

// 对:渲染器用 standardHookPropName 把 chat 铸成 useChat prop
return { hooks: { chat }, sessionId, writeDraft };
规则来自 dsh-client-ui-renderer 的 bindInjectSources:有 hooks 键时,其中每个条目经 standardHookPropName 变成 use<Name> prop(并由 observableHook 包成真正的 Hook);没有 hooks 键时,整份返回值原样当 props 透传。registration.mjs 现在复刻了这段语义并断言形状,再犯会变红。
更贵的教训:最初的 registration.mjs 直接把 inject() 的返回值当 props 用,等于替插件把错的契约圆了过去,于是给出假绿灯。门禁必须复刻真实框架的绑定语义,而不是绕过它。
门禁里手搓的 React,会在你没注意的地方比真 React 弱。
registration.mjs 的 React stub 一开始有两处不忠实:createElement 把子节点记在兄弟字段 children 上(真 React 放进 props.children),而且从不调用函数组件(只记下 type)。后果是视图的错误边界 MindMapBoundary 读 props.children 得到 undefined、直接返回 undefined,MindMapBody 从未执行 —— 而门禁只断言「渲染出了非空的东西」,于是一个会崩的视图能一路绿灯。加「智能分层」面板时它才暴露:断言面板里的三个操作名,门禁报「视图什么都没渲染」。
现在 stub 把子节点同时放进 props.children(单个子节点就是它自己,与 React 一致)与 children,门禁再用一个 expand() 把函数组件展开,并断言渲染结果里没有崩溃面板(mm-crash)—— 崩溃面板正是「页面还在、视图是崩的」那种故障。教训与上一节同源:stub 必须复刻真实语义,否则它测试的是 stub 自己。
变异用例也可能把门禁挂死,而不是弄红。
新加的「页面断开要取消模型调用」用例,在变异成「不取消」之后,假模型会一直等一个永远不来的中止信号 —— test.mjs 于是卡住(不是变红)。挂着跑的门禁什么都不证明。修法是让假模型自己也有一条硬超时:不取消就 1.5 秒后失败,于是门禁 1.7 秒内变红并指名那条断言。门禁的失败必须是「快而具体」,超时不是失败。
instanceof 是跨 realm 失效的。 分支解析里 overrides instanceof Map 在测试沙箱里恒为假(门禁构造的 Map 与 bundle 所在 vm 不是同一个 realm),于是所有手动连接都被静默丢弃——自动结论看起来正常,手动控制完全不生效。改成鸭子类型判定(有 get/has/forEach 即视作 Map)。凡是跨 realm 传值(vm、iframe、worker)都要避开 instanceof。
不要在测试脚手架里重建 React。 为了断言「收起状态不显示回复」,我曾写过一个遍历元素树的 walker,结果在 hook 派发器、类组件实例化、props.children 折叠这些与待测性质无关的模拟细节上反复失败,每次都表现成一条误导性的红灯,消耗远超收益。改为对渲染函数做结构断言:精确、稳定、失败信息指向真实原因。要用渲染树断言时,就上真正的 React(如 react-dom/server),不要手搓。
不要用「结果」代替「性质」来写断言。 我最初为匹配规则写的断言是「只共享背景词的一对不连接」——但那一对在原始余弦评分下也不连接(短句的余弦本来就低),所以断言是绿的,而真正该保护的分离性没有被保护:把评分退回余弦,门禁依然全绿。改成直接断言两类分数之间要有宽间隔(伪匹配对低于阈值、真连接高于阈值、且两者差 > 0.3),变异才立刻被抓出来。断言要钉住判别性质,不是钉住当时恰好也成立的结果。1.4.1 又补了一层:那三条断言原本写死 0.4,阈值一改它们就会去描述一条代码已经不再执行的规则 —— 现在它们比的是 LINK_MIN_SCORE 本身,而阈值这个值另有独立断言钉住(>= 0.5),所以「悄悄放松阈值」会红。
已知边界
- 中文分词:
Intl.Segmenter的word模式对多数中文词只切到单字(思维导图→思维|导|图)。插件在分词器给出的单字串内部做最长合并(导|图|插|件→导图插件),但不跨越分词器已经给出的多字词(思维)。因此思维导图会被报成思维+导图而不是一个词。这是刻意的取舍:要复原它需要词典,而用滑窗硬凑会造出不存在的词(实验中出现过导图插件这种伪词)。对「关键词分析 + 候选提问」这两个用途,拆成两个词是可用的。 - 匹配分数不是余弦,是「共享信号占较小一方的比例」(规则与实测数据见上文「分支是怎么定的」)。
- 关键词门槛:只有在本会话中出现 ≥2 次的词才会进入关键词榜;单次出现的词只出现在「新话题」一栏。
- 候选题是模板拼装,不是语义生成。真正的语义判断现在有了可选入口(「模型判定」),但候选提问这一栏仍然是模板拼装:默认路径刻意不调用模型,以保证即时与离线。
- 同义改写连不上(「怎么装插件」vs「插件如何安装」):判断是词面匹配,一个信号词都不共享就是另一条链(
装与安装分词后是不同词)。手动指定就是为这种情况准备的。阈值(断层中点0.40,1.4.1 起有意收紧到0.50)与回溯12轮是从用例数据里定的(见TEST-REPORT.md的分数表),但仍只覆盖我构造的那几类会话形状。收紧后的副作用:真连接带 0.44–0.50 的那一段不再判回溯,改为按对话顺序下推(相邻两轮时父节点往往相同,所以树多半不动,只是断言更硬)。 - 换话题的追问也会接在上一轮下面:这是第 1 节的刻意取舍 —— 「按对话顺序展开」优先于「按话题聚类」。中途问一句「晚饭吃什么」,它会成为上一轮的子节点而不是新的一棵树;把那一轮手动改为新分支即可纠正。
- 长会话在第 5 层横向生长:1.4.0 起文档的最大层级 5 是硬规则,所以链式展开到第 5 层就不再向下,而是在上一轮旁边并列(换行新建)。列数因此封顶,行数继续增长;把它设成 0 就回到「N 轮 = N 列」的旧形状。工具栏的分支层数仍然可以把画出来的子树折起来。
- 模型判定只在你点它时才联网:默认的离线判定不发任何请求。模型路径需要 profile 里配好 provider/model(未配时面板会直接说「宿主桥不可用或本组合没有 llm 服务」),而且新增的宿主路由要重启 Harness 才会出现 —— 客户端的 bundle 组合路由与 loader 行都在启动时一次性生成。
- 模型桥是一条本地 HTTP 面:两条 exact 路由、JSON only、有 body/token/温度上限与超时,路径前缀是插件自己的
/plugin-mindmap。它不做鉴权(与本机其它本地服务同一信任级别),也不返回除模型原文之外的任何东西。 - 模型返回的节点名不替换卡片上的提问:卡片只露提问是插件的既有承诺;模型给出的节点名用于状态、片段和右侧面板。
- 模型可能返回解析不了的东西:那时面板会显示「片段解析失败 + 原因 + 原文」,这一轮保留原判定,不会被硬塞进树里;重新运行或手动指定即可。
- 离线判定不给「回溯」找超过
LINK_MAX_AGE(12 轮)之外的祖先,也不会为了「换行」去猜语义 —— 那两件事是模型路径的职责。 - 同分时按「更近的轮次」取胜:度量确实会给出完全相等的分数。实测一例:
#5与#1、#2的相似度都精确等于0.5642,因为共享的是同一批词(dsh/插件/安装/profile),而各自的区分词(web/重启与失败/排查)都不与#5的要重匹配——度量没有信息可用来区分,于是并列时取更近的轮次。这不是 bug,是词面度量的诚实局限,所以任何一轮都能手动改父节点。 - 极短的追问现在一定接得上:像「继续」「对的」这种只有一两个泛词的追问,词面分数为 0,于是按结构接在上一轮之后——这正是新规则要保证的。它们不会再被误判成新分支(旧规则会)。
- 分支按轮次线性推演:新的一轮只能接在更早的轮次下,因此不会出现「后面的问题成为前面问题之父」的回指结构。
- 总标题只有一个,且固定取第 1 轮提问:没有第二个入口节点,也没有「换个标题」的 UI;若第 1 轮没有提问文本,标题会显示「(本轮没有提问文本)」。
- 只有卡片高度是量出来的,列与行全部由布局算出,所以测量晚一帧只会让行距短暂变化,不会让连线消失。字体加载造成的高度变化若发生在测量之后,行距可能短暂偏移。
- 未验证项:本机无法截图。扁平化后的观感、正交折线的拐角、总标题卡与第一列的间距是否合适,仍需你亲眼确认;同样没有端到端跑过真实模型调用 —— 宿主桥是用假
llm服务在tools/host.mjs里驱动的(挂载、路由、拒绝、夹取、取消、失败即失败都有断言),但「模型真的回了一段可解析的片段」这件事只能等你重启 Harness 后亲眼验证。已机检的只有语法、令牌完整性、颜色合规、匹配与布局的算术性质(含总标题列与它的连线)、分层协议、宿主桥契约,以及结构不变量。变异验证只能证明门禁能抓住这几类退化,不能证明它抓住了所有退化。
No comments yet. Be the first to write one.