See Now More · 和 DSH 聊天,也跟它开着一路视频
像在 QQ 里点了视频通话:那一路画面是你的屏幕,那一路声音是你的音箱; 消息发出去就插队 —— 它还在思考,下一步也会接住你这句话。
包名
dsh-see-now-more,仓库 nacivageer/dsh-see-now-more。dsh-see-now回答的是**「多久看一次」——采样间隔、变化分、档位。这一仓补的是它没回答的那半句: 「什么时候该看、什么时候该听」。聊天窗、悬浮窗是这条判断的外壳(也是日常在用的大半), 听觉是它的输入。本体是黑听抬头**:默认只听,听到值得抬眼的内容才抬头看一眼,看完自己收回去。 上游把这件事交给参数,这里把判断权拿回来——这是它能叫more的唯一理由。 不是一键安装——没有发布到 npm,只能从源码装,面向 DSH 桌面版用户和愿意读代码的人。
- 聊天:气泡、历史、收藏、送达回执、收起就是通知
- 通话:共享屏幕 + 系统声音;它看得见画面、听得见声音,用
say说话 - 常驻:这通电话不用挂,它自己会醒、也会自己收工
- 入口:标题栏左上角一个按钮,窗没起就拉起、藏了就显示出来(不用先让模型调工具)
see-now 只命名了通话里的一路画面 —— 是地基之一,不是整栋楼的名字(两个上游详见下面「维护状态与上游关系」)。
静止的屏幕几乎不花钱;一镜到底的视频按"运动量"给帧;硬切幻灯片每切一次留一帧。
维护状态与上游关系
- 自用为主:从上游安装产物拷出来的本地分支,按自己的习惯改;改动记录见 CHANGELOG.md(开发期逐条记,比较啰嗦)。
- 本仓:nacivageer/dsh-see-now-more。包名
dsh-see-now-more是为了不和 npm 上的上游撞车。 - 上游两个:采样内核 dsh-see-now,悬浮窗
dsh-watch-together(examples/floating-chat/由scripts/sync-window.mjs生成),同样 Apache-2.0。 - 为什么还叫 see-now:机制仍在同一套框架里——取图、听觉、窗口都长在 see-now 这套底座上,变的是采样依据(「多久看一次」→「什么时候该看」)。前缀是在描述这层关系,不是在宣布归属:哪天机制不再共用这条管线,名字就该换掉。下游另起名字独立做自己的也很常见;这里没走那条路,是因为机制确实还长在这条管线上——改名不是态度问题,是结构问题。
- 跟官方的当前关系:不是官方版本。上游已在它的 README 里挂了本仓(「下游项目」一节,写明「不是本仓库维护的,问题请提到它自己的 issue」);本仓不自动跟进上游更新,本地改动不保证能合回去。若上游采纳这条路,机制按策略层做,能回流;否则按独立实验线继续。
- 承诺边界:脚手架不承诺——够用即停更。机制(黑听抬头)才是要交付的东西,会按可挂载的接口做,接口尽量别随手改。
- 别跑生成链:
npm run sync:window会用上游覆盖window.py,而这里对它改动很大。
它往哪走:黑听抬头
这一仓和上游的差别不只在界面,而在采样依据:
- 上游的取舍是把间隔拉长——省 token,丢的是「你不知道错过的那十几秒里有什么」;
- 这里的取舍是把采样依据换掉——声音是全程在线的廉价传感器,用台词在语义上触发取图。省下来的不是信息,是无意义的取图。
可检验的说法:每个触发点取到的帧,时间戳要和那句话对得上(偏差 ≤1 秒);从台词落盘到模型收到唤醒 ≤2 秒。不该触发的时段,一张图都不取。
架构上它是策略层,核心取图管线不改。这样它既能回流上游(如果上游要),也能脱离这条取图管线单独存在。
现在这个判断大半还在你手里 —— 你说「慢一点」才换节奏,你不提它就只看。方向是让它自己判,分四档:
| 档 | 做什么 | 代价 |
|---|---|---|
| 警觉 | 只记一笔「我听见了什么」,不取画面 | 0 token |
| 瞥(默认) | 取 1 帧看一眼 | 一张图 |
| 看 | 直接叫醒模型 | 一轮对话 |
| 追 | 连续看(游戏、直播) | 按节奏 |
默认是「瞥」:平时黑听,攒够了才抬头。
标题栏入口、悬浮窗、pace 都是功能本身 —— 悬浮窗有它自己的一条线,见下一节。
现在怎么落地的:警觉只记账(lift.jsonl 一行,不取帧、不叫醒);瞥取「那句话那一刻」的一帧、
在窗里落一行(不叫醒);只有最近 5 分钟里有人跟它说过话(或模型刚回合过),才升级成「看」——
叫醒模型,唤醒里带那句话的 t0,模型可以 see_now({action:"lift", since}) 取回那一刻的画面。
缓冲里滑走了就明说没了,不拿当前画面顶。抬头之后 15 秒没人说话、画面也不动,自己回落到警觉。
隐私边界(请务必读这条):黑听 = 屏幕仍在被 0.5 fps 低频采集 —— 最近 30 秒在内存里滚动, 不落盘、不进上下文、不花 token。但「瞥」到的那一帧会落盘保留 3 天 (
~/.dsh/see-now/lift/<日期>/),因为你要能回看那一帧。 另外lift/debug.log会记诊断账:心跳、扫描计数、叫醒结果,以及有整句却没命中时那两句的前 40 字 —— 不写这一行的话,「它怎么没反应」只能靠猜。命中句本来就进lift.jsonl。两份都只在本机。see-now.json写{"lift":{"enabled":false}}一键全关;关掉后与没有这个功能完全一样。
悬浮窗:一个轻量化的 DSH
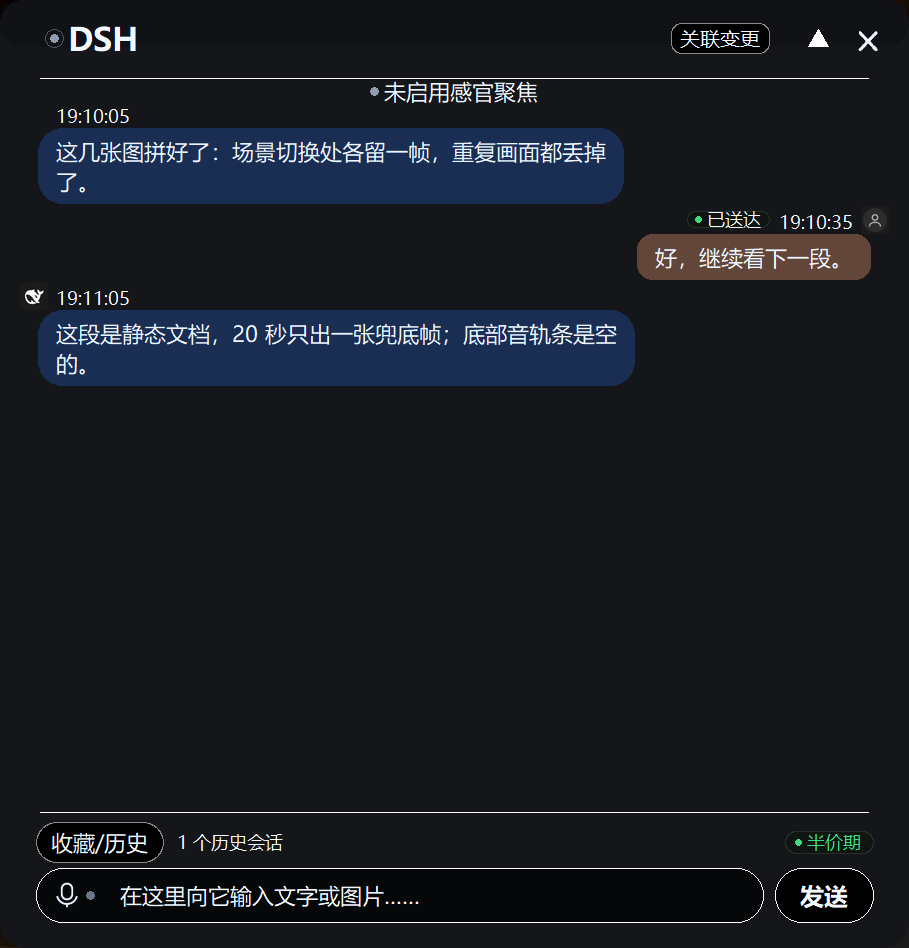
悬浮窗不是「看屏幕的显示器」,也不是视觉/听觉的附属面板。它的方向是长成一个轻量化的 DSH: 不切窗口、不找会话,在屏幕边上就能把话说完、把结论看到、把人叫住。
气泡上最值得一提的,是长思考中途的汇报。 一轮跑很久的时候,等它结束,结论是一坨一起掉下来的,
你只能在事后说「不是这个意思」。现在可以在思考中途就把阶段性结论发进气泡 ——
say 在任何一次 see_now 调用里都会进窗、会念出来,不必等这一轮结束。你看到「我准备按 A 做,
因为 B」,就可以当场插话把方向掰回来,而不是等它写完再推翻。
两条设计是配套的:
- 窗里的对话就是那个绑定的会话:在窗里打字走
steer进当前回合(前提是它真的在跑, 空闲时会另起一轮),不是另开一段聊天; - 气泡下面那行灰字会显示「运行中 / 已完成,用时 X」,配合中途汇报才看得出「它现在到哪一步了」。
「什么时候该说」仍然由模型自己判断,插件不强制 —— 它不会每一轮都汇报。
适用范围与验证状态
只在 Windows 10 + DSH 桌面版 0.2.2-rc.1 上开发和验证过。 其它组合请当作未验证,不要按“应该能用”来预期:
| 项 | 状态 |
|---|---|
| 操作系统 | Windows 10 —— 文档里的所有实测都在这一台上做的。Windows 11 用的是同一套 ddagrab / gdigrab,但没有专门验,可能能跑。 |
| DSH 版本 | 0.2.2-rc.1(2026-11 的 desktop 包)。插件依赖 DSH 内部的 sessionController / tools / attachments 服务,还直接读 ~/.dsh/sessions 的目录格式;升级 DSH 后坏掉是正常预期。 |
| macOS / Linux | 没验证。代码里有 avfoundation / x11grab 分支,但这次发布不承诺可用。 |
| 麦克风输入 | 完全没测过。 examples/floating-chat/mic.py 和浮窗里的「麦」按钮是上游带进来的;开发期没有可用的麦克风环境,不知道它能不能用。 |
| 系统声音(听声音) | Windows 上验证过,走 WASAPI 回环,抓的是“电脑在放什么”,不是麦克风。 |
麦克风这条路的未知状态不会被
status报出来:status只覆盖窗口 / 循环 / 听声音,不覆盖麦克风。
它读哪些本地文件
屏幕和声音只在本地处理。下面这些是它会读/写的路径,列出来方便你核对:
| 路径 | 用途 | 读写 |
|---|---|---|
~/.dsh/see-now.json |
节奏、模式、绑定会话等偏好 | 读 + 写(切模式/改绑定时) |
~/.dsh/see-now/ |
运行数据:chat.jsonl(窗里对话)、delivered.jsonl / relay-delivered.json(投递回执与去重)、missed.jsonl、focus.json、turn-state.json、region.json、images/(粘贴的图)、audio/(听声音的分句 wav)、relay.log、plugin-error.log |
读写 |
~/.dsh/see-now/lift/<日期>/ |
黑听抬头:log.jsonl(一条命中一行)+ 「瞥」到的那一帧 PNG(只留 3 天) |
读 + 写 |
~/.dsh/sessions/ |
悬浮窗显示会话标题与历史列表 | 只读 |
~/.dsh/asr.json / voice.json / tts.json |
转写、TTS 适配器配置(里面可能有你自己的 key) | 只读 |
%APPDATA%\@deepseek-ai\dsh-desktop\Network\Cookies(Windows) |
只查 dsh-auth-* cookie 的条数,用于提醒 cookie 过多会让 DSH 启动失败;不读 cookie 值、不导出 |
只读 |
- 不上传。 没有遥测、没有分析服务;帧在本地采集、打分、拼图,只有你主动调
watch/scene时,拼好的图才作为附件交给宿主模型。 - 屏幕与系统声音:抓的是当前屏幕和系统输出,可能包含任何正在显示/播放的内容;权限和边界由你和操作系统决定。
- 麦克风(未验证):如果启用
mic.py,它会录麦克风并做本地转写;这条路径没有测过。
授权说明 / License
Apache License 2.0 —— 随便用。个人、公司内部、闭源产品、SaaS、二次分发都可以, 不需要问我要授权,也不收费。只要保留 LICENSE 和 NOTICE 这两份文件。
提交 PR 前读一下 CONTRIBUTING.md —— 现在不需要签 CLA 了, 按 Apache-2.0 的规矩来就行。
看看它长什么样
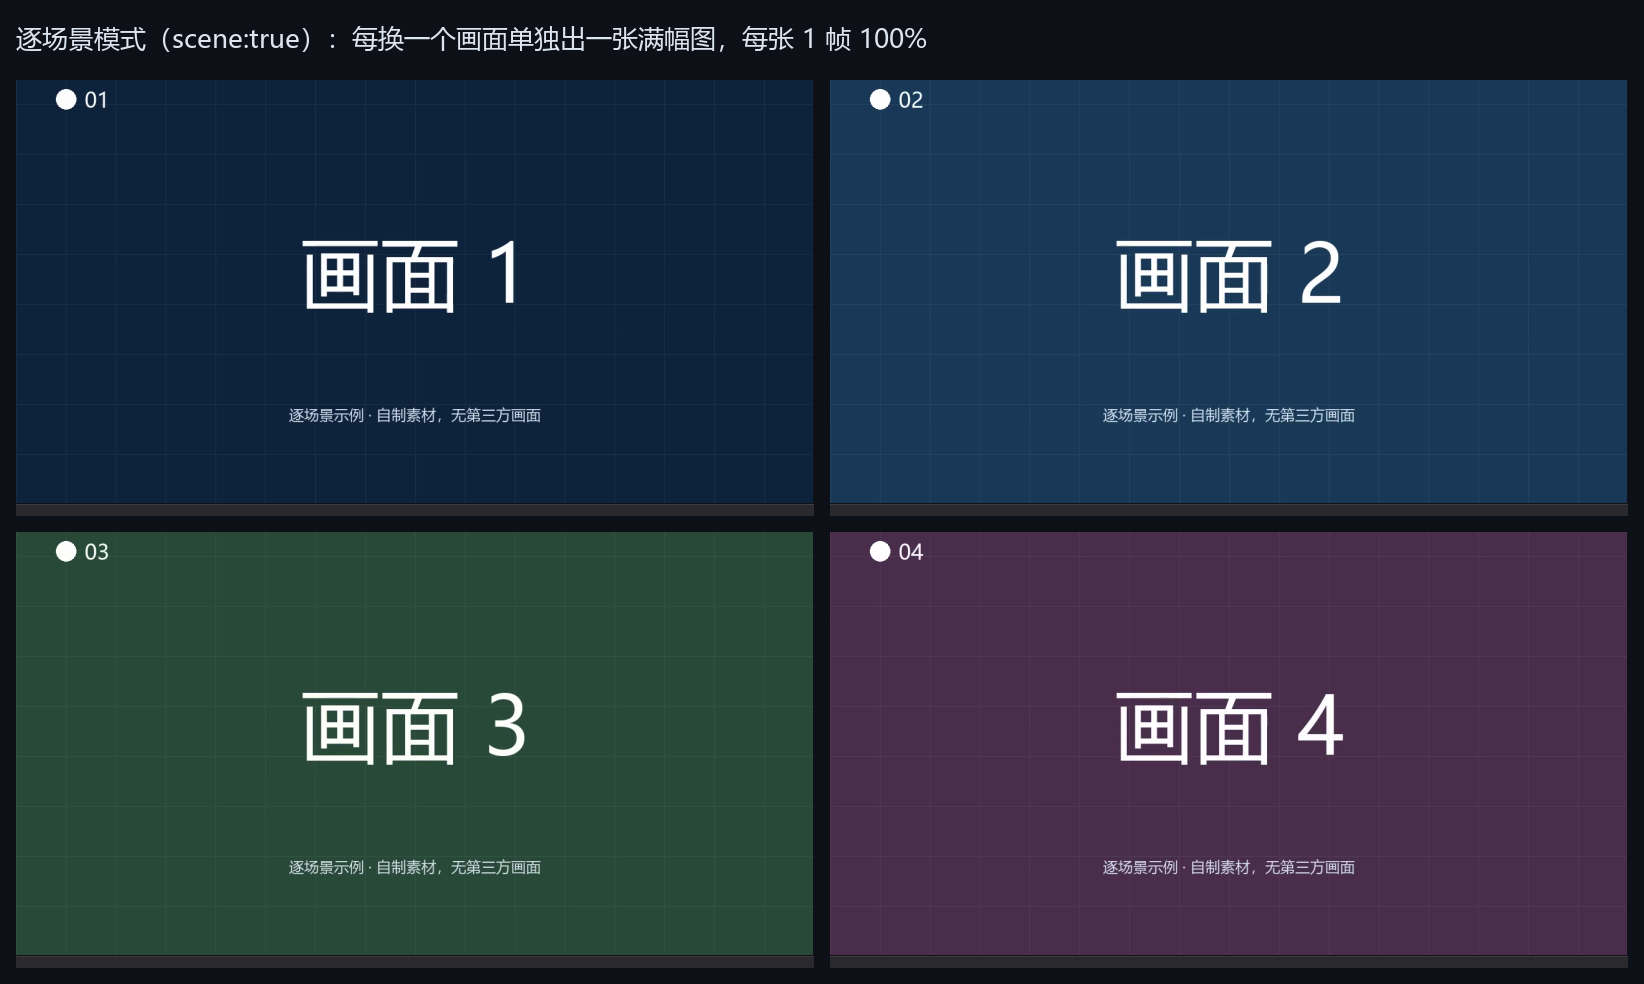
逐场景模式(scene:true):每换一次画面单独出一张满幅图,每张 1 帧、100% 占比。下面是连续 4 张出图(合成素材,只用于展示排版):
悬浮窗:AI 说的话在这里出现并被念出来(say 是唯一通道)。
它解决什么问题
想让 AI 陪你看屏幕,最直觉的做法是"定时截全屏喂过去"。两个死结:
| 做法 | 问题 |
|---|---|
| 每 2 秒截一张全屏 | 一分钟 30 张图,全是重复画面,token 直接烧穿 |
| 每隔 30 秒截一张 | 中间发生了什么全丢了,AI 只会说"看起来你在用电脑" |
See Now 换了个思路:先判断这一帧值不值得看,再决定传不传。
- 每个画面帧先打一个 0–255 的"变化分"(HSV 三通道加权差,在 64×36 网格上算,约 0.2ms)
- 只有"画面突然换了一张"或"一直在动、攒够了量"才留下来
- 留下来的几帧拼进同一张图,一张图的固定成本摊到 4~8 帧上
结果:同样一段 30 秒的操作,别人烧 30 张图,这里常常只要 2~3 张。
有多省
| 场景 | 表现 |
|---|---|
| 静止屏幕(看文档、发呆) | 几乎不出图。20 秒给一张兜底帧,让你知道"确实没变" |
| 滚网页、切窗口 | 变化剧烈 → 留几帧 → 每 15 秒左右给你一张 |
| 一镜到底的视频 | 没有切点,靠"积分"攒够一个采样点才出帧 |
| 硬切幻灯片(每张停 2 秒) | 每切一次留一帧,6 张照片 → 6 帧 |
成本口径(按宿主 DeepSeek-V4 的 patch 网格算:14px patch 向上对齐 → 42px 一格 → rows×(cols+1)+2):
| 档位 | 画布(画面 + 音轨条) | 每张 token |
|---|---|---|
low(默认) |
798×450 + 12px = 798×462 | 222 |
standard |
1050×600 + 30px = 1050×630 | 392 |
high |
1260×720 + 36px = 1260×756 | 560 |
ultra |
1596×900 + 24px = 1596×924 | 860 |
一张图里塞 4 帧还是 8 帧,价格一样 —— 所以"多留一帧"几乎免费,"漏掉一帧"才贵。
宽度故意不对齐 16:9,而是对齐 42(800→798、1066→1050、1280→1260、1600→1596): 800 会被 pad 到 812 = 19.3 格,白算一整列;798 正好 19 列,面积只少 0.25%,每张省 11~24 token。 这是整个链路里唯一零代价的降本点(storyboard 那边也是这么干的)。
音轨条不额外花钱:token 是按 42px 一行算的阶梯函数,450 高的画面占 11 行、上界 462 —— 底下空着 12px 也照样收 11 行的钱。条就用这 12px(其余档位同理:600 余 30、720 余 36、900 余 24)。 所以"加条"和"不加条"的 token 完全一样,关掉它只是图干净一点,省不到钱。
快速开始
不是一键安装,也不是全平台承诺。 本包没有发布到 npm,只提供源码安装;只保证 Windows 10 + DSH
0.2.2-rc.1(见上面「适用范围与验证状态」)。让 AI 照着装:把 INSTALL.md 指给它——那份是给机器读的安装单,含前置检查、期望输出和失败分支。
在 DSH 里用
npm 上那个 dsh-see-now 是上游,dsh plugin add dsh-see-now 装的也是上游,不含这里的聊天窗、插队、历史和收藏。本包 dsh-see-now-more 没发 npm,只能用源码安装:
git clone https://github.com/nacivageer/dsh-see-now-more.git
cd dsh-see-now-more
node scripts/install-dev.mjs      # 复制进本机 DSH 的 desktop profile
- 默认装进
desktopprofile;装到别的 profile 就设DSH_PROFILE=web(该 profile 要先初始化)。 - 装完重启 DSH 生效(插件树在进程启动时组合)。
- 重启之后不用新开会话:工具表是每一步重新组装的,旧会话下一轮就能看到
see_now(宿主还会插一条tool-addition告诉模型多了这个工具)。所以「工具表在会话开头就定死了」 不成立 —— 挂不上多半是没重启,或者装的是旧副本。 - 卸载:
node scripts/install-dev.mjs --remove - 升级:
git pull后再跑一次node scripts/install-dev.mjs - 从旧 fork 升级:旧包叫
dsh-see-now,和本包提供同一个see_now工具。装本包前先跑node scripts/install-dev.mjs --remove-legacy清掉旧包,否则两个插件会打架;install-dev的 输出里也会提示这一点。 install-dev是复制不是软链(Node 解析裸包名要走真实路径,软链会找不到宿主的@deepseek-ai/dsh-tools)。所以克隆目录不能删,删了 profile 里的file:依赖会坏。
关掉悬浮窗之后想再打开:点 × 只是这一次不看,插件不会自己弹回来。手动叫:
node bin/see-window.mjs            # 开窗(已经开着就什么都不做)
node bin/see-window.mjs --status   # 只看它在不在
node bin/see-window.mjs --force    # 杀掉重开
node bin/see-window.mjs --close    # 关掉
npx dsh-see-window只有发布到 npm 后才可用;本仓没发,请用上面的node bin/...。
平台
| 平台 | 屏幕引擎 | 状态 |
|---|---|---|
| Windows 10 | ddagrab,不行退 gdigrab(自动探测) |
验证过(本文档所有实测都在这上面) |
| Windows 11 | 同上 | 未专门验证 |
| macOS | avfoundation |
未验证,不承诺可用;另外要系统设置 → 隐私与安全性 → 屏幕录制 勾上跑 DSH 的 App |
| Linux | — | 没接(要补 x11grab / PipeWire) |
ffmpeg 不用进 PATH:插件会按 DSH_FFMPEG_PATH / FFMPEG_PATH / DSH_FFMPEG_DIR /
~/.dsh/tools/ffmpeg/bin / ~/.dsh/bin 的顺序自己找(DSH 桌面版把 ffmpeg 装在第四个位置)。
然后让模型调:
see_now({ action: "watch" })          // 阻塞到你攒够一张图,然后把图交回来
see_now({ action: "watch", say: "…" }) // 同时说一句话(只有 say 会进悬浮窗、会被念出来)
第一次调用约 1 秒返回当前屏幕;之后每次返回"这段时间里发生的事"。
不进 DSH,当普通 Node 库用
包本身不依赖 DSH,capture / pipeline / png 都是独立导出的:
import { spawnFrames } from 'dsh-see-now-more/capture';
import { createPipeline } from 'dsh-see-now-more/pipeline';

const p = createPipeline({ width: 800, height: 450, fps: 12, queueDepth: 0 });
const run = spawnFrames({
  source: { kind: 'screen' },           // 或 { kind:'file', path:'x.mp4' }
  width: 800, height: 450, fps: 12,
  onFrame: (f) => p.push(f),
});

setInterval(() => {
  const sheet = p.take();               // 一张 PNG + 每帧的时间戳/档位/来源
  if (sheet) require('fs').writeFileSync(`sheet-${sheet.at}.png`, sheet.png);
}, 200);
声音
核心不内置任何 TTS 引擎,只 dynamic import 一个你指定的模块。配好之后,
say 会进悬浮窗并且被念出来;普通回复永远只有字。
// ~/.dsh/voice.json
{ "adapter": "/绝对路径/examples/voice-say-mac.mjs" }
自定义模型:适配器自己的配置走 options,原样交给 attach(api, options) ——
换自己训的模型不用改适配器源码:
// ~/.dsh/voice.json
{ "adapter": "D:/my-voice/index.mjs", "options": { "model": "D:/my/models/xxx" } }
macOS 自带一个:examples/voice-say-mac.mjs,走系统的 say,音色和语速从
~/.dsh/tts.json 读(和 dsh-watch-together 共用同一份):
// ~/.dsh/tts.json
{ "voice": "Tingting", "rate": 185 }
say -v '?' | grep zh_ 可以列出本机所有中文音色(Tingting / Meijia / Sinji / Reed / Rocko…)。
改完不用重启:每次调用工具前都会比对一次配置指纹(适配器路径 + tts.json 内容摘要),
变了就自动卸载重挂,没变就一次读文件的开销。所以改音色、换适配器,下一句就生效。
适配器要自己处理两件事:串行(两个
say抢音频设备会像结巴)和spoken上报 (在出声的那一瞬发,不能等念完 —— 展示层是"字跟着声音走"的)。
听声音(视频里在说什么)
上一节是它说给你听,这一节是它听你在看的东西。
图只能说明画面,说明不了"他们在说什么"。开着这个之后,see_now 的清单里会多一段
台词,时间码和每帧那个 24.1s 是同一个坐标系 —— 模型能把一句话对到某一格画面上。
过去 24.1–45.6 秒的 4 个画面 · 798×462
  1. 24.1s · 400×225 · cut · 2 档
  ...
台词(这段时间里视频里在说的,机器转写,可能有错字/听岔):
  24.4s  评价一个镜头的好坏,一般来说有两个维度
  31.2s  第二个维度是艺术维度
要什么:一条 WASAPI 回环(抓的是"电脑正在放什么",不是麦克风)+ 一个转写服务。
- 转写:DSH 桌面版自带
speechToText(SenseVoice),不用配任何东西; 命令行/其他宿主就在~/.dsh/asr.json里指一个 OpenAI 兼容服务 (和dsh-video-storyboard共用同一份配置):{ "baseUrl": "http://127.0.0.1:8000/v1", "key": "local-key", "model": "paraformer-zh-2024-03-09" } - 抓声音:
pip install pyaudiowpatch numpy。不需要装虚拟声卡,也不需要开"立体声混音"。 装到哪个解释器都行,插件会自己找;找不到就把它写进~/.dsh/see-window.json:{ "listenPython": "C:/Python313/python.exe" }
开销(i9-12900HX,实测):抓回环 0.3% 单核,转写 3 秒段 130–160ms。 跟画面采集(0.18–0.43 核)比是零头。
延迟("这句话说完" → "模型能读到它"):
| 环节 | 耗时 | 说明 |
|---|---|---|
| 静音判定 | 350ms | 要等这么久才确认"说完了" |
| 写盘 + 扫目录 | 5ms + 平均 50ms | pollMs=100,Python 是写完 .tmp 再 rename,读不到半截 |
| 转写 | 100–180ms | 实测 1.0 秒段 99ms、3.0 秒段 174ms(本地 paraformer,单线程,加并发没用) |
| 合计 | 约 0.6 秒 | 从最后一个字到文字可用 |
长句不等断句:连续说话时 --max-seg(3 秒)才会强切,这 3 秒里一个字都出不来。
所以现在说满 1.8 秒就先转一版(live-<t0>.wav,同名覆盖),整句落盘后再覆盖它 ——
真机实测首版字幕从 3.30 秒提前到 2.08 秒。临时版在台词里标「还在说…」,
整句永远盖过快照(迟到的快照改不回去)。
还有一段不归 ASR 管:一张图覆盖 15 秒(maxWaitSec),第 3 秒说的话要等第 15 秒出图时
才随图交付 —— 平均 7.5 秒。要更跟得上画面就压 maxWaitSec 或用 pace:"dense",
代价是 token 按比例涨。watch 返回前还会等最多 300ms(listener.settle),
把"差几百毫秒没转完、会被推到下一张"的那句捞回来。
要更快就把 listen.pollMs 调小(最低 50,再低只是空转),
或者把 listen.silence 从 0.35 再降到 0.25 —— 代价是句子更容易被切成两半。
这些参数都在 ~/.dsh/see-now.json 的 listen 段,改完重开 DSH。
图上长出了音轨条:图底下多一条带子(默认档 12px 高),画响度柱、静音灰块和切点刻度 ——
配色和 dsh-video-storyboard 一样。数据不用重新解码一遍音频:listen.py 断句时已经在算 RMS,
顺手按 0.1 秒一格记下来(levels.json),画的时候直接取。
它不额外花 token:条高取的是画面占行后剩下的余量(450 余 12),总高 462 仍在 11 行里。
台词的时间码给两个:15:57:32 / 9.3s —— 前面是本机时钟(回头对"当时几点"用),
后面是相对这张图起点的秒数(和每格画面同一个坐标系)。
没有或不想用:DSH_SEE_AUDIO=0 关掉;或者干脆不装那个 Python 包。
两种情况都只是没有字幕,看图一切照旧 —— status 里的「听声音」那一行会直说是
缺服务、缺包、还是这台机器抓不到回环:
听声音:在听(宿主 SenseVoice,累计 42 句,最近一句 3s 前)
听声音:没在听 —— 没有能用的 Python(要 pip install pyaudiowpatch numpy)
已知限制:
- 只有 Windows。macOS 抓系统声音要装 BlackHole 之类的虚拟声卡(而且要手动配置多输出设备), 这一版没做 —— 在 mac 上「听声音」会直接报"抓不到回环",其余功能正常。
- 抓的是整个系统的输出,不只是视频:QQ 提示音、BGM、游戏音效都会进台词。 视频里没人在说话时,转写多半是空的(服务端有 VAD),偶尔会对着音乐吐出几句幻觉歌词。
- 它听得见自己:TTS 念台词时音箱会出声,那段会被回环收回去。所以落盘前查
quiet-until.json(和mic.py共用),念的时候整段丢弃 —— 否则 AI 会把自己的话 当成"视频里说的",然后接着聊下去。 - 转写是机器识别,同音字会错("技术维" / "技术为")。模型被明确要求不要把它当原文引用。
参数
| 参数 | 说明 |
|---|---|
action |
watch(默认,阻塞取图)/ peek / start / stop / status / window / region |
show |
配 action:"window":true 把悬浮窗叫回来,false 藏起来,不传只报状态 |
region |
只看屏幕上一块:"x,y,w,h"(屏幕物理像素),或 "off" 取消。一般不用手填 —— 说"框这块"让它自己框,见下 |
say |
唯一能进悬浮窗、能被念出来的通道。普通回复不进气泡,但会被记进小窗的对话记录 |
quality |
low(800×450) / standard / high / ultra。改它会重启采集(~0.6s),并立刻返回当前这一帧 |
pace |
节奏:calm / normal(默认)/ dense。见下 |
scene |
true = 逐场景模式:一张图只装一个画面、铺满。见下 |
seconds |
watch 的阻塞上限(默认 300,封顶 860)。只是上限,攒够一张就提前返回 |
minFrames |
少于这么多帧的图就别给我了(省 token) |
source / path / realtime |
采集源:屏幕 / 摄像头 / 回放一个视频文件 |
只看一块(region / action:"region")
只想让它盯住屏幕上的一个窗口(手机竖屏通话、播放器的画面、某个聊天窗口)时,
不用自己量像素:说一句"框这块",模型会调 see_now({action:"region"}),
屏幕变暗后拖一个框,松手就行。坐标存在 ~/.dsh/see-now/region.json,
之后每次 watch 默认只看这块,region:"off" 取消。
三条边界(插件会如实告诉模型,模型也该如实转述):
- 抓的是屏幕上正在显示的像素:这块被别的窗口挡住,看到的就是挡住它的那个窗口;
- 默认不接 OBS,所以抓不到后台窗口、最小化的窗口。想让 OBS 出力(或者在没有物理屏的机器上抓),
用
source: { kind: "obs" }或{ kind: "camera", device: "..." },走 dshow 设备; - 只支持主屏(负坐标表达不了,gdigrab 也不接受)。
设备名带空格(
OBS Virtual Camera)时如果报input url video=OBS这类"名字被截断"的错, 把它换成 DirectShow 里的无空格备用名(@device_sw_{...}\{...},在 ffmpeg 的-list_devices输出里能看到)传给device。
带上区域后出图规则也变了:按区域宽高比出图(竖屏就出竖屏)、每帧长边固定 = 档位长边、 一张默认 2 帧最多 4 帧。token 会比全屏贵(帧不再被缩小):low 档 2 帧约 345 token。
三档节奏(pace)
| 档 | 换画面门槛 | 最多多久叫醒一次 | 适合 |
|---|---|---|---|
calm |
20 分 | 30 秒 | 日常挂着,只想知道"大场面变了没" |
normal(默认) |
12 分 | 15 秒 | 滚网页、切窗口不会每下都留帧 |
dense |
7 分 | 8 秒 | 幻灯片、逐帧播报 —— 贵,别常开 |
觉得它太吵、太烧钱,就说一句「慢一点 / 省点钱」,模型会传
pace:"calm"。 觉得它漏了、迟钝,就说「不灵敏」,它会传dense。
逐场景模式(scene)
打开后每换一次画面单独给你一张满幅图,并且每换一次就叫你一次 —— 用来做"每翻一页说一句这是什么"。
see_now({ scene: true, say: "好,接下来每换一个画面我就说一句" })
它是粘性的,一直生效到 scene:false 或停止。
单帧铺满靠的是 strategy: 'single'(档位固定压到 1),不然场景一密,格子会缩到 1/4、1/9,中间全是灰条。
自己的节奏:~/.dsh/see-now.json
有三件事是"每次会话都一样的偏好",不该让模型每次传参:多久自己收工、
默认用哪一档节奏。写进这个文件(改完重开 DSH 生效,不进 profile,
dsh plugin update 不会覆盖):
{
  "maxAutonomousWakes": 24,
  "idleStopMin": 10,
  "defaultPace": "calm",
  "speechPacing": true,
  "showPriceChip": true
}
| 字段 | 默认 | 说明 |
|---|---|---|
maxAutonomousWakes |
8 | 连续这么多次自动叫醒都没人理 → 收工。悬浮窗开着时,这条就是实际的最长陪看时长(normal 15 秒一次 ≈ 2 分钟)。1–200 |
idleStopMin |
3 | 没开悬浮窗时,用户这么久没说话 → 收工。0 = 关掉这条 |
defaultPace |
normal |
新会话/重开采集时的默认节奏:calm / normal / dense / game-economic。调用里显式传 pace 仍然优先 |
speechPacing |
true |
按上一句的估计时长排下一轮(中文约 5 字/秒)。"guard" = 只在长句时推迟、不比旧节奏密;false = 退回固定间隔 |
showPriceChip |
true |
悬浮窗底栏的「高峰期 / 半价期」标签;false 关掉。它由 window.py 自己算,不依赖 dsh-price-period(那个是 DSH 标题栏的独立插件) |
为什么要 speechPacing:固定间隔是从"叫醒那一刻"起算的(calm 30s / normal 15s / dense 8s / 逐场景 4s),
跟上一句说了多久没关系。现在默认改成跟随上一句:上一句 3 秒,下一轮最早 3.8 秒后(有 3 秒地板,防连珠炮);
上一句 12 秒,就顺到 12.8 秒。想保持旧节奏就写 "guard"(取旧间隔和"说完+气口"里更晚的那个),
写 false 完全关掉。用户插话不受限制。
估时长只看文本,误差约 ±20%(不同引擎/语速),目的是"跟住嘴",不需要精确。
see_now({action:"status"}) 的循环行会显示 上一句约 X.Xs、下一轮最早 Ns 后。
see_now({action:"status"}) 的「收工线」那一行会显示当前生效的值,
改过配置会带上文件路径 —— 否则"怎么陪一会儿就自己停了"很难查。
非法值会退回默认并在日志里留一条 warning,不会把插件弄挂。
它是怎么判断"变了"的
两条判据,缺一不可:
① 切点 —— 这一帧的分数跳得又高又孤立
score ≥ cutAbs(12)                 // 绝对地板:变化够不够大
score > 2.5 × max(1, 前后帧)        // 尖峰:是不是"一下子"
mc ≥ cutSpikeMcAbs(20)             // 尖峰也要有 mc 覆盖,防过渡帧先切
距上一刀 ≥ 0.4 秒                   // 不应期

// 补充出口(相机/机位场景)
score ≥ 6 && mc ≥ 60               // 运动补偿:整屏在动但邻域匹配不上 = 换镜头
score ≥ 80 && 跳 ≥ 12 && ≥ 1.5×邻居  // 强台阶:兜住 mc 关掉的配置
6 ≤ score < 12 && score > 3×邻居 && mc ≥ 8 && 包围盒 ≥ 20 && 填充率 ≥ 0.2  // 相似构图:压缩块,不是稀疏 UI 条
mc 是运动补偿后的"变了多少格"占比(0–255),搜索半径默认 4 格: 整屏平移 8 格时 radius=2 会误报 194,radius=4 只有 5;换镜头则两边都高。 B 站游戏片里 30.33s 的切机位只有 23.2 分,但 mc=121,靠这条能留下。
前景运动(手、勺子、遮挡物)也会让 mc 变高,所以低/中分切点再加一道背景模型:
最近 6 帧里一直没怎么动的格子算稳定背景;如果当前帧只改掉一部分稳定背景
(bg < cutBgAbs=100),绝对变化格数不超过 cutBgMaxChanged=600,
且变化区域没盖满高度(mcSpanY < 0.85),
就按前景运动处理,不切。真正换镜头会把稳定背景整片换掉,或至少盖满画面高度。
宽银幕的上下黑边不计入这个高度(contentHeightRatio 归一),否则 Sintel 这类
letterbox 片子的正常切点会被误挡。全黑帧仍按 0 跳过;暗场上下发黑、中间有亮内容时
改用 guardHeightRatio,不再因为边缘暗就跳过守卫。
高分候选(score ≥ 60)再等 0.5 秒做一次未来帧确认:用最近 24 帧的参考背景
看候选帧改掉的部分有没有回来。手/勺子离开后画面回到旧背景,就不切;真正换镜头
在新场景里稳定下来,仍然切。这项确认只作用于高分候选,低/中分仍走当前帧守卫。
前景停住超过 0.5 秒时,未来帧不会回到旧背景,但外圈通常还是旧背景:
bgKeep 之外再看 bgBorderChanged,背景变化不到整片且外圈几乎没动时也判前景。
这条只在 bg < 220 且外圈 < 10 时生效,避免挡整屏换镜头的真切点。
外圈已经判成前景的候选不再等未来帧;真正的高分切点仍最多等 0.5 秒。
低/中分候选如果外圈也被改掉(border ≥ 60)、稳定背景很少(≤ 700)、
背景变化又不到整片(bg < 160),也等 0.5 秒做一次未来帧确认;
只有一部分旧背景回来(keep < 210)才判前景。这是在真实带货直播里
大手/产品盖住外圈时补的,静态外框的烹饪/开箱真剪不会被这条带走。
② 积分 —— 分不高但一直有,攒够才录一帧
need = 4分 × 12fps × 3秒 = 144      // 固定的绝对阈值,不跟着画面一起涨
每帧累加自己的分,累够就录、清零
为什么两个都要:尖峰是相对的,在低分区也会成立。实测缓慢放大(持续运动)有帧 s=13.6、前后邻居只有 1.1/1.3,尖峰判据完全放行 —— 没有绝对地板,它就会被切成一块块。
反过来只有地板也不行:一镜到底的视频每帧 4 分,永远不会"跳"。
调试窗
调试窗的源码不在本仓。它只是从外面驱动同一条流水线,不影响插件本身;要自己看帧流,直接读 src/pipeline.js 或加日志。
实测(Windows:i9-12900HX / RTX 4060 Laptop / 2560×1600)
采集开销(12fps → 800×450):
| 源 | 首帧 | CPU |
|---|---|---|
ddagrab(桌面复制 API) |
370ms | 0.28 核 |
gdigrab(GDI 抓屏) |
310ms | 0.45 核 |
| OBS 虚拟摄像头 | 575ms | 0.13 核 |
开发期记录(macOS:M 系列 / Retina,未在本次版本复验)
| 源 | 首帧 | CPU |
|---|---|---|
avfoundation 屏幕 |
~700ms | ~0.16 核 |
这段是开发早期留下的记录;本次发布只在 Windows 10 上验证过,mac 不构成可用性承诺。
首帧慢在 AVCaptureSession 冷启动(ffmpeg 进程本身 ~300ms),但稳态比 Windows 两种引擎都省。
像素格式是探针试出来的,不是写死的:屏幕输入不支持默认的 yuv420p,探针按 CPU 从省到费
(nv12 → uyvy422 → bgr0 → 设备默认)试到第一个真能出帧的,然后整个进程记住。
macOS 上有两个坑会伪装成"插件坏了",都写在
src/capture.js里: ①-framerate在 avfoundation 屏幕源上不压速(实测 30 帧只用 0.73 秒,≈40fps), 必须靠输出侧-r 12把速度压回来 —— 开发时少了这一条,管道被灌出过 240GB 的 raw 文件。 ② 没有「屏幕录制」权限时它不报错,exit 0、帧数正常,只是全黑。 探针会算平均像素,发现全黑就在start的返回里带一句提示,告诉你去系统设置里勾。
变化分刻度(0–255,同一套代码):
| 内容 | 分数 |
|---|---|
| 静止桌面 | 0.00(屏幕采集近似无损) |
| 光标在静止画面上移动 | 0.7 |
| 两张色调接近的照片切换 | 16~18 |
| 滚网页 / 切窗口 | 30~42 |
| 两张完全不同的照片切换 | 46~63 |
所以 cutAbs: 12 这个默认值的位置是:照片切换抓得住,光标和微小抖动碰不到。
目录
src/
  capture.js    唯一 spawn ffmpeg 的地方,一根 rawvideo 管道
  binaries.js   找 ffmpeg(DSH 桌面版不进 PATH,所以不能写裸命令)
  cuts.js       逐帧变化分(64×36 HSV 网格)
  pipeline.js   唯一有状态的地方:帧 → 打分 → 切点/积分 → 留帧 → 档位 → pack → 出图
  tiers.js      档位(格子边长 1/k)与策略
  pack.js       DP 装箱:把 N 个不同大小的格子铺满画布
  sheet.js      合成 PNG(烧帧号、留缝)
  runner.js     采集管线 + 阻塞取图 + 节奏
  listen.js     听声音:扫 wav → 转写(宿主/本地 HTTP)→ 台词缓冲 → 挂到图上
  loop.js       常驻循环:有新图就唤醒模型
  index.js      工具注册与路由
py/listen.py   抓系统回环 → 16k 单声道 → 按静音断句(听声音的 Python 侧,listen.js 起它)
examples/floating-chat/   悬浮窗(Tk)+ mic.py(麦克风)
test/                     单测(node --test;含版本号/插件名/CHANGELOG 一致性守卫)
已知限制
- 只认"画面变了",不认"语义变了"。同一句话的两个排版版本算变化,两段内容不同但长得很像的页面可能算没变。
- 没有跨帧去重(除了
dupMin那道粗筛)。它不保证给你的每一帧都"有新信息"。 - 前景外圈守卫有边界:外圈也被前景盖住、或背景变化
bg ≥ 220时挡不住; 反过来,真正切到"外圈固定、主体只在中部变"的近景,可能被这条误挡。 - 参考背景会被长期前景污染:24 帧里前景占多数时模型会漂;外圈守卫还能挡一部分, 整屏前景仍然要等它离开。
- 唤醒有节流:再密也不会超过
pace里的间隔 —— 语音播报是串行的,更快只会排队。 - 平台:只在 Windows 10 上验证过;Windows 11 和 macOS 没有专门验证,
Linux 还没接(要补
x11grab或 PipeWire,现在会直接报错,不假装能用)。 - macOS 要多给一次权限(未验证):系统设置 → 隐私与安全性 → 屏幕录制,勾上跑 DSH 的那个 App。 没给的时候不会报错,只会全黑 —— 插件会提示,但权限本身只能你去点。
- 麦克风输入没有验证过:
examples/floating-chat/mic.py和窗里的「麦」按钮来自上游, 开发期没有麦克风环境,不知道是否可用。公开的目的之一就是找有麦克风的人帮忙测—— 具体步骤和要贴的日志见 INSTALL.md; 它和「听声音」(系统回环)是两条独立的路。 它的默认模型目录是开发机的D:/asr-local/models-sherpa,换机器要传--models-dir(或改~/.dsh/asr.json的manage.start)。 - 听声音(台词)只有 Windows:靠 WASAPI 回环,mac 上要装 BlackHole 之类的虚拟声卡 再配多输出设备,这一版没做。mac 上「听声音」会直接报抓不到回环,画面功能照常。
- 区域模式只能看到前台像素:没有 OBS 之类的采集源,被遮挡 / 最小化的窗口抓不到。 抓屏整体失败时(锁屏、UAC 安全桌面、远程桌面)窗口会退成一块纯色底板, 字还能读,但背后不是真实画面。
协议
Apache License 2.0 —— 商用、闭源、再分发、改完再卖都可以,保留 LICENSE 与 NOTICE 即可。
examples/floating-chat/ 来自上游作者的另一个项目 dsh-watch-together,两边现在是同一个协议,
不再有"这个目录 Apache、其余非商业"的分裂。
Copyright © 2026 SAOS-3624(上游 dsh-see-now / dsh-watch-together)
本仓的修改与新增 © 2026 72NG
No comments yet. Be the first to write one.