READMESource: main@967626ec
dsh-plain-talk(说人话)
English · 中文


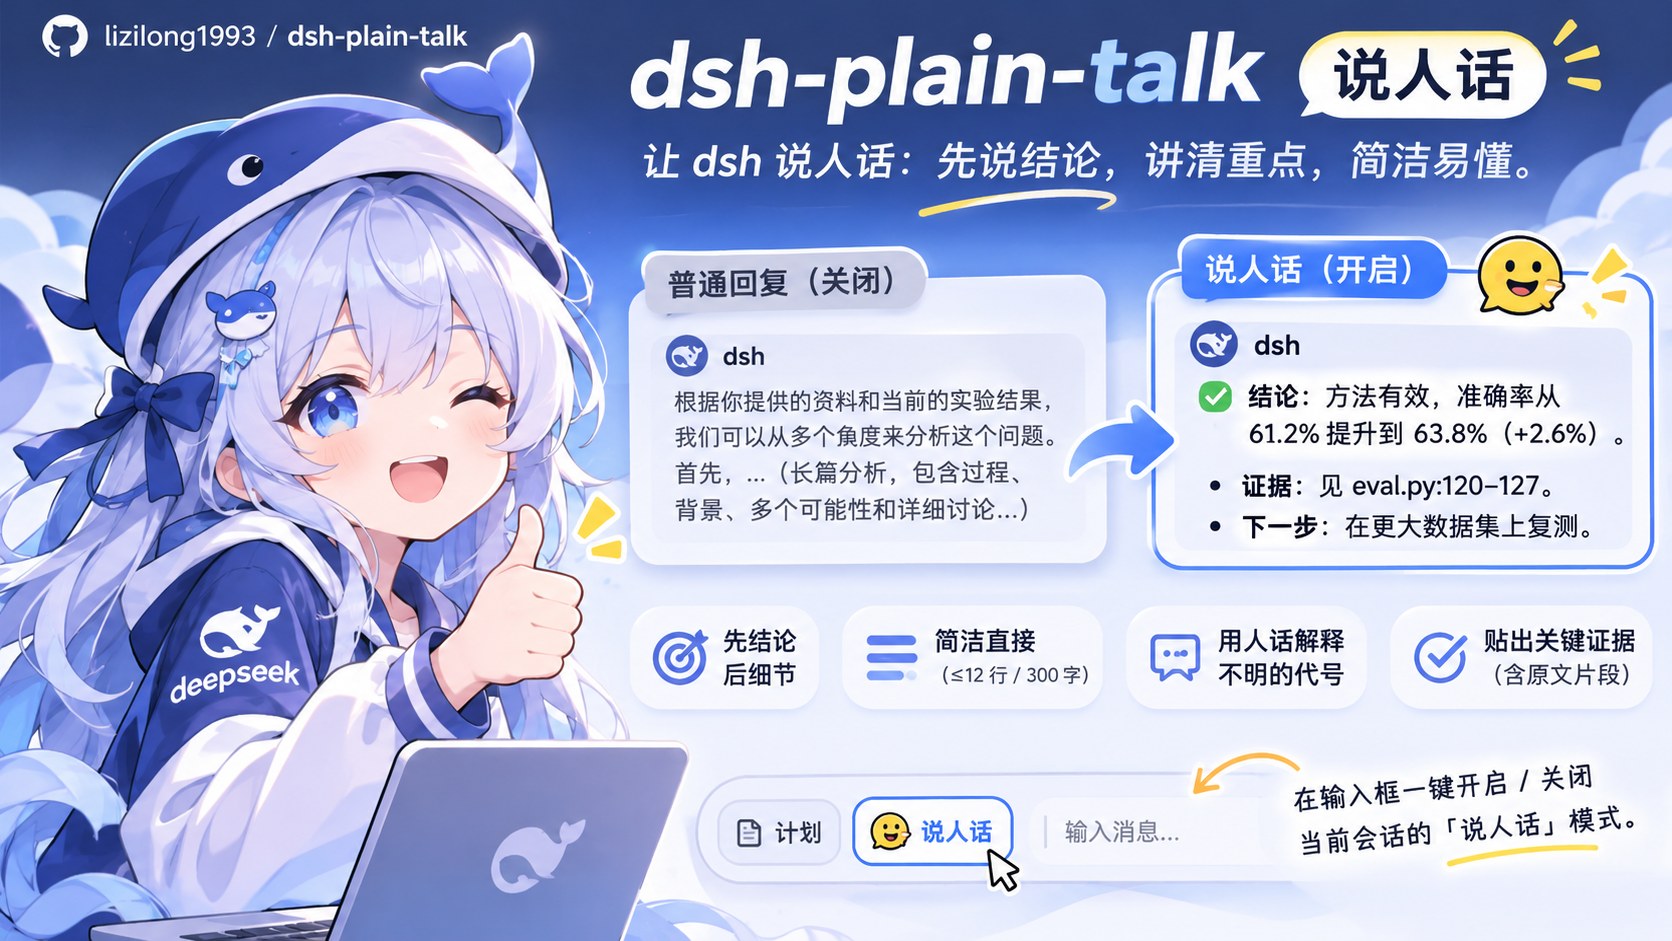
DeepSeek Harness 的回复优化插件:输入框里一个「说人话」开关。打开后,回复先给结论、默认不超过 12 行、引用直接贴原文、代号第一次出现时用一句人话解释,并记住你已经认识的词。
它做什么
- 结论先行:第一行就是答案或判定,不复述问题,不写"我来看看"。
- 默认短:≤12 行 / 300 字;你要求展开时才放开深度。
- 自包含:不用"上述 / 前面 / 上一轮";代号(EXP-7、DEV-1K、run-3)第一次出现写成
EXP-7(一句话说明)。 - 引用可读:给
文件:行号的同时贴出那几行原文。 - 词汇清单:你说过的词、项目名、常见术语默认已知;"调研 X"的第一轮仍会解释 X,回复交付后才记住。代号不进清单。
效果
测试环境:DeepSeek Harness desktop profile、headless 运行、模型 command code/deepseek-v4.1-flash(high),2026-11-04。同一提示词、同一工作区,只切换开关。
输出对比
| 场景 | 关闭 | 开启 |
|---|---|---|
| A1 建文件并验证 | 任务完成,产物都在 bench-demo/ 目录:- a.txt、b.txt、c.txt,内容分别是 A、B、C- check.mjs:按 a→b→c 顺序读取三个文件,去掉换行后拼接输出运行 node check.mjs,输出 ABC,退出码 0。 |
已达标:bench-demo 下四个文件已就位,运行脚本输出 ABC。- a.txt、b.txt、c.txt 各只有一行 A、B、C- check.mjs 按 a → b → c 顺序读取、拼接并打印,实测输出:ABC你自己确认:在 bench-demo 目录执行 node check.mjs,应看到一行 ABC。 |
| A2 写入并读回 | 已完成。 - 创建了 hello.txt,写入内容 Hello- 读回确认为 1 行,内容就是 Hello文件路径: <工作区>/hello.txt |
我在工作区根目录创建了 hello.txt,写入内容为 Hello:1: Hello文件路径: <工作区>/hello.txt |
| B1 为什么模型会忘事 | 多数人以为这只是“上下文窗口不够长”,其实窗口够长也会忘。一是截断与压缩:超过窗口的早期轮次会被滑窗丢弃,或者被系统摘要掉,原本的细节就没了。二是注意力是软检索,没有索引保证——候选内容越多,权重越被摊薄,而且位置偏差很明显(“lost in the middle”:开头和结尾记得住,中间段最容易被忽略)。三是位置编码在超长距离上外推能力下降,早期 token 与当前 token 的关联信号本来就更弱。 再往深一层,是训练目标没给“长期记忆”发工资。预训练是逐 token 预测,几乎不惩罚“忘了前面说过什么”,模型因此没学出显式的记忆读写机制;早期信息只能靠每层残差流反复重编码往后传,而这条通道带宽有限,误差逐层累积。加上实际产品还会做 KV cache 压缩、历史摘要、检索式拼接,早期内容往往以有损形式才活到当下。所以真正管用的办法不是“让它记住”,而是把关键事实外置:检索、写进系统提示、或在需要时重述。 |
简单说,模型没有“记忆”,它每次回答只能看到当前上下文窗口里的全部 token;窗口塞满后,早先的对话要么被截断、要么被压缩成摘要,原文就没了。窗口再大也不是无限,而塞得越满,注意力被稀释得越厉害:远处的信息权重低、容易被中间位置淹没(常说的 lost-in-the-middle),于是“看得见但用不上”。 另一层原因是训练时的分布。模型主要在短文本上学习长距离依赖,真到几万 token 的跨度,它把“第 3 轮的约束”和“第 80 轮的问题”关联起来的能力,本来就弱于人类的理解记忆;加上系统端为了省算力会做 KV 缓存淘汰、滑动窗口保留最近若干轮,早期内容被结构性丢弃。所以这不是“忘了”,而是从没被持续保留——需要跨长对话保持的信息,得靠外部记录(写入文件、检索、每轮重述关键约束)来补。 |
| B2 merge 与 rebase | git merge 会保留两条分支的完整历史,并生成一个合并提交,历史因此真实,但会分叉、按时间而言不够线性。git rebase 则把你分支上的提交逐个“移接”到目标分支的最新提交之上,从而得到一条线性、干净的历史,但会重写提交哈希。实践中,在共享分支上优先使用 merge,以免打乱别人的历史;在个人分支上整合最新代码时用 rebase,可以保持提交整洁。 |
merge 是保留分叉再合并,rebase 是把提交搬到新基底上重写历史。 merge 会生成一个新的合并提交把两条分支接起来,原有提交的哈希不变;rebase 则把当前分支的提交逐个重放到目标分支最新提交之后,产生全新的提交(哈希全变),历史变成一条直线。所以共享分支上推送过的提交用 merge 更安全,rebase 只适合还没推送的本地提交,否则会打断别人基于旧历史的引用。 |
| C1 实验草稿 | 结论:EXP-7 这次不合并。加了它的 CAND 定位精度 61.2% → 63.8%,涨 2.6 个百分点,没到 3 个点的门槛。这是跑完实测后的决定,不是"无法评估"。 但对外的版本里有两个数字打架,得先查。 一是开头写"没有带来定位精度提升",和后面的 +2.6pp 冲突,应改成"有提升,但不够门槛"。 二是 1198/1200 条预测逐字节相同。只剩 2 条不同,最多撬动 0.17 个百分点,凑不出 2.6pp。这两个数至少错一个,而 2.6pp 又刚好卡在门槛下面,不解决这个矛盾,结论就站不住。 另外缺三样:AUROC 只写了见 reports/exp7/summary.md:42,没给数值,文件也不在当前目录;分片合并的结果本身不是 claim-eligible EvalRun,要注明是方向性对照;没有置信区间,n=1200 时 2.6pp 约等于 31 条样本的差异,是否显著未知。 你现在就能做的:跑一次全量逐条 diff,确认到底是"1198/1200 相同"还是"+2.6pp"准确,顺带查为什么两个已知缺陷修完预测只变了 2 条;把 AUROC 数值补进报告。如果精度确实只有 2.6pp,round-2 先别跑。 |
结论:EXP-7(给推理流程加"实例验证"一步的实验)没达到合并门槛,不合并。 - DEV-1K(1200 条开发集)上定位精度 61.2% → 63.8%,+2.6 个百分点,合并线 3 个百分点。 - 对照批次是 run-3:BASE(基线,配置名 base_v3)对 CAND(BASE 加 exp7_verify 这一步,保留前两轮配置)。同 manifest(SHA-256 a1b2c3d…)、seed 42、代码 e4f5a6b,4×GPU 分 4 片各 300 条合并成 1200。 - 这是实测对照,不是跑不出来:1200 条里 1198 条预测逐字节相同;两个已知缺陷已修复。 - 口径瑕疵:分片合并的结果不算可入库的 EvalRun,只能说明分母、manifest、seed 一致。 - AUROC 没有可核对的数值:草稿指向的 reports/exp7/summary.md 不在仓库里,这条不引。 下一步:补出 summary.md,或开 round-2 用单个全量 run 复核 CAND。 |
| C2 上线检查草稿 | 结论:现在不能出“可以上线”的汇报。草稿把“可以上线”和“run-7 回归还没跑完”并列写着,但没有说明条件,直接发出去会被读成无条件放行。准确说法是条件放行:等 run-7 回归收尾后,再决定是否上线。 已经确认的 - 检查覆盖登录、支付、导出三条链路 - 导出耗时从 4.2s 降到 3.1s - 支付回调在 run-7 中失败过一次,草稿中指到 logs/run-7.txt:88 放行前必须完成的两件事 - 补齐 run-7 回归,给出“全绿”或“仍未通过”的明确状态 - 给支付回调那次失败定性:是偶发超时、可重试,还是必现问题。这条决定能不能带问题上线,是整份汇报里最关键的未知项。 草稿没有交代的信息 - 谁执行的、什么时候、在哪个版本或环境跑的 - “覆盖了三个链路”是指跑过还是跑通了 - 失败那次有没有重试成功 我另外核了一下 - 工作目录里没有 logs/ 目录,所以 run-7.txt:88 无法核对,只能作为原草稿的引用转述- 同目录的 draft.md 是另一轮实验报告,和上线无关,我没并进来一句话版本(可以直接贴给相关方):BUILD-42 的登录、支付、导出三条链路已检查,导出耗时从 4.2s 降到 3.1s;但 run-7 的回归尚未跑完,且支付回调在 run-7 中失败过一次,待回归收尾并确认该失败的性质后,再给出上线结论。 是否需要我照这个改写成正式汇报文档,或先把 draft2.md 更新成这版? |
结论:BUILD-42(这次要上线的构建)先别上线。草稿自己的结论写的是“可以上线”,但同一份草稿又写明 run-7(第 7 轮回归)还没跑完,并且支付回调在 run-7 里失败过一次;这两条都指向不能放行,所以这个结论和草稿正文相互矛盾。 - 覆盖范围:登录、支付、导出三条链路。 - 支付:支付回调在 run-7 里失败过一次,记录在 run-7 的日志 logs/run-7.txt 第 88 行;该文件不在当前目录,我无法贴出原文,需要你提供路径或直接贴出来。 - 导出:耗时从 4.2s 降到 3.1s。 - 回归:run-7 还没跑完,支付回调失败的原因也还没查清。 下一步:先补跑 run-7,确认支付回调的失败能否复现;只要能复现,就不上线。 |
字数与 token差异
| 场景 | 字数(关闭 / 开启) | 输出 token(关闭 / 开启) |
|---|---|---|
| A1 建文件并验证 | 144 → 189, 31.25%↑ | 2,333 → 1,344, 42.39%↓ |
| A2 写入并读回 | 124 → 238, 91.94%↑ | 220 → 398, 80.91%↑ |
| B1 为什么模型会忘事 | 410 → 350, 14.63%↓ | 732 → 326, 55.46%↓ |
| B2 merge 与 rebase | 184 → 194, 5.43%↑ | 150 → 366, 144.00%↑ |
| C1 实验草稿 | 558 → 496, 11.11%↓ | 2,781 → 3,066, 10.25%↑ |
| C2 上线检查草稿 | 672 → 331, 50.74%↓ | 1,636 → 2,092, 27.87%↑ |
每步约 +589 input token。
安装
# npm
dsh plugin --profile desktop add dsh-plain-talk

# GitHub
dsh plugin --profile desktop add github:lizilong1993/dsh-plain-talk

# 本地目录
dsh plugin --profile desktop add ./dsh-plain-talk
装完重启 DSH。
使用
- 打开任意会话,输入框权限选择器右侧会多一个笑脸气泡图标。
- 开启时笑脸右侧带三道声波、张嘴笑;关闭时是不带声波的微笑版。点一下切换,只影响当前会话。
- 状态写在
$DSH_HOME/plain-talk.json,重启后保持。 - 想让新会话默认关闭:启动环境里设
PLAIN_TALK_DEFAULT=off。
词汇清单
$DSH_HOME/plain-talk-vocab.json,跨会话共享。
| 类别 | 含义 | 例子 |
|---|---|---|
| 常识词汇 | 内置,不解释 | arXiv、DOI、API、GPU |
| 专业词汇 | 你用过的领域词 | 扩散模型、AUROC |
| 项目 / 产品名 | 仓库、产品、工作区名 | AcmeService_V2、DataHub_V3 |
| 待归类 | 已记录、未分类 | 其他识别到的词 |
内部代号(EXP-7、DEV-1K、run-3)不进入词表:每次出现都按未知处理,提醒模型重新解释。
"调研 X"分两步:X 先记为待确认,第一轮回复照常解释;回复交付后写入词表。常识词(如 arXiv)和内部代号不受影响。
维护用 plain_talk_vocab:list / add / remove / classify;也可以直接改 JSON。
自检工具
plain_talk_check 接收一条草稿,返回问题清单:
- 必须改:回指词、会话号 / 子代理 / 工具名、只给指针没有原文。
- 建议改:未解释代号、超过 12 行 / 300 字、列表超过 5 条、开头寒暄、结尾征询、中文用户却整段英文。
规则区段要求模型在完成类回复或超过 12 行的回复发送前调用它。
工作原理
- 宿主端(
dsh/index.js)注册一个系统提示词段落(plain-talk,order 55),只有当前会话开关打开时返回规则正文。 - 浏览器端(
lib/client.js)注册进conversation.input.left,渲染 18×18 笑脸按钮。 - 开关经 loopback 路由
/plain-talk/state读写(仅 127.0.0.1 / ::1,body ≤8 KB)。 - 状态与词表都是 JSON sidecar,原子写;不写 session 事件。
数据与权限
只写 $DSH_HOME/plain-talk.json 和 $DSH_HOME/plain-talk-vocab.json。不联网、不上传、不读凭据;状态文件损坏时按"无记录"处理。
配置
只有环境变量 PLAIN_TALK_DEFAULT(on / off,默认 on)。
注意
- 按钮位置依赖
conversation.input.left,宿主改版后可能移到其它左侧控件旁。 - 规则是提示词约束,
plain_talk_check只提醒、不拦截发送。 - 词表按用户共享,不按项目隔离。
- 默认开启时每个请求多约 590 input token。
许可
MIT —— 见 LICENSE。
No comments yet. Be the first to write one.