dsh-voice-studio · 音色工坊
DeepSeek Harness 的语音工作台插件:在侧边栏里管理 GPT-SoVITS 音色(训练 / 切换 / 试听), 以及基于 RVC 的翻唱变声(人声分离 → 变声 → 混音出一首歌)。
平台:Windows 10/11(依赖 PowerShell、WMI、explorer) 许可:MIT
English quickstart
dsh-voice-studio is a Windows-only plugin for DeepSeek Harness that puts a voice workbench in the sidebar: manage GPT-SoVITS voices (zero-shot preview, fine-tuning, switching, A/B), and run RVC covers (separate vocals → voice conversion → mix → mp3).
The plugin ships no models or engines. You need:
- DeepSeek Harness (plugin host)
- GPT-SoVITS with
api_v2.pyrunning on127.0.0.1:9880 - optionally an RVC environment (Applio + audio-separator + ffmpeg) for covers
Install (after publishing):
dsh plugin --profile desktop add dsh-voice-studio
# or from git
dsh plugin --profile desktop add github:liye0803/dsh-voice-studio
Restart DSH, open the sidebar entry, and the 3-step wizard will ask where your engines live.
HTTP API: GET /voice-studio/say?text=hello&voice=zero-shot returns a wav.
截图
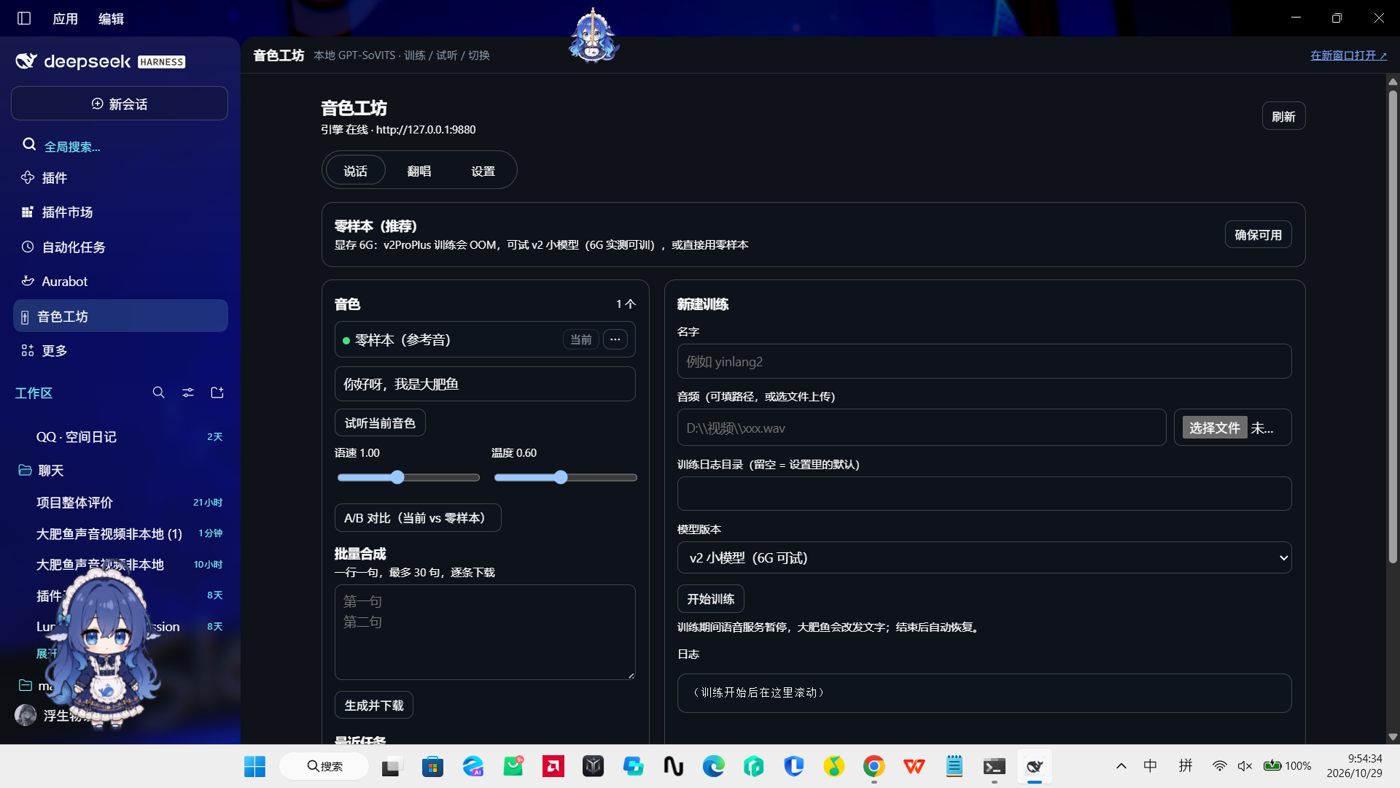
说话:音色列表、试听、语速/温度、A/B、批量合成、新建训练
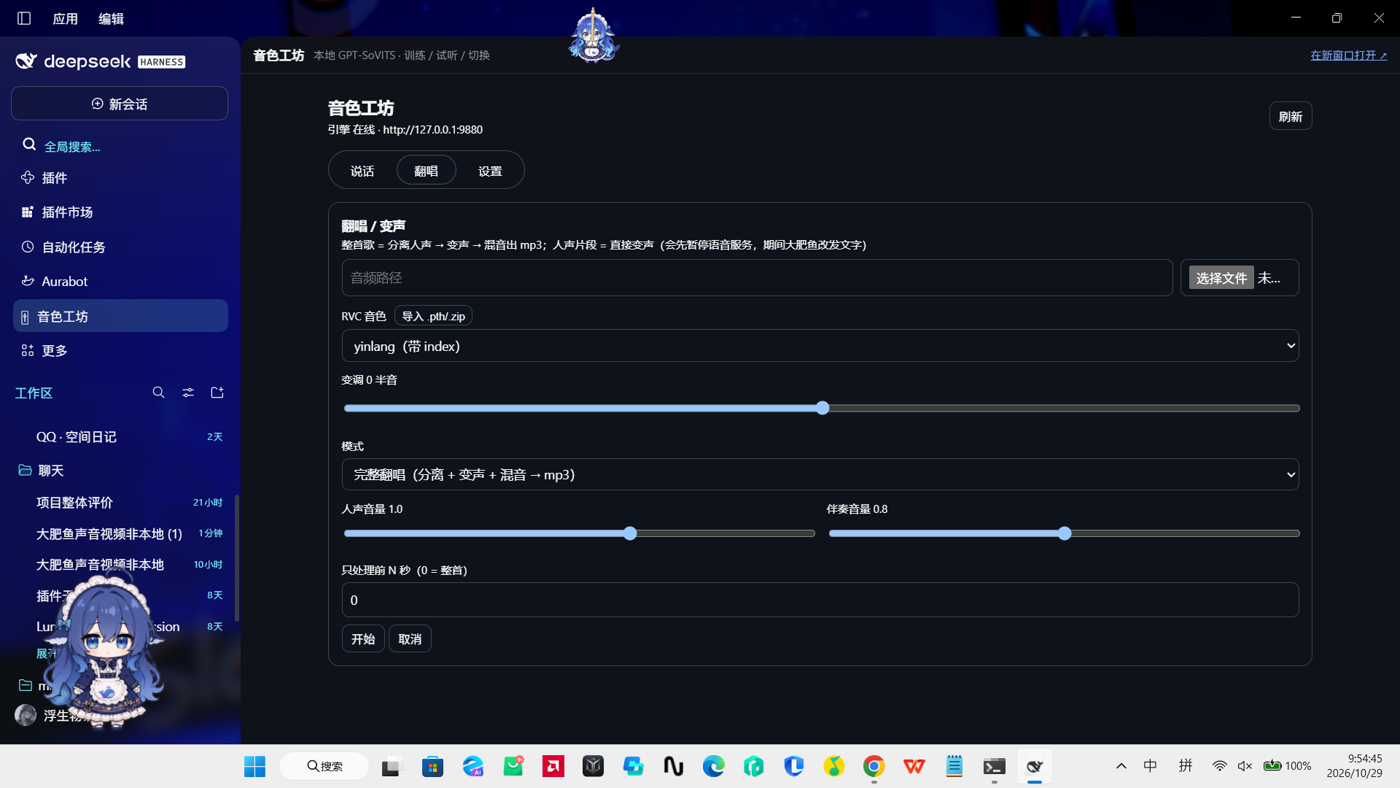
翻唱:选音频、RVC 音色、变调、模式、人声/伴奏音量、只处理前 N 秒
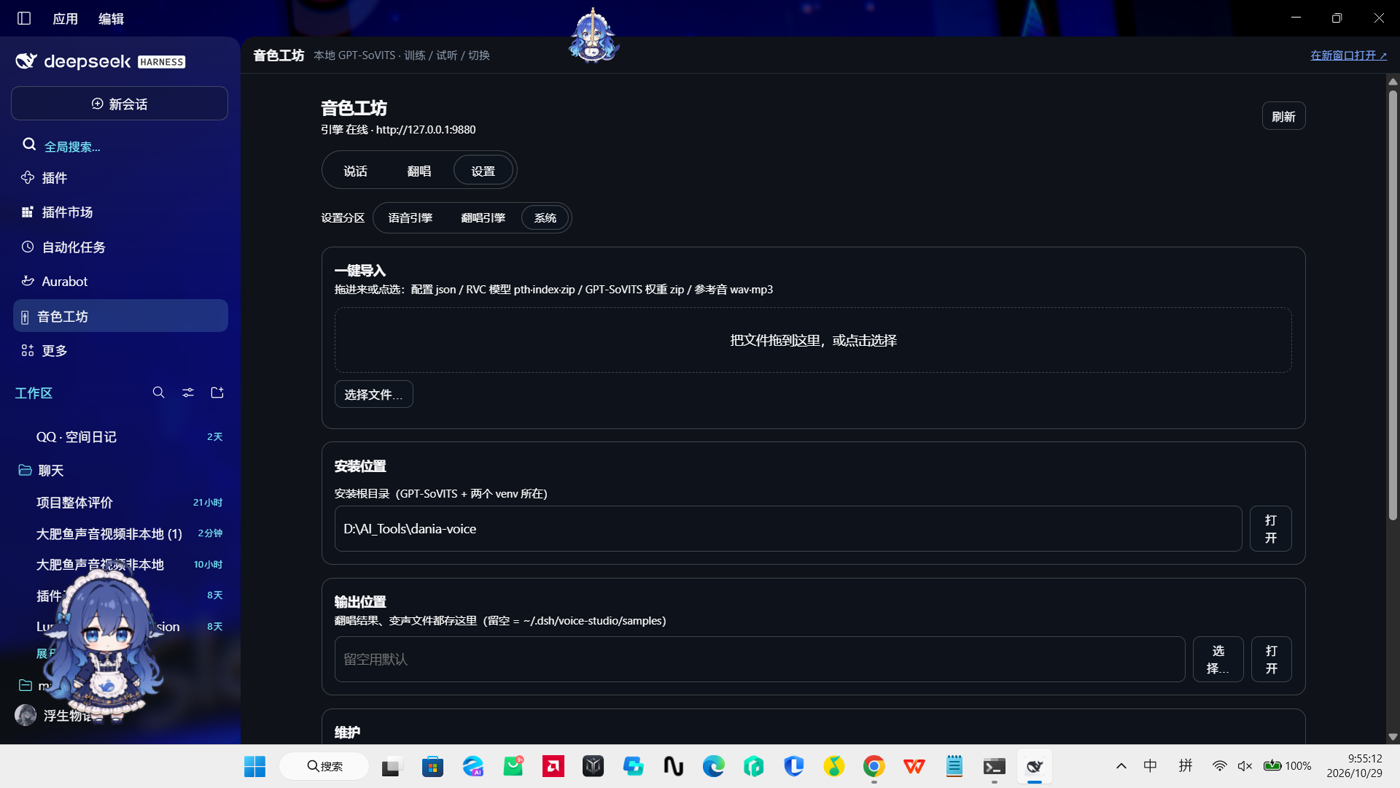
设置 · 系统:一键导入、安装位置、输出位置、维护与 Aurabot 同步
它能做什么
说话(GPT-SoVITS)
- 零样本试听:选一段 5~10 秒参考音,立刻用底模合成
- 训练专属音色:切片 → 打标 → 预处理 → s1/s2 训练,全自动;6GB 显存可用 v2 小模型
- 音色管理:多套权重切换、备注、改名、删除
- 参数:语速 0.61.6、温度 0.11.2
- A/B 对比:同一句话,当前音色 vs 零样本
- 批量合成:一行一句,最多 30 句,逐条下载
- 参考音库:列出候选音频,一键转写(whisper)、设为全局参考音、绑到某个音色
- 对外接口:
GET /voice-studio/say?text=…直接返回 wav,任何软件可用
翻唱(RVC)
- 完整翻唱:整首歌 → 人声分离 → RVC 变声 → 混音,导出 mp3
- 只变声:输入已经是人声时跳过分离混音
- 可调:变调 -12~+12 半音、人声/伴奏音量、只处理前 N 秒
- 模型管理:导入
.pth/.index/.zip,同名自动配对 - 组件自检:Python / Applio / audio-separator / ffmpeg / rmvpe 五项状态一目了然
通用
- 环境自检:显卡、显存档位、Python、转写环境、底模、参考音、引擎、端口、权重目录
- 一键导入:把 json / pth / index / zip / wav 拖进来,按类型自动归位
- 输出位置:成品存哪个文件夹自己选
- 引擎保活:60 秒看门狗;用 WMI 独立启动,DSH 退出不会带走引擎
- 同步到 Aurabot:把当前音色的参考音/文字写进 Aurabot 配置,不用两边手填
- 诊断包 / 清理缓存 / 配置导出导入
环境要求
| 依赖 | 说明 |
|---|---|
| DeepSeek Harness | 提供插件宿主与侧边栏 |
| GPT-SoVITS | 说话引擎(api_v2.py,默认 127.0.0.1:9880) |
| RVC 环境(可选) | 翻唱用:Applio + audio-separator + ffmpeg,装在独立目录 |
| NVIDIA 显卡 | 4GB 以上可零样本;6GB 可训 v2 小模型;8GB+ 可用 v2ProPlus |
本插件不包含模型与环境,只做“编排 + 界面 + 保活”。引擎需要你自己装好。
安装
本地开发(link: 安装,改动即时生效):
dsh plugin --profile desktop add "link:D:/path/to/dsh-voice-studio"
从 npm / GitHub 安装(发布后):
dsh plugin --profile desktop add dsh-voice-studio
装完重启 DSH,侧边栏出现「音色工坊」。
首次配置
- 打开侧边栏「音色工坊」,向导会跑三步:环境体检 → 选玩法 → 完成
- 设置 → 语音引擎 → 「安装位置」填 GPT-SoVITS 所在目录(含
venv、gpt-sovits) - 设置 → 翻唱引擎 → 「RVC 根目录」填 RVC 环境目录(含
env、Applio) - 「语音引擎」填参考音路径与参考文字(文字必须和音频逐字一致)
- 点「重新检测」,红项会写修复方法
使用
试听:说话页 → 输入一句 → 试听当前音色 → 拖语速/温度再试
训练:说话页 → 新建训练 → 名字 + 音频 + 版本(6GB 选 v2)→ 开始
训练期间语音服务暂停,结束后自动恢复。
翻唱:翻唱页 → 选歌 → RVC 音色 → 模式(完整翻唱/只变声)→ 开始 → 试听/下载
给别的软件用:
GET http://127.0.0.1:<DSH端口>/voice-studio/say?text=你好&voice=zero-shot
目录结构
lib/
  index.js     宿主路由 + 引擎看门狗(独立模式 --standalone <port>)
  app.js       核心:自检、训练、翻唱、导入、同步
  page.html    整个界面(HTML+CSS+JS 单文件,热加载)
  client.js    侧边栏入口
tools/
  train_pipeline.py   GPT-SoVITS 训练流水线
  label.py            打标
运行数据(不进仓库):
~/.dsh/voice-studio/
  settings.json  voices.json  jobs.json
  logs/  samples/  uploads/  dataset/  rvc-work/
开发
| 改什么 | 怎么生效 |
|---|---|
lib/page.html |
面板 F5 刷新即可(热加载) |
lib/app.js / index.js / client.js |
重启 DSH |
tools/*.py |
下次任务生效 |
自测(初装态逐项打接口,CI 也跑这个):
npm test        # 或 node scripts/test-api.mjs
npm run check   # 三个 JS 文件语法检查
独立调试(不开 DSH 也能看界面):
node lib/index.js --standalone 9909
# 打开 http://127.0.0.1:9909/voice-studio/app
已知限制
- 仅 Windows(依赖 PowerShell / WMI / explorer)
- 翻唱需要 Aurabot 风格的 RVC 目录布局,或自行在设置里指到等价结构
- 6GB 显存:TTS 引擎与 RVC 不能同时常驻,翻唱/训练会自动暂停引擎
- 训练小模型(GPT-SoVITS s1/s2)在 6GB 上只能选 v2,v2ProPlus 会 OOM
常见问题
显示“引擎离线”/ 说不了话 先看 设置 → 语音引擎 → 环境自检;引擎加载约 40 秒,启动中会显示“启动中”。
翻唱报“找不到模型”
确认 设置 → 翻唱引擎 五个组件全绿,且 models 里有 .pth。
面板点了没反应 页面脚本出错时整页 JS 会失效;按 F5,或看开发者工具 Console 的第一条报错。
合规与免责
- 本插件只做本地编排,不下载、不分发任何模型、音色或音频内容
- GPT-SoVITS、RVC/Applio、audio-separator、ffmpeg 各自遵循其开源许可,请自行遵守
- 音色克隆须获得权利人授权:使用他人声音训练或发布内容可能侵犯人格权/著作权,风险由使用者承担
- 抓取音乐平台歌曲(如网易云、QQ 音乐)可能违反其服务条款,本插件不提供任何平台接入
- 项目按 MIT 提供,不对因使用产生的任何后果负责
许可
MIT,见 LICENSE。
第三方组件(GPT-SoVITS、RVC/Applio、audio-separator、ffmpeg)遵循各自许可; 音色素材请确保你有权使用。
No comments yet. Be the first to write one.