READMESource: main@d5ff672a
dsh-video-replica · 爆款视频复刻工作台


官网:dimexplore.com(产品中心 · 案例场景)
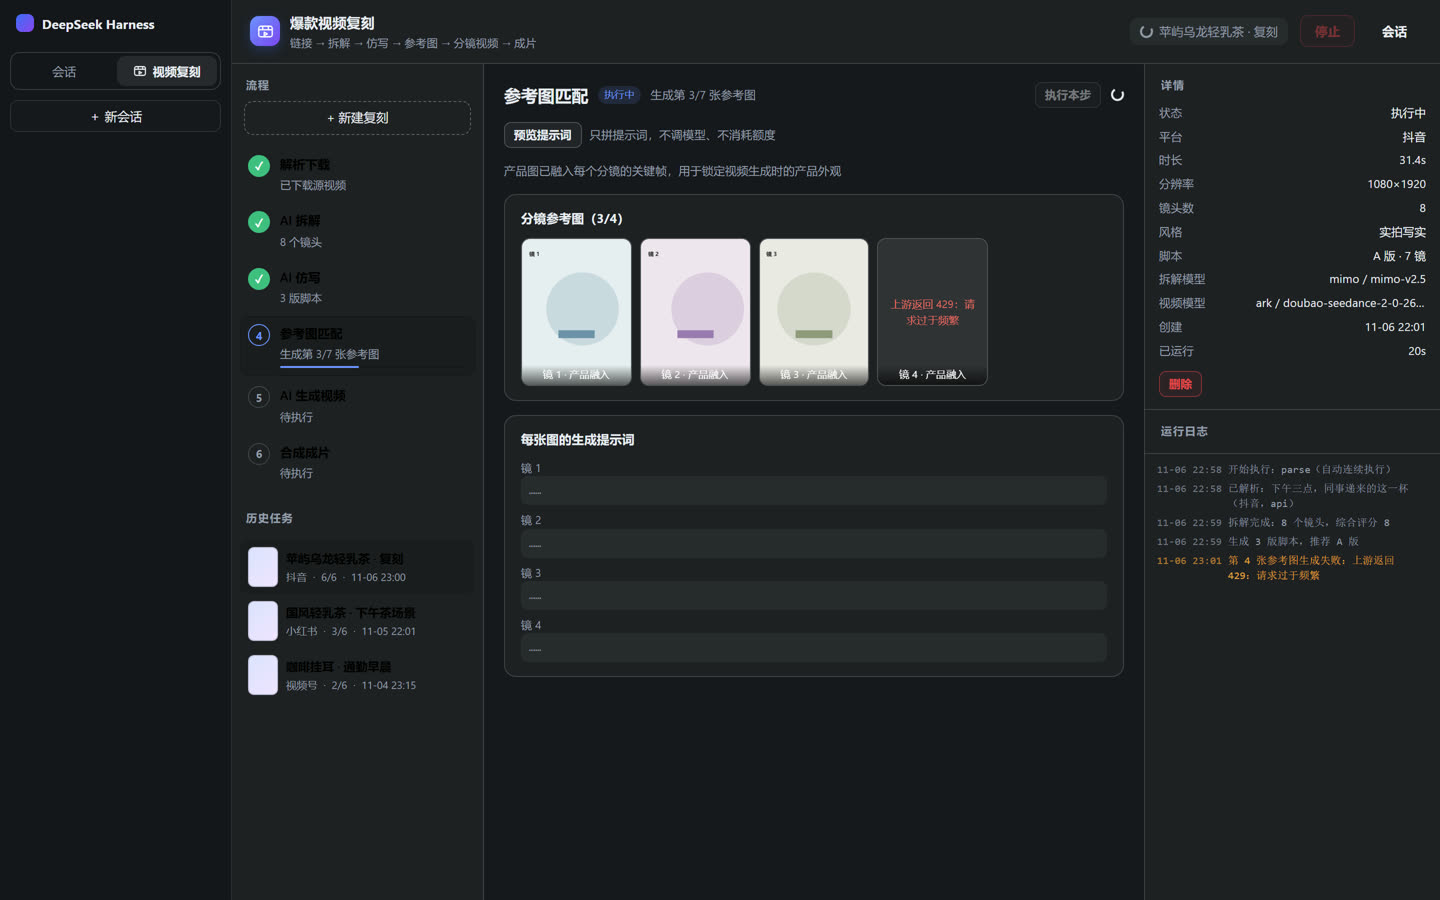
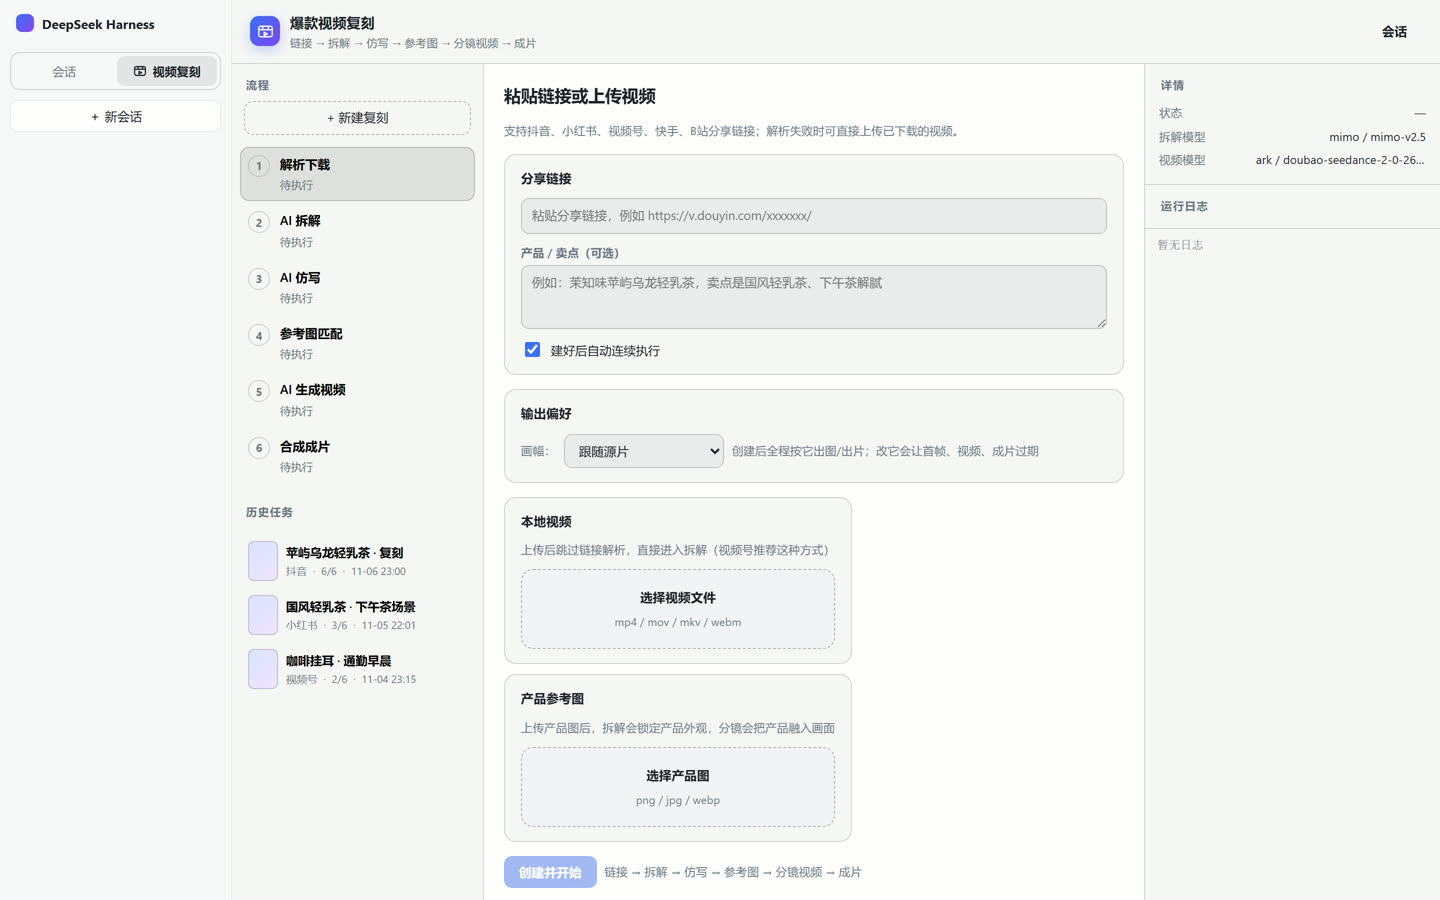
DeepSeek Harness 插件。粘贴一条抖音 / 小红书 / 视频号分享链接(或直接上传视频), 自动跑完「下载解析 → AI 拆解 → AI 仿写 → 产品参考图匹配 → AI 生成分镜视频 → ffmpeg 合成成片」六步,产出一条可直接发布的竖屏成片。
流程参考 LeadStageAI 的六步管线;界面形态参考 dsh-imagegen 的「侧边栏入口 + 中栏三栏工作台 + 设置页」。
┌──────────┐   ┌──────────┐   ┌──────────┐   ┌──────────┐   ┌──────────┐   ┌──────────┐
│ ① 解析下载 │ → │ ② AI 拆解 │ → │ ③ AI 仿写 │ → │ ④ 参考图   │ → │ ⑤ 生成视频 │ → │ ⑥ 合成成片 │
│ 链接/上传  │   │ 抽帧+视觉 │   │ A/B/C 三版│   │ 产品融入分镜│   │ 分镜成片   │   │ 拼接+字幕  │
└──────────┘   └──────────┘   └──────────┘   └──────────┘   └──────────┘   └──────────┘
安装
方式一:图形界面(推荐)
- 设置 → 插件 → 安装插件,选择本目录(或在仓库根目录执行
pnpm pack dsh-video-replica后用生成的 tarball 安装)。 - 安装后重启 DSH(新增 bundle 行需要重启才会加载宿主半边)。
- 侧边栏「会话 / 视频复刻」出现入口;设置对话框左侧出现「视频复刻配置」。
方式二:本地开发
cd <repo>
pnpm install
pnpm --filter dsh-video-replica build          # 产出 lib/index.js + lib/client.js
node scripts/install-local.mjs dsh-video-replica --profile desktop
宿主半边改完后重启 DSH 生效;浏览器半边刷新页面即可。
快速开始
- 打开 设置 → 视频复刻配置,按需填写各步骤的接口地址 / API Key / 模型名,
点「测试」确认连通(
ffmpeg/ffprobe/yt-dlp的状态会显示在「环境状态」里)。 - 侧边栏点「视频复刻」→「新建复刻」。
- 粘贴分享链接,或选择本地视频;可选:填产品/卖点简述、上传产品图。
- 点「创建并开始」。会自动连续执行六步,也可以逐步执行、单步重跑、跳过某步。
- 在「④ 参考图匹配」检查每张分镜关键帧(可单张重新生成),
在「⑤ AI 生成视频」检查每段成片(可单段重试),最后在「⑥ 合成成片」下载
final.mp4。
六步各自做什么
| 步骤 | 输入 | 做什么 | 产出 |
|---|---|---|---|
| ① 解析下载 | 分享链接 / 本地视频 | 调解析接口或 yt-dlp 拿直链,下载到运行目录;ffprobe 探尺寸、ffmpeg 出封面 | source/source.mp4、source/thumb.jpg |
| ② AI 拆解 | 源视频 | 均匀抽帧(默认 12 帧)+ 视觉模型逐镜拆解;可选 ASR 转写口播 | 分镜表、钩子、节奏、风格、爆款 DNA、评分、口播稿 |
| ③ AI 仿写 | 拆解结果 + 产品简述 | 文本模型按原片 DNA 仿写 A/B/C 三版分镜脚本 | 3 版脚本(可逐镜编辑) |
| ④ 参考图匹配 | 选定脚本 + 产品图 | 逐镜生成关键帧,产品外观以参考图为准 | frames/ref-01.png … |
| ⑤ 生成视频 | 分镜 + 关键帧 | 按「≤5 镜 / ≤15 秒」分块调视频模型,轮询并下载 | segments/seg-01.mp4 … |
| ⑥ 合成成片 | 分镜视频 + 脚本 | ffmpeg 统一画幅拼接、可选出 TTS 配音、ASS 字幕烧录、BGM | final.mp4 |
模型配置
每一步的模型有两种来源,在设置页顶部标签里切换:
- DSH 已配置模型(推荐):直接从「设置 → 模型」里已经配好的提供商与模型里选,
不需要重复填地址和密钥。
- ② 拆解 / ③ 仿写:走宿主
llm服务(llm.stream),鉴权、重试、多模态编排都由 DSH 负责; 抽帧图片经attachments转成附件后以图片内容块交给模型。 - ④ 参考图 / ⑤ 视频 / ⑥ 配音 / 语音识别:DSH 没有这些模态的原生适配器,插件会从该提供商
在组合配置里的
baseURL(以及apiKey/apiKeyEnv凭据)解析出接口地址,再用本插件 的 HTTP 适配器发请求。提供商没写baseURL时界面会明确提示改用「手动填写接口」。
- ② 拆解 / ③ 仿写:走宿主
- 手动填写接口:自填接口地址 + API Key + 模型名 + 协议,适合第三方聚合网关、自建服务。
「刷新模型」会重新探测 DSH 的提供商与模型列表;「用 DSH 默认模型」一键填入 「设置 → 模型」里的默认选择。
选「手动填写接口」时,每一步独立配置「接口地址 + API Key + 模型名 + 协议」,协议决定请求形状:
| 步骤 | 协议 | 说明 |
|---|---|---|
| ① 解析下载 | parser-json |
第三方解析服务。自动识别 HoxHox(success:true)与 RedFox(code 以 2 开头)两种响应;其它网关可用「视频地址字段路径」指定点路径。可再配一个备用解析接口:主接口失败(服务异常 / 鉴权 / 超时 / 拿不到视频地址)时自动切过去,日志会写明主接口为什么失败 |
| ② AI 拆解 | chat |
OpenAI 兼容 /chat/completions,帧以 base64 image_url 传入 |
| ③ AI 仿写 | chat |
OpenAI 兼容 /chat/completions,response_format=json_object |
| ④ 参考图 | openai-images |
/images/generations;带参考图时走 JSON image 数组,被拒则自动改 /images/edits |
| ⑤ 生成视频 | ark-seedance / openai-video |
火山方舟 Seedance 任务协议,或通用 /videos + 轮询 |
| ⑥ 配音(可选) | openai-tts / chat-tts |
/audio/speech,或聊天接口返回 base64 音频 |
| 语音识别(可选) | openai-transcription |
/audio/transcriptions(multipart),用于转写源片口播 |
配置示例见 docs/MODELS.md。
支持哪些链接
| 平台 | 链接形态 | 可靠路径 |
|---|---|---|
| 抖音 | v.douyin.com/*、www.douyin.com/video/* |
解析服务 / yt-dlp |
| 小红书 | xhslink.com/*、www.xiaohongshu.com/explore/* |
解析服务(推荐) |
| 视频号 | channels.weixin.qq.com/* |
需要支持视频号的解析服务;否则下载后「本地视频」上传 |
| 快手 | v.kuaishou.com/* |
解析服务 / yt-dlp |
| B 站 | b23.tv/*、bilibili.com/video/* |
yt-dlp |
| 视频直链 | 以 .mp4 等结尾 |
直接下载 |
解析模式 auto 会按「直链 → 解析接口 → yt-dlp」依次尝试,全部失败时错误信息里会列出
每一种方式的具体原因,并提示改用本地上传。
数据与隐私
- 配置:
~/.dsh/storages/dsh-video-replica/config.json(可用环境变量DSH_VIDEO_REPLICA_HOME覆盖整个数据根目录)。 - 运行产物:
<数据根目录>/runs/<runId>/,包含源视频、抽帧、参考图、分镜视频、成片。 - API Key 只存在本机配置文件里,界面回读时是掩码(
••••••+ 末 4 位),留空保存不会覆盖。 - 桥接接口只对本机回环 + 同源请求开放(远端浏览器访问会被 403 拒绝)。
贡献与安全
- 开发环境、命令、代码结构与发版流程见 CONTRIBUTING.md。
- 安全问题请不要开公开 issue,走 SECURITY.md 里的私密报告通道。
- 本仓库运行时零第三方依赖;
devDependencies只用于构建与测试。
文档
| 文档 | 内容 |
|---|---|
docs/ARCHITECTURE.md |
整体架构与数据流 |
docs/MODELS.md |
各模态配置与网关差异 |
docs/PROMPTS.md |
提示词架构:借鉴的写作规范与落点 |
目录结构
src/
├── shared/        类型与路由常量(宿主/浏览器共用)
├── host/          宿主半边:配置、运行存储、引擎、六步流水线、模型适配、桥接路由
│   ├── providers/   chat / image / video / tts / asr / parser 适配器
│   ├── prompts.ts   拆解与仿写提示词
│   ├── pipeline.ts  六个步骤 + 单张/单段重生成
│   ├── media.ts     ffmpeg / ffprobe / 下载封装
│   ├── engine.ts    步骤调度、取消、自动推进
│   └── routes.ts    loopback 桥接(一个路径一条 WebRoute,方法内部分派)
└── client/        浏览器半边:侧边栏入口、中栏工作台、设置页
scripts/
├── smoke-host.mjs    宿主端到端冒烟(真实 ffmpeg + mock 模型网关)
├── smoke-client.mjs  jsdom 里加载真实 client bundle 验证挂载
└── preview/          用 playwright 渲染真实 bundle 生成界面截图
开发
pnpm --filter dsh-video-replica build       # 构建两半
pnpm --filter dsh-video-replica typecheck   # tsc --noEmit
node scripts/smoke-host.mjs                 # 六步全流程(需要 ffmpeg/ffprobe)
node scripts/smoke-client.mjs               # 客户端挂载与渲染
python scripts/preview/shots.py             # 界面截图 -> output/preview/
smoke-host.mjs 会起一个本地 mock 网关(聊天/图像/视频/TTS/解析),用真实 ffmpeg
生成素材并跑完整条流水线,最后校验成片时长、分辨率、音轨、Range 播放与目录穿越防护。
它把数据写到系统临时目录,不会碰你的真实配置。
排障
| 现象 | 原因 / 处理 |
|---|---|
| 已经配好模型,工作台仍提示「还没有配置模型」 | 工作台常驻挂载,改配置后需要它重新读一次。现在切回窗口、重新打开工作台、在设置里保存都会自动刷新;也可以点提示条右侧的「重新检测配置」。若仍不消失,刷新页面(客户端半边的改动只需刷新,宿主改动才需要重启)。 |
| 设置页里「DSH 已配置模型」下拉是空的 | DSH 的 llm 服务不可用或还没配置提供商。先到「设置 → 模型」确认有可用提供商与模型,再点「刷新模型」;仍然为空时看该位置是否报了读取失败。 |
| 图片 / 视频 / 语音步骤提示「提供商没有接口地址」 | 这些模态需要该提供商在 DSH 配置里写了 baseURL(聊天提供商通常有,但有些只用内置目录)。在「设置 → 模型」里补上接口地址,或在这一步改用「手动填写接口」。 |
| 保存分镜 / 重新生成后提示正在执行 | 同一时间只允许一个任务;先等它结束或点「停止」。 |
| 解析接口返回「抖音解析服务异常」之类的业务错误 | 服务商自己的抖音通道挂了,你的 Key 没问题(Key 无效会返回 401)。在「① 解析下载」里配一个备用解析接口(不同服务商的抖音通道经常各自故障),插件会自动切换并记录原因。 |
| 「源视频无法解码」/ 之前的「抽帧失败」 | 解析服务返回了网页或风控页,被当成视频存了下来。插件现在会在「解析下载」这一步就校验(ffprobe 必须能识别出视频流),并报出实际原因与文件开头内容。处理:换可用的解析服务、开启「读取浏览器 Cookie」(yt-dlp 走你本地浏览器的抖音登录态),或直接上传视频文件。 |
| 「配音被跳过,沿用分镜自带音频」 | 脚本里没有口播/字幕文案时不再用 TTS 造一条静音轨。产品复刻(有产品图/卖点)会自动写口播;纯复刻若源片无口播则保持无台词。 |
| 语音识别报 404 / 「识别结果为空」 | 该网关不是 Whisper 协议。MiMo 的 mimo-v2.5-asr 走聊天接口:把「语音识别」的协议改成 chat-asr(选 openai-transcription 时插件也会在 404 时自动回退)。 |
| TTS 报「Unknown voice」 | 网关对音色名要求严格;插件会解析报错里的可用音色列表并自动挑一个(优先 mimo_default)重试,同时在日志里写明改用了哪个音色。想固定音色就把设置里的「音色」填成网关支持的名称。 |
已知限制
- 视频号没有公开的免登录解析路径,纯 HTTP 解析不可靠;请用支持视频号的解析服务或本地上传。
- 视频生成耗时取决于上游(单段常见 1–5 分钟),插件会持续轮询并在界面显示进度;关掉页面任务仍在跑(状态落盘)。
- 字幕字体使用系统
Microsoft YaHei;如果宿主机没有该字体,libass 会回退到默认字体(中文可能显示为方块)。 - 不生成 BGM;BGM 只支持指定本机音频文件路径(版权自行负责)。
- 拆解质量依赖视觉模型的图像理解能力;未配置 ASR 时口播稿只能从画面文字推断,界面会明确提示。
- 抖音分享链接目前基本需要「新鲜 cookie」才能下载(yt-dlp 报
Fresh cookies are needed),可在「解析下载」里开启「读取浏览器 Cookie」;解析服务本身也可能临时故障(返回抖音解析服务异常)。 - 视频网关可能忽略
size(例如返回 960×960 而非 9:16),合成本身会按源片比例缩放+补边兜底。 - 参考图与分镜视频的质量取决于所配置的图像/视频模型;不同网关对「参考图」协议的实现差异较大, 必要时用「附加请求参数(JSON)」补齐网关私有字段。
No comments yet. Be the first to write one.