dsh-retro
非官方社区项目,未经 DeepSeek 审核或背书。公开版本尚未完成独立的全新环境安装验收。
给 DeepSeek Harness 加一层长期记忆:自动沉淀失败经验、定期自我总结,并把反复出现的工作流程整理成可复用的技能。
它解决的是三个具体问题:
| 问题 | 现状 | dsh-retro 的做法 |
|---|---|---|
| 同一个坑反复踩 | 失败只留在当轮会话里,换个会话就忘了 | 工具失败自动归类、去重、脱敏后落盘,下一轮动手前注入「已知高频坑」 |
| 不知道自己在重复什么 | 每天走的流程靠人脑记 | 按 turn 切分工具调用序列,同一条序列反复出现即视为固定流程 |
| 经验无法复用 | 存在脑子里的流程没法给模型看 | 达阈值后渲染成 SKILL.md,经 skill provider 进入模型技能目录 |
安装
从 GitHub 安装
dsh plugin --profile <profile> add github:liaoli-hero/dsh-retro
本包是 bundle 型 Cordis 插件(dsh.bundle.patch 指向 cordis.patch.yml),装进 profile 即自动进层栈,无需手工编辑任何配置。
从本地目录安装
dsh plugin --profile <profile> add <此目录>
手工方式(无 CLI 时):
- 把本目录放到
$DSH_HOME/profiles/<profile>/dsh-retro; - 在 profile 的
node_modules/下建同名 junction/软链指向它(Windows:New-Item -ItemType Junction); - profile 的
package.json里加依赖"dsh-retro": "file:./dsh-retro",并把dsh-retro追加进dsh.profile.bundles; - 重启 dsh。
桌面版(Electron)的 profile 由应用独占管理,dsh --dump-config 会被拒绝;改完配置文件后重启应用即可。
装完即最佳配置
不需要写任何 config。默认值已经是全自动:失败记录、自我总结、提示词注入、技能沉淀全部在跑,固定流程出现 4 次就自动变成技能。详见下文「默认值就是最佳配置」。
默认值就是"最佳配置"
这套默认值是照着「新用户不该先读文档调参数」定的:
| 决定 | 值 | 为什么 |
|---|---|---|
| 失败记录 | 开 | 这是插件的核心价值,没有理由要用户手动打开 |
| 技能草稿 + 自动晋升 | 都开 | 装完就能看到"技能自动长出来"的完整效果 |
| 流程阈值 | 4(不是 3) | 3 次里很容易有两次是同一次排查的连续重试;4 次才更像"会重复的任务类型" |
| 提示词预算 | 1200 字符 | 够放 6 条坑 + 4 条流程;不挤占主上下文 |
| 自动技能上限 | 40 | 防长期使用后技能目录膨胀,挤掉真正有用的技能 |
相关回归由 verify-switches.mjs 里「默认值:装完即最佳配置」一节守着——它用完全不传 config 的方式装配插件,再验证技能真的自动产出。
装完是什么样
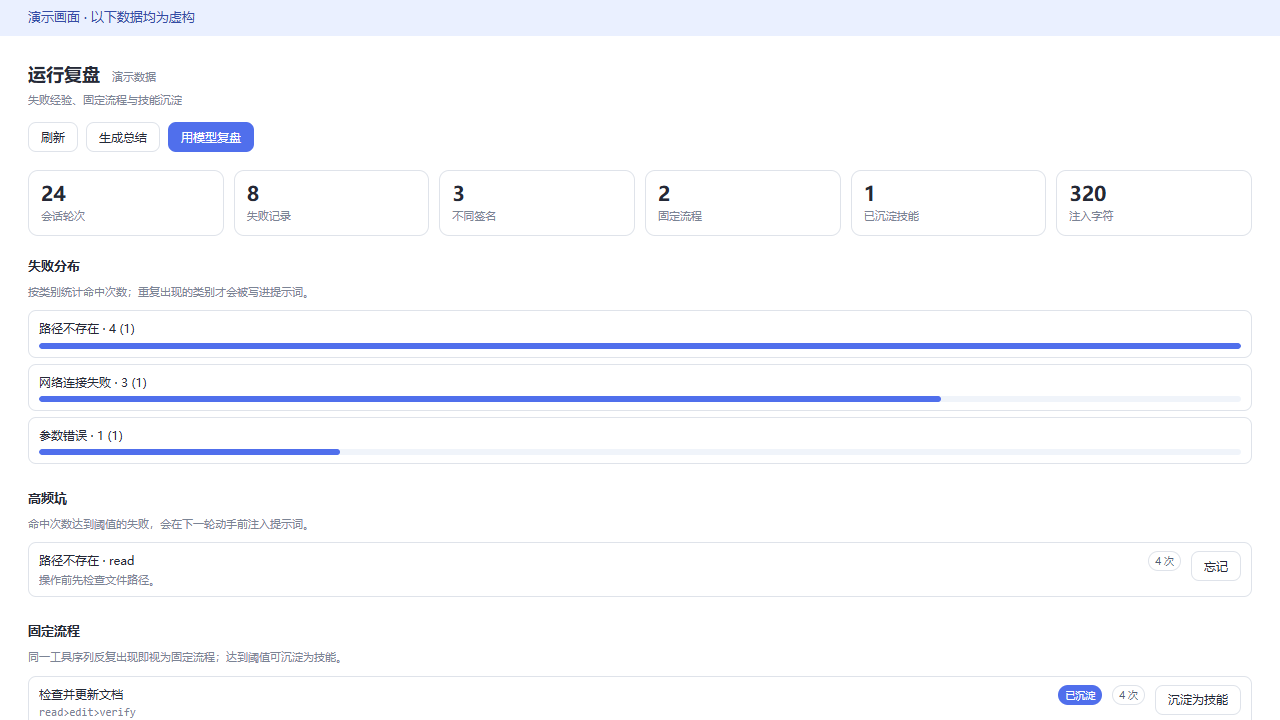
侧栏入口:左侧导航「更多」区多一行「复盘沉淀」(与「插件」「自动化任务」同级)。点开是完整面板:
- 统计卡:轮次 / 失败记录 / 不同签名 / 固定流程 / 已沉淀技能 / 注入字符
- 失败分布:按类别横条,一眼看出最常踩的是哪类
- 高频坑 / 最近踩过的坑:分别对应「已注入提示词」与「还没到阈值」
- 固定流程:每条带「沉淀为技能」按钮,已沉淀的有角标
- 已沉淀技能:名字、说明、何时用
- 当前注入内容:实际写进系统提示词的原文,所见即所得
其它表面:
- 4 个工具:
retro_capture/retro_summary/retro_skills/retro_forget - 1 个斜杠命令:
/retro [show|summary|skills|promote <签名>|forget <签名>|config|set <k>=<v>|reset] - 1 个技能 provider:
dsh-retro(把skills/下的SKILL.md暴露给模型) - 1 个系统提示词 section:
retro:history(受promptBudget限制,无数据时为空串) - 5 条 HTTP 路由:
/api/retro/{snapshot,settings,promote,forget,summary}(面板数据源)
面板不猜测宿主内部状态:拉不到数据就显示带原因的红色提示(含「插件尚未初始化」),而不是白屏或假空态。
落盘布局
默认根目录 $DSH_HOME/dsh-retro/(可由 rootDir 改):
fails.jsonl     失败经验,逐条 append;按签名可去重统计
flows.jsonl     固定流程聚合(整体重写,规模小)
skills/         已晋升技能,扁平 <name>.md,被 provider 扫描
drafts/         技能草稿(不在 catalog 里,晋升才进 skills/)
summary.md      最近一次自我总结(人读)
state.json      轮次计数与最近总结时间
fails.jsonl 单行样例:
{"id":"f10bfbbf17f8","ts":"2026-10-31T02:11:09.512Z","signature":"sandbox-denied|write|a1b2c3d4e5","class":"sandbox-denied","classLabel":"权限/沙箱拒绝","tool":"write","sessionId":"...","cwd":"C:/proj","turn":9,"step":1,"code":"","message":"sandbox: file access denied","detail":"...","argsDigest":"{\"path\":\"<path>\"}","lesson":"先确认操作路径是否落在当前工作区/沙箱允许范围内…"}
三个机制的判定规则
失败归类——内置 10 类(沙箱拒绝、路径不存在、语法参数、网络、超时、编码、依赖、上下文限制、测试失败、守卫拦截)。判定用错误文本的稳定特征,不是关键词命中即止:先匹配到的类胜出,都不中则落 unknown。
失败签名——类别 | 工具名 | 归一化错误骨架的哈希。归一化会抹掉路径、端口、数字、UUID、引号内容,所以「读 C:\a\b.txt 失败」与「读 C:\x\y.txt 失败」算同一个坑。这是能统计「高频」的前提。
固定流程——按 turn 切分,把该轮的工具调用名收集起来。聚合键是工具集合(flowSkeleton),不是完整序列:
一轮的完整序列(29 步,每次顺序都不同):
  read>edit>pwsh>edit>pwsh>read>write>pwsh>...
聚合用的骨架(工具集合,排序后):
  edit>pwsh>read
为什么用工具集合而不是序列——这是实测踩出来的:早期拿完整序列做聚合键,真实任务每轮 8~29 步、顺序各异,精确相等导致每条的 count 恒为 1,flowThreshold=4 永远达不到,技能一个也长不出来。插件看起来在正常工作(流程列表有内容),但核心产出是空的。
工具集合天然稳定:同一类"读改测"任务无论顺序怎样、改了几次,骨架都是 edit>pwsh>read。而"纯调研"是 grep>read、"调研加改"是 edit>grep>pwsh>read,仍然能区分开。write / present 作为产物导出动作被排除在外。
旧数据自动兼容:没有 skeleton 字段的条目按 signature 匹配,升级不会让历史记录作废。
刻意没用 LLM 聚类的原因:聚类要花 token、同一份历史跑两次可能得到不同技能名;而工具集合是客观事实,跨会话可比、天然能映射回可复现步骤。LLM 只在 retro_summary useModel=true 时用来把统计讲成人话,且明确要求「只依据给定事实、不得编造」。
配置
配置分两层,这是本插件最重要的一条设计:
| 层 | 存在哪 | 怎么改 | 什么时候生效 |
|---|---|---|---|
| 部署层 | profile 的 cordis.patch.yml |
编辑 YAML | 需要重启 |
| 运行层 | $DSH_HOME/dsh-retro/settings.json |
面板开关 / /retro set |
立即生效 |
生效值是两者的合并,运行层覆盖部署层,但只覆盖显式写过的键。删掉 settings.json 就完全回落到部署层——没有隐式状态。
日常调开关不需要碰 YAML、不需要重启:
在面板「复盘沉淀 → 自动化设置」里点开关,或:
/retro set autoPromote=true
/retro set flowThreshold=5 promptBudget=2000
/retro config          看当前生效值与哪些被覆盖
/retro reset           清掉运行层,回落到部署层
两个「技能生成」开关是正交的
autoDraft 与 autoPromote 互不依赖,任一打开都会在流程达到 flowThreshold 时产出东西:
autoDraft |
autoPromote |
结果 |
|---|---|---|
false |
false |
只聚合流程,不生成任何文件 |
true |
false |
生成 drafts/xxx.md 草稿;模型看不到,等你人工晋升 |
false |
true |
直接写 skills/xxx.md;模型能看到(草稿也顺带留一份,便于回看来源) |
true |
true |
同上 |
- 想半自动(先看草稿再决定)→ 只开
autoDraft - 想全自动(流程一成熟就变成技能)→ 开
autoPromote - 都不开也不影响别的功能:失败经验照常记录、总结照常生成、提示词照常注入
坑一:只配 autoPromote: true 不生效。 早期把晋升写在了草稿分支里面:
if (entry.promoted !== true && config.autoDraft && count >= threshold) {
  const draft = writeDraft(entry, ctx)
  if (config.autoPromote) promoteSkill(entry, draft, ctx)   // ← 只有 autoDraft 也开着才到这行
}
配置读进去了、日志不报错、/retro config 还显示「自动晋升 开」,但技能永远不出现。现在两个开关平级判断,由 verify-switches.mjs 逐组合实测兜底。
坑二:改个开关要重启。 原来所有配置都在 cordis.patch.yml 里,而它只在装配时读一次。调阈值这种使用中反复做的事跟重启绑定,就没人愿意调了。于是加了运行层。
运行层能改哪些键
enabled、autoCapture、autoDraft、autoPromote、flowThreshold(2–10)、repeatThreshold(1–20)、promptBudget(0–8000)、summaryTopN(1–20)、mirrorToUserSkills、maxErrorChars(200–8000)。
rootDir / skillRank / maxFlows 等牵动路径或结构的键只能在部署层改——运行期改会让已有技能文件突然"换目录",属于不该允许的操作。非法值会被拒绝并说明原因,不会静默夹紧。
| 字段 | 默认 | 说明 |
|---|---|---|
enabled |
true |
false 时整体停摆:不记录、不注入、不注册任何表面 |
rootDir |
'' |
空 = $DSH_HOME/dsh-retro |
autoCapture |
true |
自动记录工具失败 |
autoDraft |
true |
达阈值生成技能草稿(drafts/,不进 catalog) |
autoPromote |
true |
达阈值直接晋升进 catalog(skills/,模型可见) |
flowThreshold |
4 |
流程晋升阈值(2–10);4 而非 3,避开连续重试造成的误判 |
repeatThreshold |
2 |
高频坑阈值(1–20) |
promptBudget |
1200 |
提示词预算(0–8000) |
summaryTopN |
6 |
总结里最多列几条(1–20) |
maxAutoSkills |
40 |
自动沉淀技能的数量上限(0 = 不限);超出按「最久未命中」淘汰 |
skillRank |
250 |
技能在 catalog 里的优先级(数值小者优) |
mirrorToUserSkills |
false |
额外镜像一份到 $DSH_HOME/skills(供内置 filesystem provider 发现) |
llmTimeoutMs |
45000 |
模型复盘的超时(毫秒) |
maxErrorChars |
1400 |
单条失败保留的字符上限 |
maxFlows |
300 |
流程条目上限 |
加粗的是「装完即用」的关键项——这些默认值让新用户不做任何配置就拿到完整效果。
使用
/retro show                     看状态:多少条经验、多少流程、多少技能、注入多少字符
/retro summary                  重新生成 summary.md
/retro skills                   列出技能与流程(带签名)
/retro promote read>edit>pwsh   把某条流程晋升成技能
/retro forget <签名>            清掉一条记忆(技能一并下线)
模型侧可直接调 retro_capture 手动沉淀结论(自动捕获的失败只有报错、没有结论,这类工具补的就是那一层)。
设计取舍
为什么经验不写进 session 日志——Session 是「模型可见事实」的 append-only 账本。复盘数据是跨会话的长期记忆,塞进去会让每一轮请求都携带大量无关历史。
为什么只依赖 node: 内置模块——插件由 profile 的解析器加载,少一个裸包依赖就少一个「版本对不上导致整层不加载」的失败面。工具定义用裸对象注册(registry 只校验 output.render 与 schema 子集),技能走 ctx.skills.registerProvider,提示词走 ctx.systemPrompt.section,模型调用直接消费 ctx.llm.stream 的 text-delta。
为什么晋升后必须显式 invalidate——@deepseek-ai/dsh-skill 的 registry 没有 TTL,provider 的 list() 结果按 cwd/scope/revision 缓存。只改磁盘不调 invalidate(),模型侧目录会永远停在旧快照(技能文件明明写出来了,skill 工具却看不到,且只在重启后才出现)。所以所有写 skills/ 的路径都经 lib/invalidate.js 统一通知。
为什么提示词 section 关掉插值——宿主默认对 section 文本做 {{...}} 变量插值,且是严格模式:任何一对未命中变量的 {{}} 都会让整轮装配抛错。历史经验里完全可能出现这种文本,关掉插值让「所见即所注入」逐字符一致。
为什么面板自己拉 HTTP 而不是订阅推送——复盘数据是宿主侧磁盘文件,没有现成推送通道。面板每 15 秒轮询一次 /api/retro/snapshot,标签页不可见时停;这个数据不属于实时视图,没必要抢资源。所有写操作(晋升/忘记/生成总结)是显式 POST,跑完立即重拉。
为什么 registerRoutes 收到的 ctx 要另存一份——路由处理函数是在 apply() 之外被调用的(HTTP 请求什么时候来都有可能),闭包里必须拿得到已注入 webServer 的那个作用域。之前漏了这一步,表现是 promote 路由 500 报 ctx is not defined。
为什么轮末同步重算摘要——注入摘要走的是节流刷新(400ms 合并),但 turn/end 是天然的同步边界:下一轮的第一步马上要读摘要,等节流会让「刚总结完就忘」。所以轮末额外强制算一次。
验证
npm test          # 等价于 verify.mjs(不需要宿主,随时可跑)
npm run verify:all # 全部自足测试(不依赖宿主安装)
npm run verify:host # 需要宿主安装的两项(e2e schema 校验 + 真机装配)
逐项说明:
node scripts/verify.mjs              # 纯函数:归类/签名/聚合/流程/技能渲染往返/摘要预算(55 项)
node scripts/verify-skeleton.mjs     # 流程骨架:同类收敛 + 异类区分(18 项)
node scripts/verify-client.mjs       # 客户端契约:bundle 形态/平台模块/槽位 id 自洽/词典键集(27 项)
node scripts/verify-render.mjs       # 组件渲染:空态/有数据/失败/脏数据 + 设置区(46 项)
node scripts/verify-settings.mjs     # 运行层设置:覆盖语义/持久化/非法输入/重置/行为闭环(30 项)
node scripts/verify-switches.mjs     # 开关矩阵 + 默认值 + 数量上限(33 项)
node scripts/verify-model-summary.mjs # 模型复盘:服务注入 + 四种降级 + 报错转述(25 项)
node scripts/verify-e2e.mjs          # 接线:事件 → 经验 → 流程 → 技能 + /retro set(37 项 / 无宿主时 36+1 跳过)
node scripts/verify-host.mjs         # 真机:真实 cordis + 4 个服务装配 + 5 条路由实测(39 项,需宿主)
node scripts/verify-live-config.mjs  # 配置层闭环:读真实 profile 配置再真跑(12 项)
不依赖宿主的脚本可在任何机器上直接跑(打包解压后实测 237 项通过)。只有 verify-host.mjs 和 verify-e2e.mjs 的 schema 校验需要宿主安装:
DSH_APP=<dsh 的 node_modules/@deepseek-ai> node scripts/verify-host.mjs
找不到宿主时它们明确报告 SKIP 并说明少验了什么,不会假装全过——这是刻意的:green 但什么都没验,比红更危险。
verify-render.mjs 用一个 ~100 行的最小 hooks 运行时真跑面板组件(磁盘上没有 react 包,它被打进前端 bundle),能验空数据不崩、有数据全渲染、失败转可读文案、null 字段不产出 undefined。
verify-live-config.mjs 的路径全部相对/可配置(--profile、DSH_HOME、DSH_APP),不含任何本机绝对路径,因此能随包发布。
面板是怎么接上的
宿主用两个槽位拼出一个入口,两者共用同一个 id:
| 槽位 | 作用 | 我们的注册 |
|---|---|---|
sidebar.panellist |
侧栏「更多」区的图标行 | id: 'retro-review', order: 30 |
main |
该面板的主区域内容 | key: 'retro-review' |
id 不一致的后果是「点了没反应」:宿主拿 panellist 的 id 去 main 的 keyed 槽位找落地面,找不到就保持当前选择。verify-client.mjs 里有一条断言专门守这个。
客户端 bundle 走 exports["./client"] + dsh.client.platform: "web",由 dsh-client-modules 组合进 boot graph 并从 /plugins/dsh-retro/client.js 提供。bundle 内只能 require 平台模块表里的东西(react / react/jsx-runtime 等),多一个都会在运行时 404 掉——同样有断言。
已知边界
- 流程识别是序列相等判定,不认「语义相同但工具不同」的流程(例如用
pwsh和用bash完成同一件事)。这是刻意的保守选择。 - 失败归类基于错误文本特征,自定义错误措辞可能落进
unknown;unknown类仍会记录并被统计,只是不带专属教训。 - 技能草稿的内容来自历史序列,不保证当前环境有同名工具;SKILL.md 正文里已写明这一点。
- 自动晋升(
autoPromote)默认开启:技能会在无人 review 的情况下写进 catalog。为此配了两道护栏——flowThreshold=4压低误判,maxAutoSkills=40防目录膨胀(按「最久未命中」淘汰,手动晋升的不动)。但具体某条技能是否真的有用,仍需你自己过一眼;觉得太吵就/retro set autoPromote=false。 - 淘汰只处理
skills/下由自动晋升写下的文件;mirrorToUserSkills打开时写到$DSH_HOME/skills的那份需要手动清理。 - 删除技能只删文件本身,不会回收已进入会话历史的技能内容(那是 append-only 的)。
License
MIT
演示
下图由插件面板代码渲染,数据为虚构示例,不代表真实会话。
No comments yet. Be the first to write one.