dsh-plugin-voice-local
DeepSeek Harness(DSH)本地流式语音插件:TTS + ASR 全在宿主进程内跑,不 spawn 独立进程、不另起端口、不走云语音 API。点一下输入框的 🎙,就能在全屏通话界面里跟 DSH 说话——它边流边读,你随时开口打断。


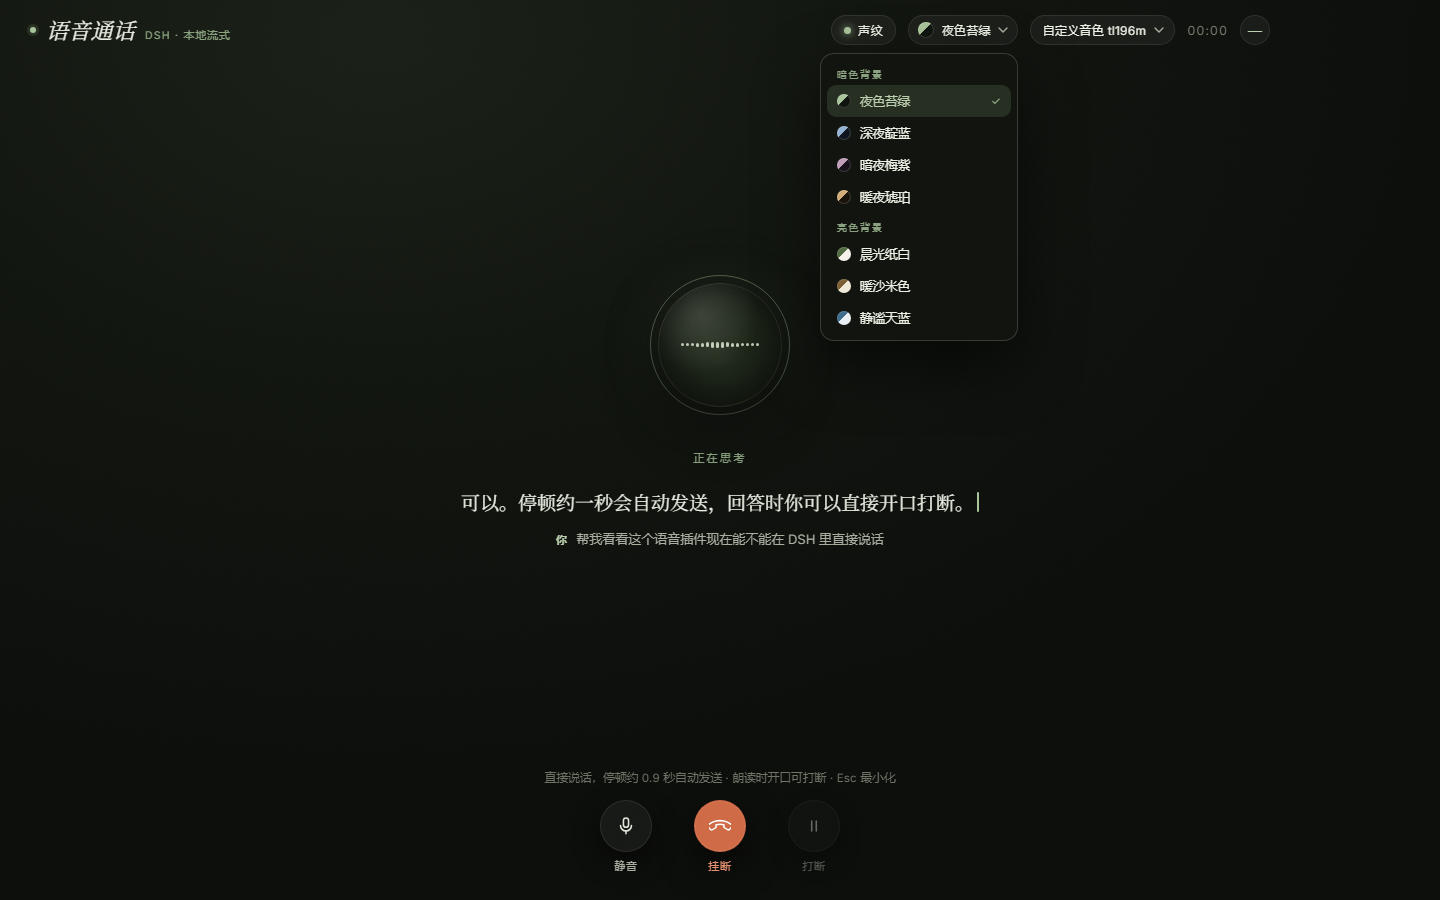
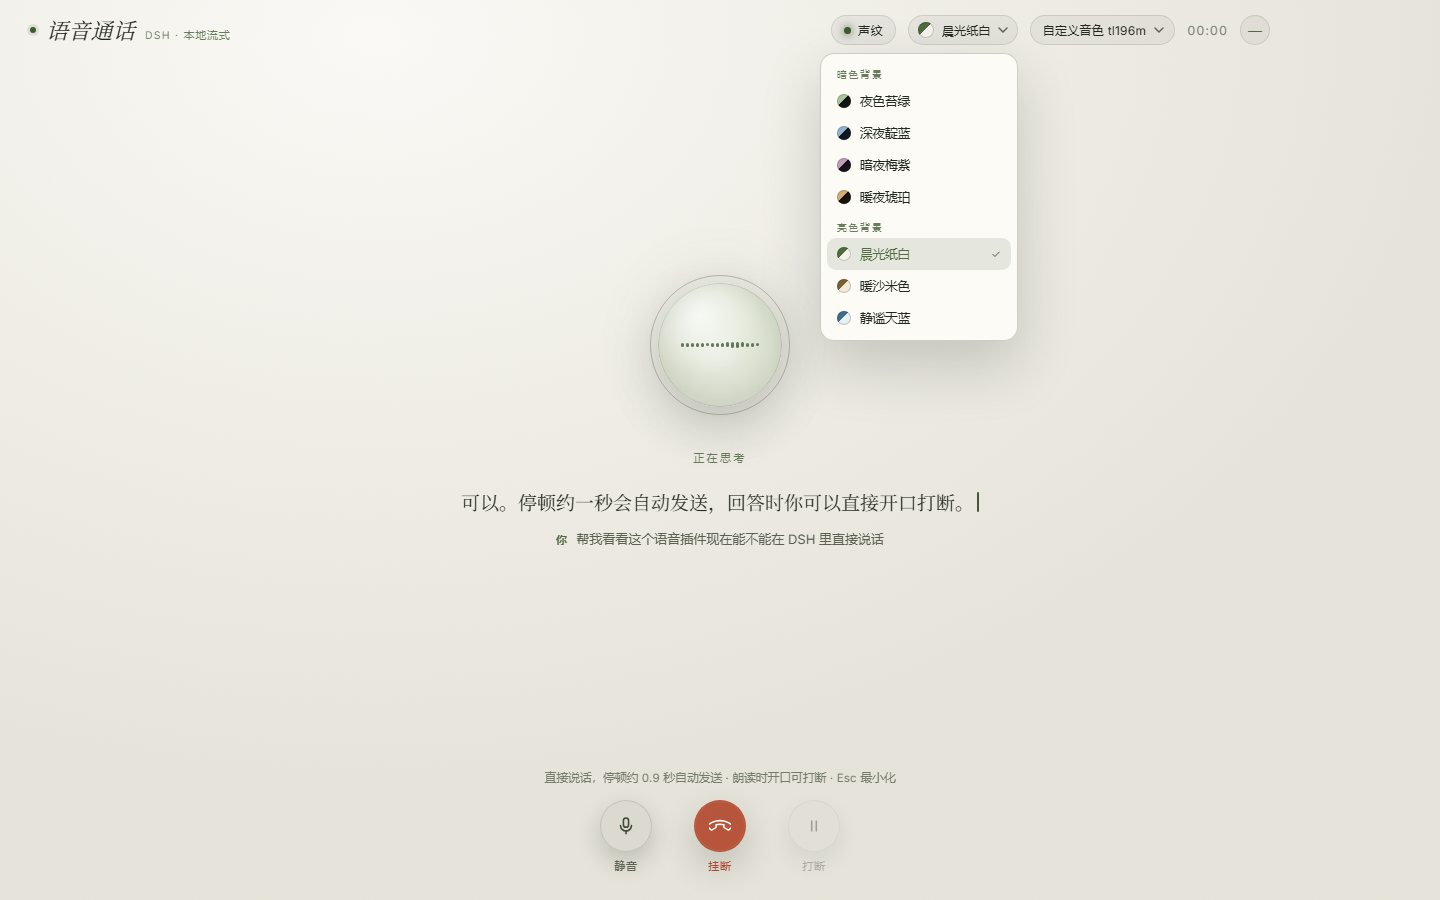
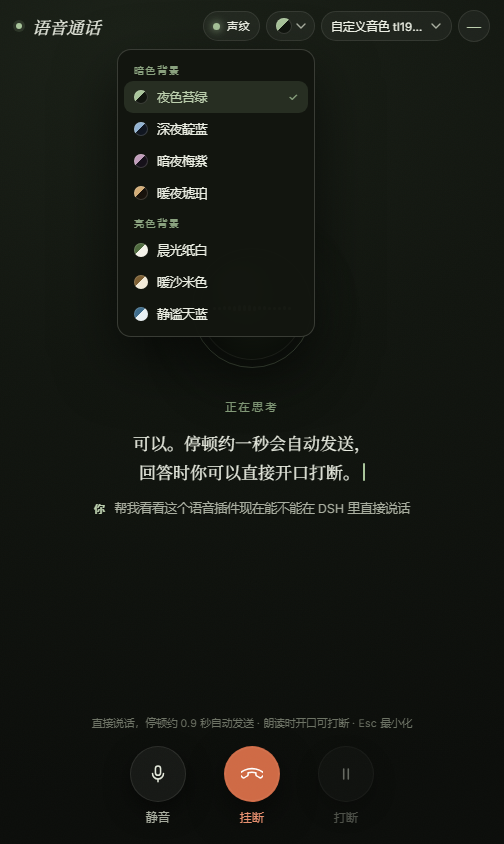
| 亮色主题(晨光纸白) | 手机窄屏(响应式) |
|---|---|
 |
 |
功能
- 全屏通话界面:说话 → 停顿约 0.9s 自动发送 → 回复流式字幕 + 语音朗读 → 开口可打断。
- 通话口吻:通话期间自动注入“像正常人说话”的固定规则(口语、短句、不列清单、不输出 Markdown/括号动作/AI 套话),挂断后恢复默认书面风格;配置
callPersona: false可关闭。 - 7 套背景主题:暗色 4 套(夜色苔绿 / 深夜靛蓝 / 暗夜梅紫 / 暖夜琥珀)+ 亮色 3 套(晨光纸白 / 暖沙米色 / 静谧天蓝)。选择立即生效并记忆;下拉框、字幕、球体配色一起切换。
- 可换模型:TTS / ASR 都是模型注册表——往目录里丢模型即可出现,支持热切换,不重启宿主。
- 模型下载器:
model.json声明下载清单,界面内显示进度;断点.part+ SHA256 校验;失败可重试。 - 本地优先:模型、音频、文本都不出本机;路由仅回环地址可用,并做 Origin 校验。
- 声纹锁(可选):注册自己的声音后,只回答你本人——别人的话照常转写显示,但不提交给会话。声纹 embedding 只存本地。
- 输入框小语音条:不打开全屏时也能看电平、字幕、结束/关闭;颜色跟随 DSH 主题变量。
- 响应式:桌面 / 窄窗 / 手机浏览器均可用;安全区、触控尺寸、横屏矮窗都有适配。
环境要求
| 项 | 要求 |
|---|---|
| DSH | >=0.2.0 <0.3.0-0(已在桌面 0.2.2-rc.1 实测) |
| Node | >=20(宿主自带;桌面端无需另装) |
| 模型 | 至少一个 TTS(朗读)或流式 ASR(听写);建议两者都配 |
快速开始
- 安装插件(见下一节),刷新 DSH 页面,输入框右侧出现 🎙。
- 模型:首次启动会自动下载包内示例音色
tl196m(约 161MB,分段 + SHA256 校验,可在配置里关掉); 也可以把模型目录放到$DSH_HOME/voice-local/models/下(结构见模型),或在模型下拉里选其它条目。 - 点 🎙 → 说话。首次会请求麦克风权限。
只配 ASR 也能用:插件会退化为「语音输入」,不朗读回复;只配 TTS 则用于手动朗读测试。
安装
方式 A:DSH 插件页(推荐)
设置 → 插件 → 从本地路径 / tarball 安装 dsh-plugin-voice-local-<version>.tgz,确认启用后刷新页面。
npm 包发布准备中;在此之前可从 GitHub Releases 下载 tarball 安装: https://github.com/god1sdfghjkl/dsh-plugin-voice-local/releases
方式 B:CLI
dsh plugin --profile <profile> add ./dsh-plugin-voice-local-0.9.8.tgz
# 或从 npm
dsh plugin --profile <profile> add dsh-plugin-voice-local
客户端 bundle 有缓存:升级后需要刷新宿主页面(F5)才能加载新 UI;host 侧会自动热更新。
模型
模型不随 npm 包分发。插件启动后按顺序探测:
- 配置里的显式路径(
ttsOnnx/asrStreamDir/sensevoiceDir,旧配置兼容) - 环境变量
VOICE_TTS_ONNX/VOICE_ASR_STREAM_DIR/VOICE_SENSEVOICE_DIR dataRoot标准目录(默认$DSH_HOME/voice-local,可用VOICE_DATA_ROOT覆盖)- standalone 项目目录(
onnx_out/tl196m_dyn.onnx、models/sherpa-onnx-streaming-*、xiaozhi/.../sensevoice)
目录结构
$DSH_HOME/voice-local/
└── models/
    ├── tts/
    │   └── melo-zh/                  # 每个子目录一个 TTS 模型
    │       ├── model.json            # 可选;省略则按文件特征探测
    │       ├── model.onnx
    │       ├── tokens.txt
    │       └── lexicon.txt
    └── asr/
        ├── streaming/<id>/           # 流式识别(实时字幕),必需
        │   ├── model.json
        │   ├── tokens.txt
        │   ├── encoder*.onnx
        │   ├── decoder*.onnx
        │   └── joiner*.onnx
        └── final/<id>/               # 整句定稿(更准、带标点),可选
            ├── model.json
            ├── model*.onnx
            └── tokens.txt
model.json
{
  "id": "melo-zh",
  "name": "MeloTTS 中文",
  "engine": "sherpa-offline-tts",        // TTS:vits2-onnx | sherpa-offline-tts
  "type": "vits",                        // sherpa: vits | melo | piper | matcha | kokoro | kitten
  "sampleRate": 44100,
  "files": { "model": "model.onnx", "tokens": "tokens.txt", "lexicon": "lexicon.txt" },
  "options": { /* 引擎参数;sherpa 引擎支持 "sherpa": {...} 直接透传 */ },
  "download": [                          // 可选:界面内下载
    { "url": "https://example.com/model.onnx", "path": "model.onnx", "sha256": "…", "bytes": 123456 }
  ]
}
ASR 的 model.json 额外支持 role(streaming / final)、type(流式 transducer;定稿 sense_voice / whisper / paraformer / transducer / nemo_ctc)。字段全部可省,省略时按文件名自动探测。
模型许可
模型权重许可与代码 MIT 分开。MeloTTS 为 MIT;SenseVoice 权重为 FunASR Model License 1.1;sherpa-onnx 官方模型多为 Apache-2.0;示例音色 tl196m 为 CC BY-NC-SA 4.0。详见 THIRD_PARTY_NOTICES.md 与 docs/models.md。重新分发前请自行核对许可与署名要求。
仓库 examples/models/ 内置了示例音色 tl196m 的下载清单(作者自训,CC BY-NC-SA 4.0);首次启动会自动下载,权重发布在 Releases · models-v1。
配置(cordis.patch.yml 的 config)
| 键 | 默认 | 说明 |
|---|---|---|
basePath |
/voice-local |
路由前缀 |
dataRoot |
$DSH_HOME/voice-local |
模型数据根目录 |
ttsModelsDir |
$dataRoot/models/tts |
TTS 模型目录(每子目录一个模型) |
ttsModel |
'' |
默认 TTS 模型 id;空 = 取第一个可用 |
ttsOnnx / ttsConfig |
'' |
旧方式:直接指 .onnx / config.json(兼容保留) |
asrModelsDir |
$dataRoot/models/asr |
ASR 模型目录(streaming/ 与 final/) |
asrModel / asrFinalModel |
'' |
默认流式 / 定稿 ASR 模型 id |
asrStreamDir / sensevoiceDir |
'' |
旧方式:直接指模型目录(兼容保留) |
sr |
44100 |
旧 ttsOnnx 方式的兜底采样率 |
ttsThreads / asrThreads |
4 / 1 |
推理线程数 |
autoStart |
true |
插件加载即预热模型 |
autoDownloadModels |
true |
首次启动且没有可用 TTS 时,自动下载示例模型(examples/models/) |
exampleModelId |
tl196m |
自动下载的示例模型 id |
llmTap |
true |
tap llm/stream 自动朗读 |
firstSegmentChars / maxSegmentChars |
6 / 16 |
首句 / 后续句长度 |
speed |
1 |
语速倍率 |
vadThreshold |
0.012 |
16k RMS 语音门限(自动断句) |
autoEndSilenceMs |
900 |
说完停顿多久自动提交 |
minSpeechMs |
200 |
至少说多久才算一句 |
bargeIn / bargeInThreshold |
true / 0.025 |
朗读期间是否允许开口打断及门限 |
voiceprintEnabled |
false |
声纹锁开关(也可在界面里切) |
voiceprintThreshold |
0.7 |
声纹余弦阈值(0~1,越大越严) |
voiceprintModel |
$dataRoot/models/voiceprint/campplus_zh.onnx |
声纹模型路径 |
voiceprintDataFile |
$dataRoot/voiceprint.json |
声纹 embedding 存储文件 |
使用
- 通话界面:点 🎙 打开;—(或
Esc)最小化但通话不中断;挂断 = 结束语音模式。 - 背景主题:顶栏左侧「主题」按钮(模型按钮左边),暗色/亮色分组,选择后立即切换并记住。
- 换模型:顶栏「模型」下拉,分组显示 TTS / 流式 ASR / 定稿 ASR;缺模型的条目会显示「可下载 xxx MB」,点一下开始下载。
- 静音 / 打断:底部按钮;朗读时开口也能打断。
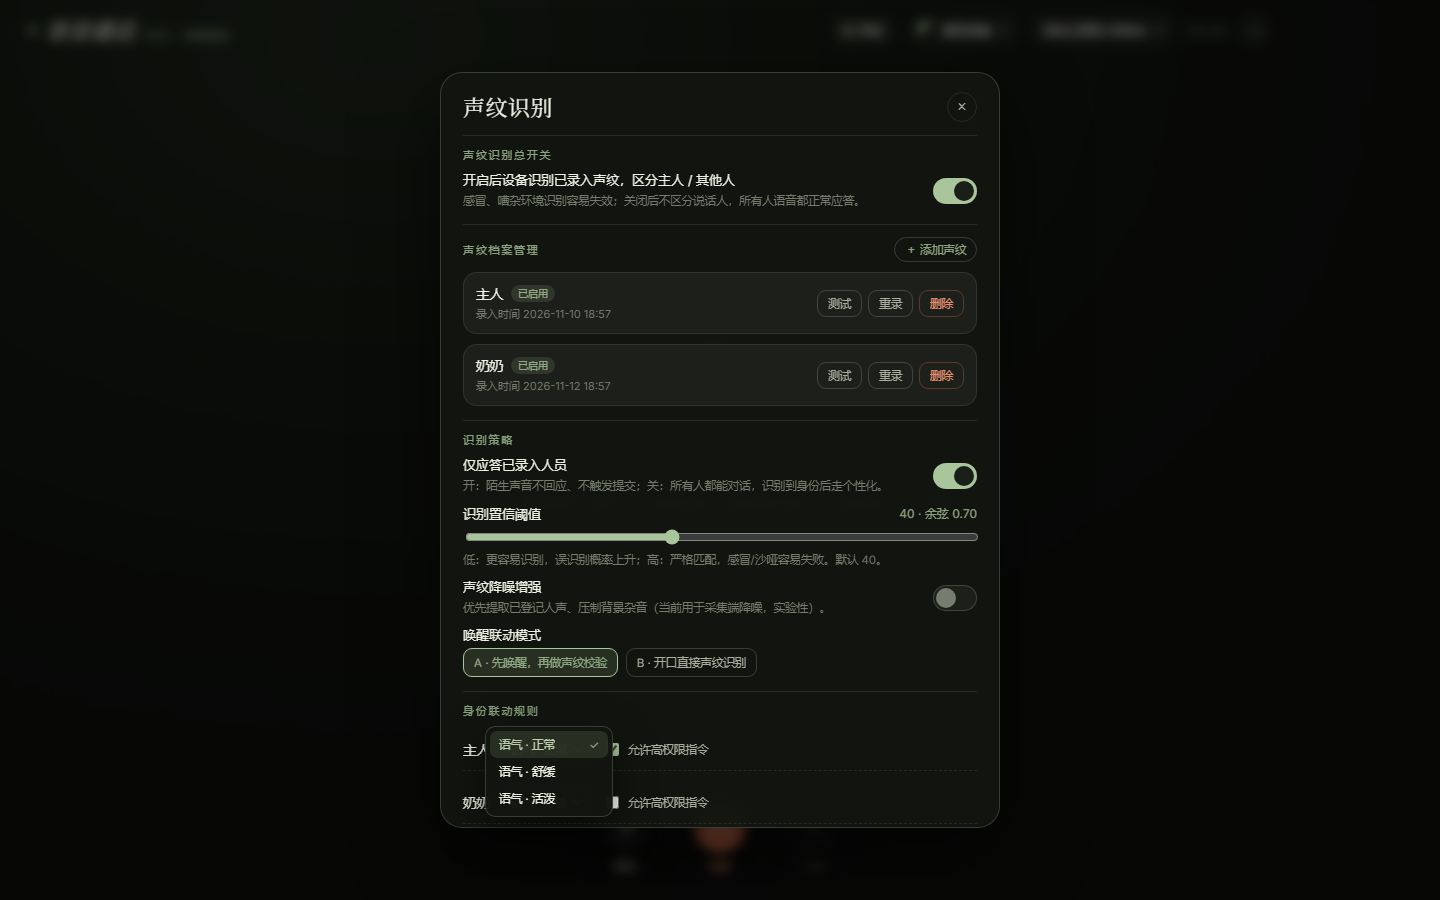
- 声纹设置:顶栏「声纹」按钮(主题左边)打开设置面板:总开关、最多 5 组声纹档案(测试/重录/删除)、随机 3 句录入(每句手动停止,防预录音频回放)、环境噪音检测、识别阈值滑杆(0–100,默认 40)、唤醒联动、身份联动(语气/高权限)。开启「仅应答已录入人员」后,陌生声音不提交给会话。
声纹锁说明

面板里的「语气」等下拉也是自绘主题组件,深色背景不会弹纯白菜单:
- 模型:3D-Speaker CAM++(中文 16k,Apache-2.0,约 28MB),首次点下载才拉取,不随包分发。 下载先走上游 sherpa-onnx Release,失败/校验不通过自动回退到本项目镜像,两者 SHA256 一致。
- 前端:Kaldi 兼容 80 维 fbank(纯 JS 实现,无需 Python),ORT 推理 192 维 embedding,余弦比对。
- 录入:每次随机抽 3 句提示语(服务端不校验朗读内容,靠随机挑战提高录音回放成本),每句手动点「停止并保存」,3 段各存一份模板、比对取最高相似度,单句最长 15 秒;环境噪音过大或三段差异过大时要求重录。
- 多档案:最多 5 组(主人/爸爸/奶奶…),每组有昵称、语气、高权限标记;
voiceprint.json存每组 embedding。 - 隐私:音频不落盘、不上传;
voiceprint.json只存归一化 embedding,可随时删除单组或清空。 - 局限:注册 3 句即可用,但嘈杂环境/感冒变声会降分;不同 TTS 合成音色之间相似度偏高,阈值不建议低于 0.65。当前「语气/高权限」只保存为档案元数据,供后续逻辑使用,尚未强制拦截指令。
HTTP 接口(同源,仅回环)
| 方法 | 路径 | 作用 |
|---|---|---|
| GET | /voice-local/status |
引擎状态、模型路径、版本、配置 |
| GET | /voice-local/models |
模型目录(TTS / ASR 角色、可用性、下载摘要) |
| POST | /voice-local/models/use |
热切换模型:{kind:'tts'|'asr', id, role?} |
| POST | /voice-local/models/fetch |
开始下载模型(SSE 进度) |
| GET | /voice-local/stream?voice=1 |
SSE:asr / tts / assistant / model 事件 |
| POST | /voice-local/asr/start | /asr/feed | /asr/final |
流式识别(PCM16LE @16k mono) |
| POST | /voice-local/speak |
文本转 WAV(手动测试用) |
| POST | /voice-local/cancel |
打断当前 TTS |
| GET | /voice-local/voiceprint/status |
声纹状态(模型/档案/开关/阈值/策略) |
| POST | /voice-local/voiceprint/enable |
开关声纹锁 {enabled} |
| POST | /voice-local/voiceprint/profiles |
新增声纹档案 {nickname, clips:[base64 PCM16×3], tone} |
| POST | /voice-local/voiceprint/profiles/reenroll |
重录 {id, clips, nickname?, tone?} |
| POST | /voice-local/voiceprint/profiles/update |
改昵称/语气/权限 {id, ...} |
| POST | /voice-local/voiceprint/profiles/delete |
删除档案 {id} |
| POST | /voice-local/voiceprint/settings |
识别策略 {requireEnrolled, thresholdSlider, denoise, wakeMode} |
| POST | /voice-local/voiceprint/test?id= |
用一段 PCM16/WAV 测试指定档案 |
| POST | /voice-local/voiceprint/enroll |
单档案兼容接口(PCM16LE 16k 或 16k WAV) |
| POST | /voice-local/voiceprint/verify |
试算相似度(同一音频格式) |
| POST | /voice-local/voiceprint/clear |
清空全部声纹 |
| POST | /voice-local/voiceprint/fetch |
下载声纹模型(SSE 进度) |
| GET | /voice-local/assets/* |
内置字体等静态资源 |
架构
- host 半(
lib/index.js):Cordis 插件,inject ['webServer'];模型注册表 + 下载器 +engine-manager,在worker_threads里跑 onnxruntime-node / sherpa-onnx;tapllm/stream做流式切句并广播 TTS 音频。 - client 半(
lib/client.js):DSH 客户端 bundle(window.__ModuleLoader__+slots),输入框语音条 + 全屏覆盖层;AudioWorklet 16k 重采样 + VAD →/asr/feed;TTS PCM16 经 SSE 播放。 - 安全:回环地址 + Origin 校验 + 请求体大小限制;模型下载校验 SHA256;不写系统目录。
手机 / dshgo / dsh-go
- 浏览器/手机端现在就能用:
client.js已做响应式(安全区、≥44px 触控、窄屏顶栏、矮窗横屏)。 - 手机浏览器访问需要 HTTPS 或 localhost 才能拿到麦克风;局域网
http://192.168.x.x会被 Chrome 拒绝。推荐 Tailscale / Caddy 反代或dsh web的本机模式。 - dshgo(DSH 口袋):Android App + 局域网反代插件(xiazhi88/dshgo)。App 的 WebView 主动拒绝网页麦克风(
onPermissionRequest一律deny),所以 App 内不能跑全双工;插件检测到非安全上下文会自动进入手机朗读模式(App 自带语音输入 + 本地 TTS 朗读回复);窄屏右下角还有独立「语音」浮动入口,手机浏览器可书签/voice-local/mobile直达语音。想要全双工,用手机浏览器 + Tailscale HTTPS 打开 dshgo 入口,或 fork App 放行音频权限。详见 docs/dshgo.md;手机本机跑模型的可行性见 docs/phone-local.md。 - 开源手机端 dsh-go(ccch1mneyyy/dsh-go)是另一套:App 内置 Linux + Node + 本机引擎,DSH 直接跑在手机上,插件装到“本机”。本插件 0.9.8 起随包带
dshGo原生清单:长按助手回复 →「朗读」,App 原生播放;ASR 用 dsh-go 官方本地 SenseVoice。这样模型在手机跑、不需要电脑;桌面/网页模式仍走原覆盖层。详见 docs/dshgo-native-adapter.md 与 docs/community-phone-options.md。
开发与测试
npm test                 # 全量(需要本机模型;否则模型相关用例会跳过)
node test/parity.mjs     # 文本前端与参考实现逐 token 对齐
node test/models-smoke.mjs
node test/downloader-smoke.mjs
node test/client-smoke.mjs   # 假 DOM/EventSource,验证 UI 与主题
node test/asr-smoke.mjs      # 需 VOICE_ASR_DIR / VOICE_SENSEVOICE_DIR
node test/host-smoke.mjs     # 需示例模型或 VOICE_* 环境变量
设计预览(不依赖 DSH):
node docs/preview/preview-overlay.mjs     # http://127.0.0.1:57999
# ?theme=day-paper  切换主题;?menu=theme 打开主题菜单;?debug 看断点尺寸
模型发布工具(零依赖):
node scripts/model-manifest.mjs --dir <模型目录> --base-url <下载根地址>   # 生成 download 清单
node scripts/split-model.mjs --file <大文件> --out-dir <分段目录> --base-url <地址> --chunk-mb 16
常见问题
- 点了 🎙 没反应 / 没声音:先看
/voice-local/status的lastError;再看是否授予麦克风权限、页面是否 HTTPS/localhost。 - 模型列表里没有我的模型:确认
model.json或文件名特征能识别,且目录位于models/tts/<id>或models/asr/{streaming,final}/<id>。 - 下载失败:检查
model.json的download[].url与sha256;国内网络可换 ModelScope/HF 镜像。 - 升级后界面没变:客户端 bundle 有缓存,刷新页面(F5)。
- 内存/速度:sherpa WASM 默认单线程;
ttsThreads可调。不要同时加载过多模型,按需热切换。
许可与致谢
- 本插件代码:MIT。
- 第三方代码/字体/模型:THIRD_PARTY_NOTICES.md。
- 感谢 dsh-voice-mode(AudioWorklet 重采样)、dsh-talk(VAD 纯函数)、sherpa-onnx、onnxruntime、MeloTTS 与 FunASR/SenseVoice 等开源项目。
- 设计参考:dsh-live-voice、DSH 官方插件(仅参考形态,未复制代码)。
版本
当前 0.9.8:新增 dsh-go 原生朗读适配(同包 dshGo 清单,长按回复即读,模型在本机引擎跑);另有声纹设置面板(CAM++ 28MB,本地注册/余弦比对,只回答本人)、顶栏上移 + 7 套背景主题 + 自绘下拉 + 模型下载器(分段/3 路并发/断点校验/首次启动自动下载示例)+ 手机响应式。变更记录见 CHANGELOG.md。
No comments yet. Be the first to write one.