书房 · dsh-weread-gather
把微信读书的账号数据同步到本地,在 DSH 侧栏里变成一个能翻、能搜、能回看的私人书房: 书架按大类陈列,每本书能展开自己的划线笔记与想法,总览页按年份联动展示阅读热力图与表盘。
- 侧栏入口「书房」(
sidebar.panellist,order 26),主面板同 key 打开 - 宿主侧持有 API Key 与全部数据,页面只读自己的同源 JSON 接口
- 不写回微读,不做任何上报;数据只落在本机
$DSH_HOME/weread-gather/
界面
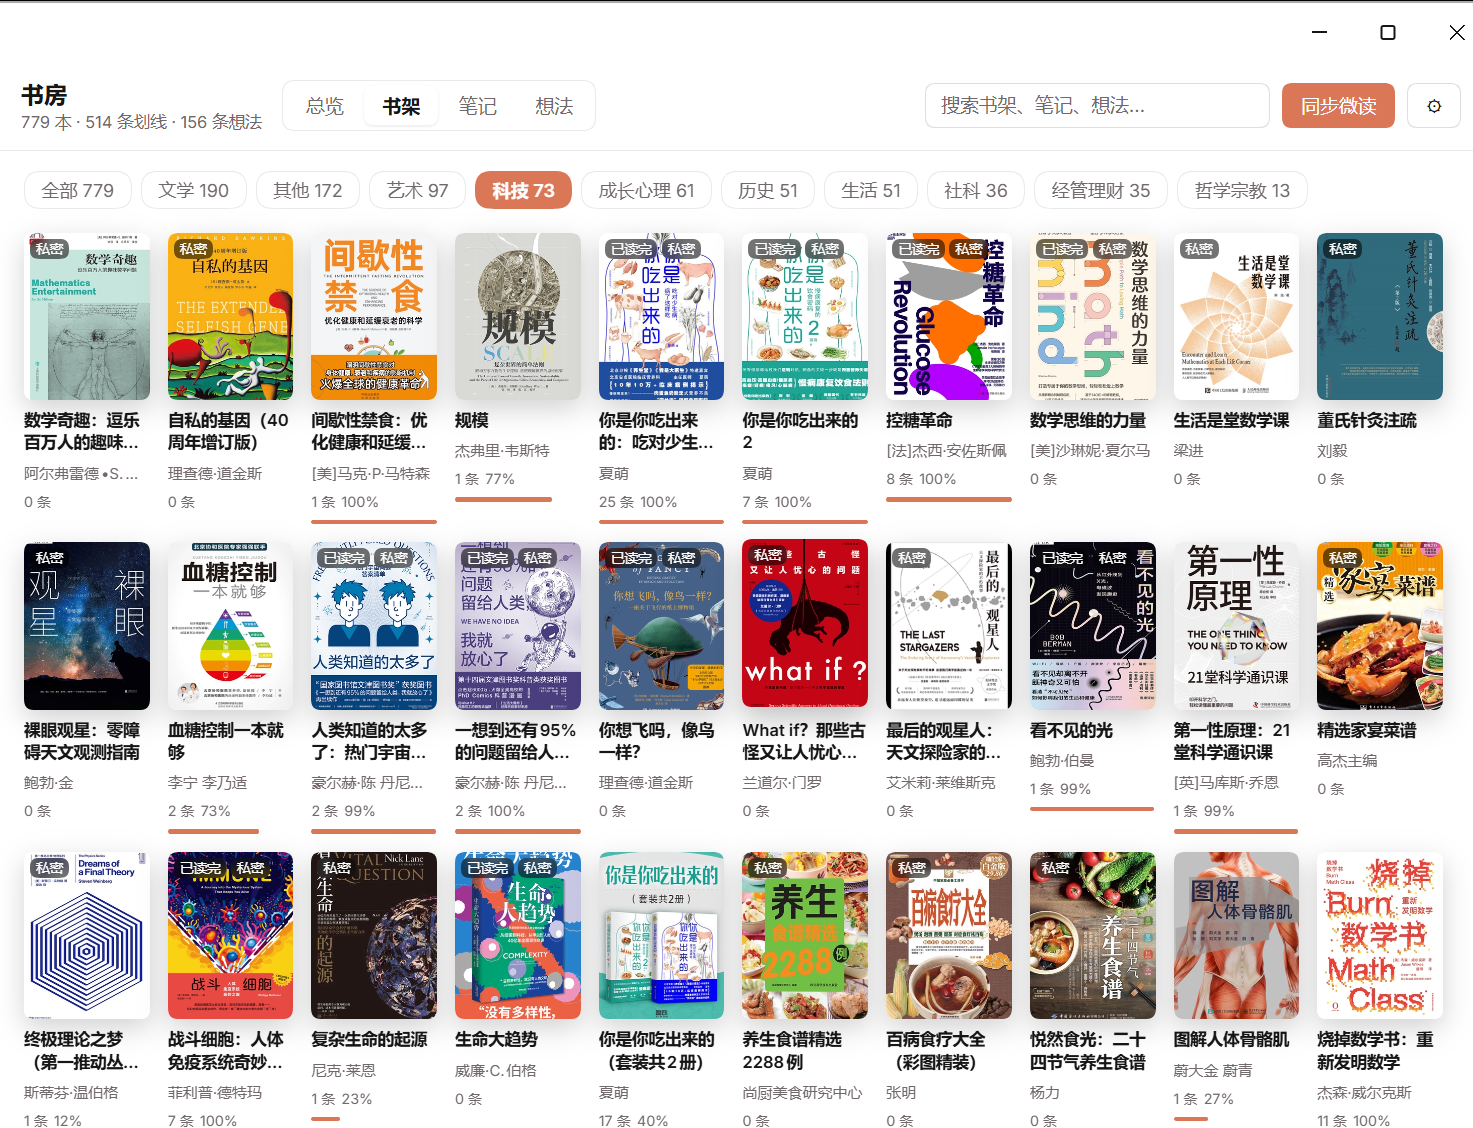
书架:10 个大类、每行 10 本,按年份与关键词筛选。
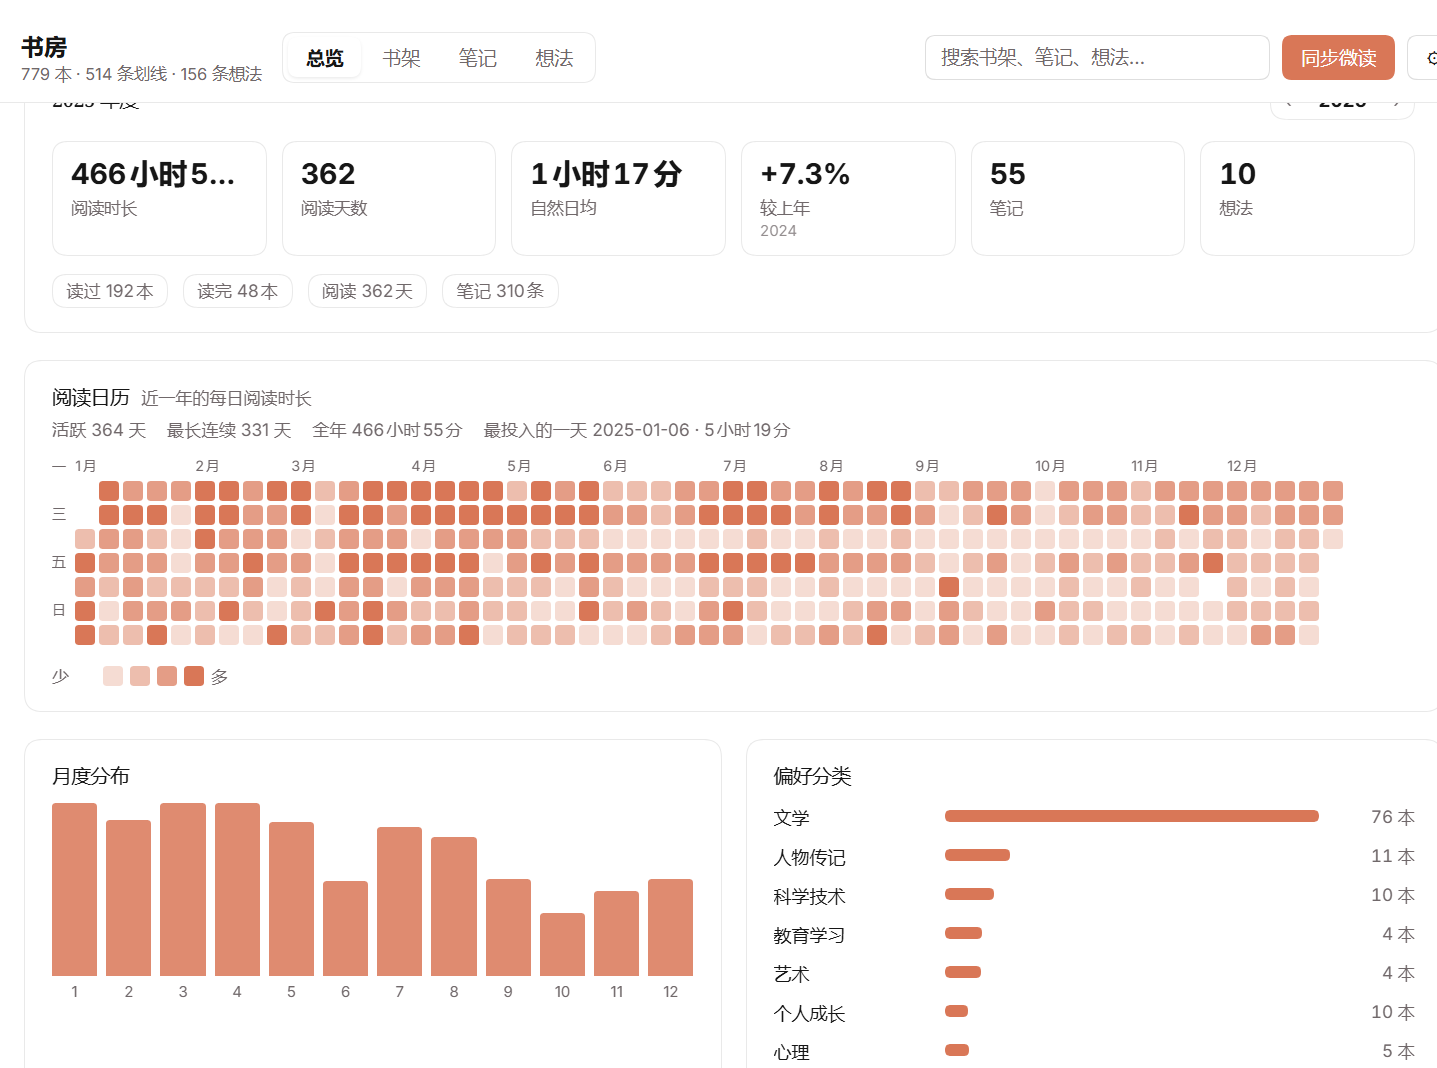
总览:置顶的年度阅读热力图,KPI、月度分布与表盘都跟着右上角的年份切。
安装
要求 DSH >= 0.2.2-rc.1(Web 端),插件是纯 JS、无构建步骤,装完重启即生效。
# 1) 从 npm 安装
dsh plugin --profile <你的 profile> add dsh-weread-gather

# 2) 或者直接从 GitHub 装
dsh plugin --profile <你的 profile> add github:fountainhead-gq/dsh-weread-gather
也可以把 Release 里的 .tgz 拖进设置页,或指向本地源码目录:
dsh plugin --profile <profile> add link:D:/path/to/dsh-weread-gather
装好后重启 DSH,侧栏出现「书房」。首次打开会让你填 微信读书 Agent 网关的 API Key(wrk- 开头):
- 优先读进程环境变量
WEREAD_API_KEY(DSH 应用进程里配好就不用手填) - 否则在「书房 → 设置」里粘贴,存到本机
config.json - Key 只在宿主侧使用,永远不会进入页面;
/state返回的是掩码
功能
| 区域 | 内容 |
|---|---|
| 总览(表盘) | 整页按年份联动:右上 ‹ 2026 › 切年,六格 KPI(阅读时长 / 阅读天数 / 日均 / 较上年 / 当年笔记 / 当年想法)、置顶的年度阅读热力图(365 天逐日、活跃天数 / 最长连续 / 全年时长 / 最投入的一天)、12 个月月度分布、偏好分类条、读得最多 8 本、偏好作者 6 位、文字/听书比例环形表盘;累计时段分布不随年份变化(接口只提供 all-time) |
| 书架 | 全部书籍按 10 个大类 陈列(文学/其他/艺术/科技/成长心理/历史/生活/社科/经管理财/哲学宗教),每行 10 本、窄屏自动降为 8/6/4 本;支持按书名/作者/分类搜索、按最后阅读年份筛选(也可直接在搜索框输入「2024」)、按最近阅读/笔记数/书名排序,卡片显示封面、分类、评分、出版社、出版年、笔记条数 |
| 笔记 | 全部划线按时间倒流,每页 24 条翻页、按书筛选、关键词搜索、单条复制、点卡片跳到该书详情 |
| 想法 | 想法卡片墙(瀑布流式多列),每页 20 条翻页、按书筛选、关键词搜索、单条复制、点卡片跳到该书详情(自动切到想法页)、星级与章节 |
| 书籍详情 | 封面、作者、大类 + 细分分类/读完/评分/出版社/出版年徽章、简介、该书全部划线 + 想法(每页 24 条翻页、可复制)、一键在微读打开 |
| 全局搜索 | 顶栏搜索同时搜书名、作者、分类、划线正文、想法正文,结果分组呈现 |
| 设置 | 展示 Key 来源(环境变量或手填)、书架上限、每本书同步笔记条数、单次补全书籍信息上限、清空数据 |
每一项(书架/笔记/想法/搜索/书籍详情内的列表)都有自己的搜索框;顶栏搜索是跨模块的全局搜索。
分类是怎么折到 10 个的
微读自己的分类是几十个叶子(文学-文学鉴赏 这种),直接铺成 chip 没法用。宿主侧按「-」前的上级前缀把每本书折进一个书架大类,book.group 存大类,book.category 保留叶子值(详情页和搜索仍用得到)。折叠表在 index.js 的 CATEGORY_GROUPS,改一行就能调;分组是加载时派生的,不需要重新同步。
数据从哪来
走微信读书的 Agent 网关(https://i.weread.qq.com/api/agent/gateway),全部只读:
/shelf/sync— 书架、分类、书单归档/book/info— 补全category / intro / publisher / publishTime / newRating(/shelf/sync的 category 大多为空,所以这一步很关键;一次 400 本,失败的 7 天后重试)/book/bookmarklist— 每本书的划线/review/list/mine— 每本书的想法/readdata/detail— weekly / monthly / annually / overall 四套阅读统计
热力图与年度视图不靠同步时的四套统计(它们的 dailyReadTimes 实测是空的),而是按需拉:
mode: 'monthly'+ 每月 1 号的baseTime→ 该月逐日秒数(readTimes),12 次拼成一整年mode: 'annually'+ 该年 1 月 1 日 → 年度聚合(时长/天数/日均/月度分布/偏好分类/偏好作者/读得最多)
这两类结果缓存在 heat.json:已过年份永久缓存,当年缓存 30 分钟后过期重取,所以切年份几乎瞬时。
数据落点与隐私
$DSH_HOME/weread-gather/
  config.json   手填的 apiKey、maxBooks、notesPerBook、metaLimit
  data.json     书架 + 分类 + 划线 + 想法 + 阅读统计
  meta.json     每本书的元信息缓存(bookId -> 分类/简介/出版社/出版年/评分)
  heat.json     逐年热力图与年度聚合缓存({ "2025": { v, at, days, annual } })
- 所有数据都在这一个目录里,插件不写别处;
data.json只在同步时整体重写,页面读内存副本 - API Key 以明文存在本机的
config.json(和许多本地 CLI 一样),只用它向微读网关发请求 - 插件不包含任何遥测、不上传任何内容;卸载插件后删掉这个目录即彻底清空
- 仓库里不含任何真实书籍数据或 Key(
.gitignore已排除这四个 JSON)
HTTP 接口
前缀 /dsh-weread/api(同源相对路径,客户端直接 fetch):
| 方法 | 路径 | 作用 |
|---|---|---|
| GET | /state |
是否已配置、Key 掩码、数据量、同步进度、各项上限 |
| GET | /data |
整份书房数据(含 years:可选的年份及各自总时长) |
| GET | /heat?year=2026 |
该年逐日阅读秒数 days + 年度聚合 annual(带缓存,见上) |
| POST | /sync |
触发一次同步(异步,立刻返回进度;用 /state 或 /sync 轮询) |
| POST | /config |
改 apiKey / maxBooks / notesPerBook / metaLimit |
| POST | /reset |
清掉手填的 Key |
路由注册在 ctx.effect(...) 里,插件停用/重载时会正确注销(早先直接 return disposer 是不生效的,会留下 duplicate prefix route 泄漏)。
开发自检
node --check index.js && node --check client.js   # 语法
node scripts/check.cjs                            # 组件引用 / locale 键对称 / 宿主-客户端契约 / 包身份一致性
node scripts/render-smoke.cjs                     # 用极简 hooks 运行时把 10 种视图各渲染一遍
两个脚本都不依赖浏览器:render-smoke.cjs 自建了极简 hooks 运行时,把 client.js 放进 vm 里逐个视图渲染,断言不会退化成加载态、笔记/想法必须带分页与复制控件。它默认读 ~/.dsh/weread-gather/data.json,可用 WEREAD_DATA 指到别的数据文件(需要一个已经同步过的数据集)。
已知限制
- 「其他」桶里的书是微读自己的数据缺口:多半是
CB_前缀的导入文档 / PDF,/book/info也不返回分类,无法自动归类。 - 笔记同步按「最近有笔记的 N 本书」(默认 60 本)展开,不是全量;把
maxBooks调大可多抓,代价是请求数线性增长。 /book/info实测不返回字数(文档有写、回包里没有),所以卡片上用的是出版年而不是字数。- 微读的
/readdata/detail只在mode: overall时给 24 小时时段分布,年/月/周都返回空数组,所以「阅读时段」那张图只能展示累计值,不随年份切换(标题里有标注)。 - 切到往年后,本周/本月两张卡会隐藏——它们本来就是「当前」的概念;往年的信息由年度 KPI 与月度分布承载。
- 当年热力图首次打开要发 13 个请求(12 个月 + 1 次年度聚合),之后读缓存;已过年份只发一次。
说明
非微信读书官方项目,只用只读接口读取你自己的账号数据。使用前请确认这符合你账号所在地的服务条款。
No comments yet. Be the first to write one.