dsh-compress-bench
先量,再信。
给 DeepSeek Harness 的上下文压缩做一次可复现的 A/B:同一个只读场景、同一个模型、同一组事实,压缩关跑一遍、压缩开跑一遍,把输入 token、轮数、工具调用成功率、事实覆盖和最终答案差异一起写进 JSON,再画一张对比图。
本机实测(2026-10-28,large-read,chenyuzhiyun/deepseek-flash):本地估算输入 token 63,029 → 6,927(−89.0%),轮数 3 → 3,事实覆盖 3/3 → 3/3,最终答案相似度 1.00。这是单个场景、单次运行、固定「先关后开」顺序的结果,不是通用结论。
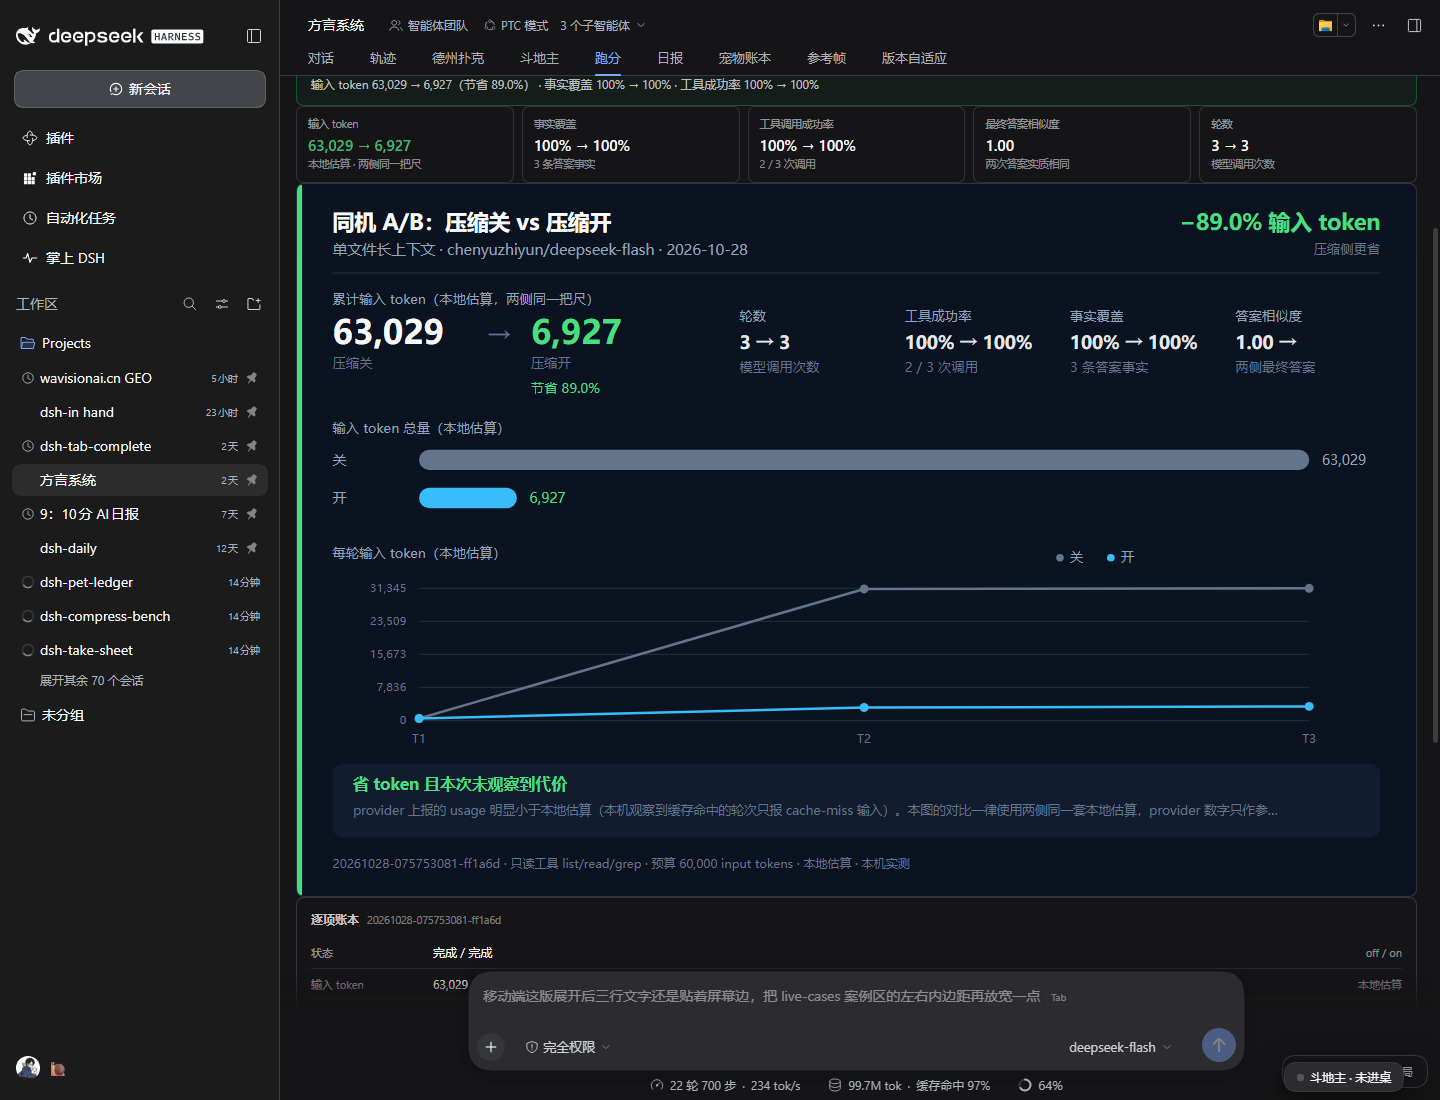
原始报告:docs/sample-report.json · 独立 SVG:docs/sample-chart.svg

它是什么,不是什么
是:一个装在 DSH 里的「量具」。它用只读沙盒场景把同一场对话镜像跑两遍,只改变一件事——工具结果在交给模型之前是否被压缩。它自己不做生产压缩策略。
不是:又一个压缩插件,也不是「我们省了 20%」的宣言。它不承诺任何固定节省比例;它输出的是这次运行的真实数字、原始证据和代价项。
本项目独立实现,没有 fork、没有克隆、没有复制 drscrewdriver/dsh-context-compression-improved 的代码。插件骨架沿用作者自己的 dsh-warden 约定(零依赖、cordis.patch.yml、host/client 双半),与参考项目无代码复用。
参考项目本身是一个成熟的压缩选择器(它是 WilliamShi666/dsh-context-compression-selector 的改进 fork),已经带有压缩监控和自己的一套节省统计。本项目不复刻它的策略;它回答的是另一个问题:
把压缩关掉再打开,同一场对话的 token 确实少了,那答案有没有因此变差?
本机这次实测
| 指标 | 压缩关 | 压缩开 |
|---|---|---|
| 本地估算输入 token | 63,029 | 6,927 |
| provider 上报 usage | 601 | 508 |
| 轮数 | 3 | 3 |
| 工具调用 / 成功 | 2 / 2 | 3 / 3 |
| 输出 token | 177 | 177 |
| 事实覆盖 | 3/3 | 3/3 |
| 最终答案相似度 | — | 1.00 |
| 压缩改动 | 0 次 | 1 次,119,032 → 9,573 字符 |
| 耗时 | 3.0 s | 2.6 s |
结论栏写的是「省 token 且本次未观察到代价」,同时报告保留了两条警告:
- provider usage 不能跨侧直接比较。 同一轮里 provider 只报了
601input tokens,本地估算却是63,029;原因是本机 provider 在缓存命中的轮次只统计 cache-miss 输入(同一请求甚至出现过167vs489)。拿小数字当真实输入,会算出 94.8% 这种假节省。因此本项目的头条指标一律使用两侧同一把尺的本地估算,provider 数字只作参考单列。 - 压缩侧多了一次工具调用(3 vs 2)。 这是延迟和调用成本,不体现在输入 token 里;报告没有把它藏掉。
为什么省了 89%
large-read 的 docs/handbook.md 约 90 KB。压缩关时,模型每一轮都要重新接收整份工具结果;压缩开后,第一次 read 的结果被裁到约 9.5 KB,后续轮次不再携带被丢掉的中段。这是长工具结果场景的预期收益,不等于所有会话都能省 89%。
怎么测
- 镜像:两侧各自新建消息数组,system、task、工具 schema、模型、
temperature: 0完全相同,先跑关、再跑开,跑完即销毁。 - 只读沙盒:场景只能用
list/read/grep,只读$DSH_HOME/compress-bench/fixtures/下生成的固定 fixture;绝对路径、..逃逸、符号链接逃逸都会被拒绝。不写真实工作区、不起子进程。 - 埋事实:
large-read把三个可验证值分别放在手册头部、中段、尾部;multi-file的 TODO 总数、最高版本和最长文件需要跨 12 个模块汇总。压缩丢掉中段时,事实覆盖会立刻掉下来,而不是只看 token。 - 评答案:事实按不区分大小写的完整值匹配;最终答案再做一次归一化后的字符 bigram 相似度和逐行 diff,避免把排版差异当成语义差异。
- 算代价:事实覆盖下降、工具成功率下降、轮数增加、输出 token 明显增加、最终答案出现只在一侧的行,都会进入 verdict 或 warnings。
- 预算:每轮模型调用前检查累计输入 token、轮数、工具调用数、墙钟时间;任一超限就把该侧标成
budget-stopped,不把半截运行当结论。
压缩器是谁
优先使用宿主暴露的 toolResultPruner.pruneContent(blocks)。如果当前 profile 没有暴露这个服务,就退回到内置的 line-reducer:单条工具结果超过 12,000 字符时,保留约 60% 头部和 20% 尾部,中间替换成一行显式省略标记。
本机这次运行的压缩器是 line-reducer,不是 toolResultPruner。 面板顶部的「压缩器」标签和 JSON 里的 runs.on.compression.reducer 都会如实记录;不同 reducer 的数字不能混着比。
安装
需要 DSH >=0.2.1-rc.2 <0.3.0 和 Node 24(CI 用 22 验证兼容)。
git clone https://github.com/dingchenhui0618-arch/dsh-compress-bench.git D:\Projects\dsh-compress-bench
cd D:\Projects\dsh-compress-bench
node scripts/build.mjs
node --test test/*.test.mjs
然后在 DSH 的插件管理里安装本仓库(本地目录或 github:dingchenhui0618-arch/dsh-compress-bench),启用后打开任意会话,顶部页签会出现「跑分」。
桌面版 profile 由 Electron 托管,CLI 的
dsh plugin --profile desktop会拒绝管理;请走应用的插件管理界面。安装/启用后若页签没出现,重载一次插件或重启 DSH。
使用
- 打开任意会话,点顶部「跑分」。
- 选一个场景(单文件长上下文 / 多文件中段聚合)。
- 点「开始 A/B 跑分」。运行中可以取消;同一时间只允许一个运行。
- 完成后看结论条、五个指标、对比图、逐项账本、答案差异和警告。
- 历史运行在下方,可点开旧报告并下载 JSON / SVG。
预算默认值(可由 host 配置覆盖):输入 token 60,000 / 轮数 6 / 工具调用 12 / 墙钟 180 s。预算是每轮调用前检查累计值,最后一轮可能让总量略超预算,报告会如实显示。
产物
运行结束后写到 $DSH_HOME/compress-bench/runs/:
<id>.json:schemadsh-compress-bench/report@1,包含两侧每一步的 token、轮数、工具调用/失败、压缩统计、最终答案、事实命中、delta、verdict 和 warnings。<id>.svg:880×560 的自包含对比图。
报告只保存 fixture 的指纹、文件名和字符数,不保存绝对路径,也不保存完整消息记录;docs/sample-report.json 可以直接对照。
开发
零运行时依赖。node scripts/build.mjs 把 src/host.js 复制为 lib/index.js、拼装 lib/client.js 并内联 CSS;pnpm/npm 安装不是必需的。
node scripts/build.mjs
node --test test/*.test.mjs   # 18 个测试,全绿
node scripts/preflight.mjs    # 密钥 / .gitignore / 无关文件
测试覆盖:镜像 A/B 与「中间事实被压缩丢掉」、token 预算与轮数预算停止、模型报错、只读工具路径逃逸、fixture 确定性与埋点真实性、pruner 优先与 line-reducer 回退、答案归一化与相似度、图表转义、host 路由/并发/取消/卸载/无 LLM 拒绝。
与参考项目的具体差异
| 维度 | 参考项目 dsh-context-compression-improved |
本项目 dsh-compress-bench |
|---|---|---|
| 定位 | 压缩策略插件(选择器 + 代码骨架门控 + 监控) | 测量工具:测宿主/内置压缩器的效果 |
| 证据形态 | 自己的压缩统计与监控面板 | 镜像 A/B 原始 JSON + SVG + 事实保真检查 |
| 是否控制变量 | 面向真实会话做压缩 | 固定只读场景、固定模型、temperature: 0、先关后开 |
| 代价项 | 主要是 token / 成本节省 | 同时记录轮数、工具成功率、事实覆盖、答案差异 |
| 安全边界 | 压缩策略本身的行为 | 只读工具、fixture 沙盒、预算停止、可取消 |
| 代码关系 | 本项目未 fork、未复制其代码 | 独立实现,骨架来自作者自己的 dsh-warden |
局限
- 单个场景、单次运行、固定顺序,不是统计显著性结论;换模型、换样本、换顺序都可能不同。
- 本地估算用「CJK ≈ 1 token/字,其余 ≈ 4 字符/token」的启发式,不是官方 tokenizer;两侧同一把尺,但绝对值会偏。
- 压缩器取决于宿主暴露了什么;本机这次是
line-reducer。 - 场景是合成的固定 fixture,只代表「长工具结果」这一类压力,不代表日常短会话。
- 报告里的 provider usage 可能只含 cache-miss,不能当真实输入总量。
许可与致谢
MIT,见 LICENSE。
- 问题意识来自 drscrewdriver/dsh-context-compression-improved,其上游是 WilliamShi666/dsh-context-compression-selector(均 MIT)。本项目未复用其代码,也未保留其版权声明之外的任何内容。
- 插件骨架参考作者自己的 dsh-warden。
- 与 DeepSeek 官方无隶属或背书关系。
安全边界与报告不含凭据的承诺见 SECURITY.md。
No comments yet. Be the first to write one.