记忆星云 · dsh-memory-nebula

给 DeepSeek Harness 桌面端用的长期记忆插件。
English — A self-writing memory plugin for DeepSeek Harness: it decides what to remember on its own, then recalls by topic before each turn. Pure local, zero dependency, no model, no API. Retrieval is lexical (2-gram + IDF + inverted index + co-occurrence learning), deterministic and explainable — every hit tells you which words matched and in which field. Ten tools plus an interactive star-nebula canvas in the sidebar.
v0.2.5 · MIT · 零依赖 · 纯本地 · 不调模型 · 不联网
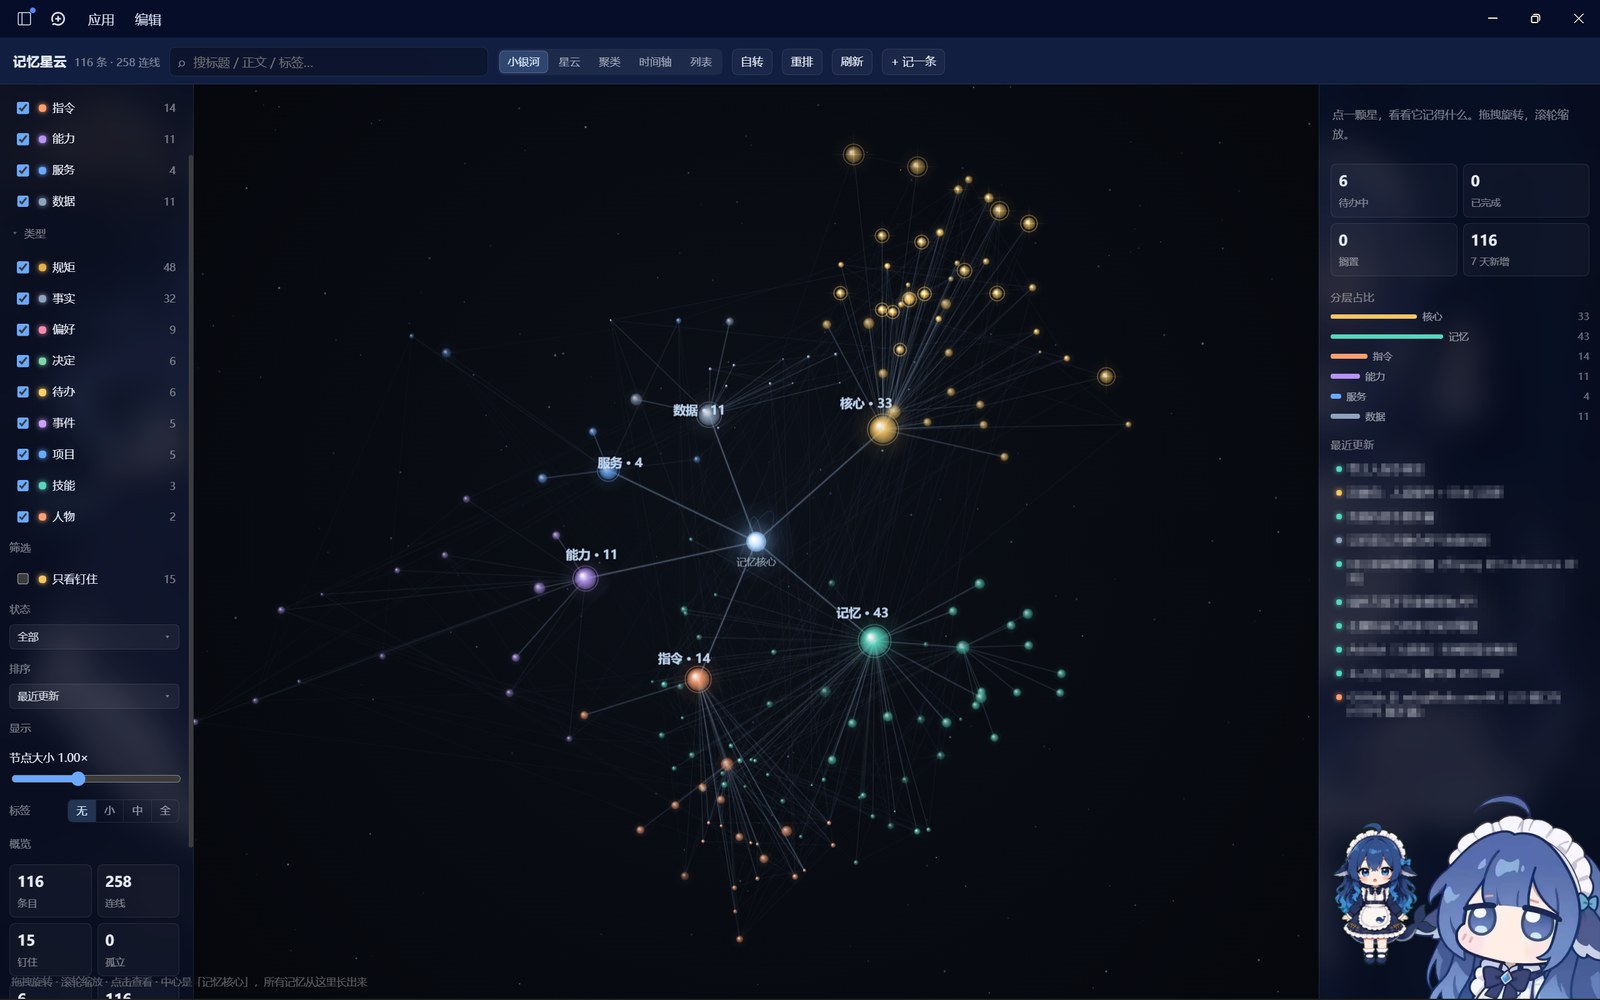
真实界面截图。标签密度关到「无」,所以只看得到节点和分类,看不到具体记忆内容。
聊到第五十轮,模型只看得见最近几屏。
上周三你随口说的那个口味、那台机器上踩过的坑、那个你不想再提的名字——它还记着。
不是记事本。它会自己记事、自己按话题想起来——每轮对话前,拿你刚说的那句话去记忆库里翻,只把真正相关的那几条送回上下文。
- 平时它不说话。翻不到相关的,它就只回一句「这一刻没有相关的」,不占思考
- 记忆像人一样会淡:45 天半衰期,常被想起来的更牢,钉住的不衰减
- 侧栏一张能转、能点、能钻进去的星云图,五种看法
- 整个插件只有一个
graph.json,没有服务、没有网络、没有模型
为什么需要它
上下文窗口是有限的。聊得越久,模型越只看得见最近几屏,人会「忘事」。
把值得长期记住的东西(偏好、决定、教训、人物、待办)抽成独立节点存下来,每轮只挑跟当前话题相关的几条送回去——等于给模型装了一层可检索的长期记忆,而不是把所有历史堆进 prompt。
实测:一百多条记忆,每轮只注入 5 条、约 500 字,上下文占用恒定,跟库多大无关。
检索是怎么工作的
这是整个插件最要紧的部分。一次 memory_search 走七步:
1. 归一化 — 全角转半角、统一大小写和空白。B站 / B 站 / b站 落到同一个词上。
2. 粗分词 — 中文没有天然词界,用 2-gram(相邻两字),再做两轮清洗:丢掉停用词,丢掉含虚词的 2-gram(人的、是的)。英文和数字按完整词切。
3. IDF 加权 — 越罕见的词越说明问题。插件 几十条里都有,权重低;pnpm 只两条有,权重高。字段也有层级:标题 ×6、标签 ×4、正文 ×1.5。
4. 倒排索引 — 词 → 出现在哪些记忆里。查询先收窄候选,不做全表扫,库大了也不卡。
5. 共现学习 — 从已有记忆里学:哪些词总出现在同一条的标题或标签里(b站 和 bilibili、桌面端 和 启动),查询时按 0.45 权重补进来。库越大越准,纯统计。
6. 顺着连线联想 — 字面命中之后,沿记忆之间的连线扩一跳。这是「想起 A 顺带想起 B」。
7. 相对门槛 — 不凑数:比第一名低 58% 以上的直接丢掉。宁可只回 2 条,也不拿不相干的填。
最终打分:
score = 字面(归一化) × 1.0
      + 联想 × 0.5
      + 可及性 × 0.22        ← 权重 × 活跃度 × 钉住,只做微调
      + 新鲜度 × 0.1
为什么不用 embedding
因为一个插件不该要求你配模型、配 key、联网、按量计费。
上面这套做法在「记忆以百计、查询是你自己的日常问法」这个规模上足够好,而且确定:同样的库、同样的查询,结果永远一样,每一步都能指着具体词解释。
记忆是怎么活的
每条记忆有四个数:
| 字段 | 含义 |
|---|---|
weight |
重要程度,0~1,写下时给定 |
act |
激活强度,被想起来就上升,按小时级半衰期衰减 |
strength |
记忆强度,每想起一次涨一点,衰减更慢 |
hits |
被想起过多少次 |
很久没被想起来的会自己沉下去(不删,还在图上);钉住的(pinned)不吃衰减。
这层是照人脑的样子做的:常用路径越走越宽,冷门路径慢慢长草。
十个工具
| 工具 | 干什么 |
|---|---|
memory_save |
记一条。自动去重、自动和相似记忆连线;closes 顺手收掉一条待办 |
memory_search |
检索。返回 belongsTo(属于哪层哪类)和 links(连着的几条);before 可以只看某个日期之前的记忆 |
memory_get |
按 id 取全文,连带邻居 |
memory_link |
手动连两条 |
memory_forget |
删掉一条(连同连线) |
memory_pin |
钉住 / 取消钉住 |
memory_stats |
总量、连线、孤立、各层各类分布 |
memory_merge |
同一件事记了两遍,合成一条:正文去重拼接、标签并集、连线重定向 |
memory_export |
导出成可迁移的 JSON(可只导某一层或某一类) |
memory_import |
导入导出的 JSON,已存在就更新,不存在就新建 |
自动连线只在标题语义或标签重合时才连,并且按 IDF 加权——越是大众词越不算数。这样连出来的都是真亲戚。
界面
侧栏一张可交互的星云,五种看法:
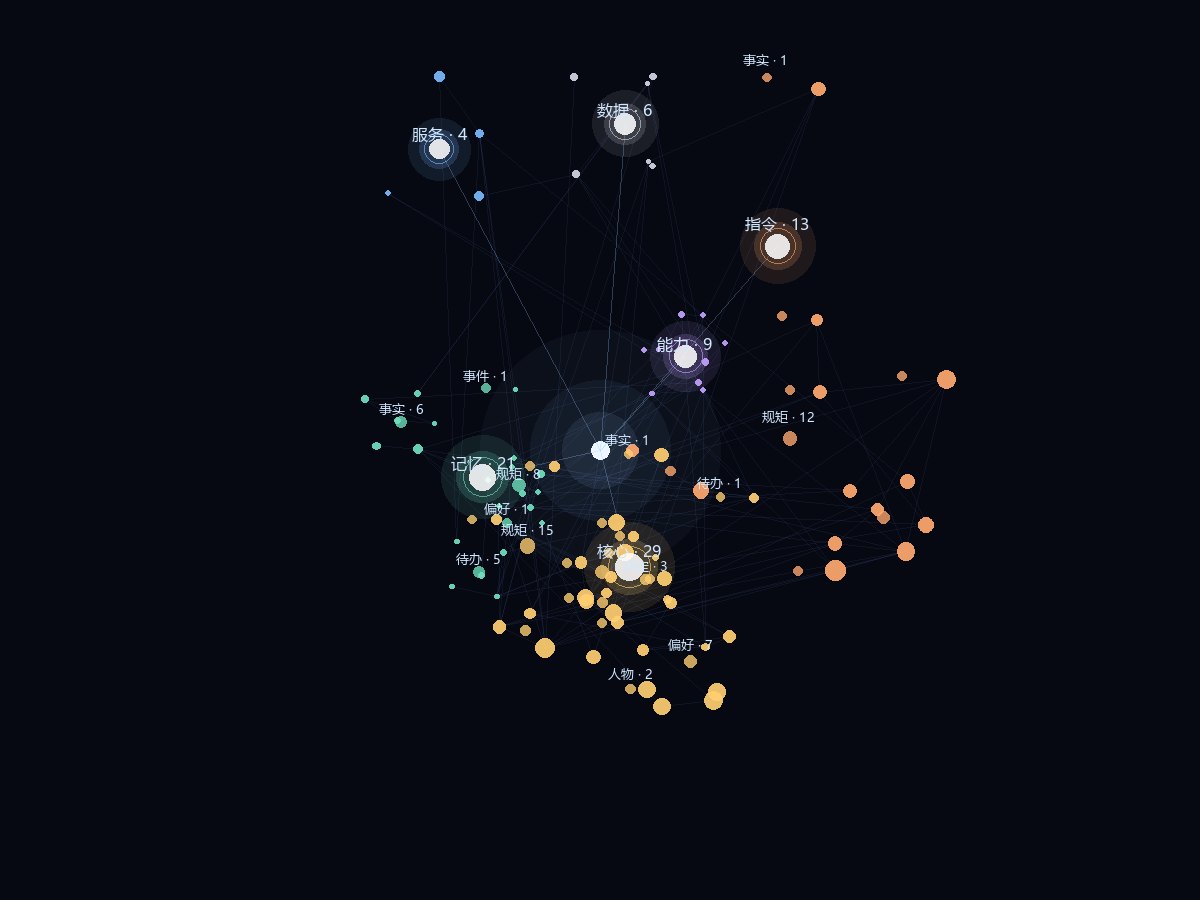
- 小银河 — 中心核 + 星系臂,六个大类各是一颗行星,自己转
- 星云 — 3D 力导向。层级按内容自动递归:某一团太大且还能分类,就自己再往下分一层,不固定层数
- 聚类 — 同类型抱团
- 时间轴 — 一行一层,从左往右是时间
- 列表 — 分组、折叠、按层按类看
交互:点类别自动聚焦,以那个点为新核心重排;点具体记忆就飞到中心并放大,相关记忆环绕周围。拖拽旋转带惯性,悬停出卡片。
左栏:分层开关、类型开关、状态与排序、节点大小与标签密度、概览统计、分层占比。 右栏:详情(权重 / 活力 / 想起次数 / 连线 / 记于改于)+ 同层与同标签的邻居 + 统计 + 最近更新。
检索的可解释性
搜索框里的词不是简单过滤,走的是完整检索,而且把理由写在每一条上:
- 列表里每条显示「命中 桌面端插件 · 安装 · plugin」,告诉你被哪几个词、打在标题还是标签上命中
- 星云里命中的节点描一圈亮边、半径放大,其余淡下去,一眼看出这次搜到了哪一簇
- 排序用真实相关度,不是过滤后凑数
这就是不用 embedding 也能「说得清为什么」的方案:每一步都能指着具体词解释。
安装
要求 DSH 桌面端。
dsh plugin --profile desktop add link:/path/to/dsh-memory-net
或放进 ~/.dsh/plugins/,用插件管理器安装。装完重启 DSH,协议、面板、工具都会自动注册。
装好之后是空的。 仓库里只有代码,没有一条记忆——第一句值得记的话进来,它才创建 ~/.dsh/memory-net/graph.json,从 0 条开始长。上面截图里那 116 条是作者自己用了几天攒的,不会跟着插件走。
想搬走或者搬过来,用 memory_export / memory_import;想换存放位置,设环境变量 DSH_MEMORY_NET_DIR。
数据
全部在 ~/.dsh/memory-net/graph.json:
{
  "version": 1,
  "nodes": [{ "id": "m_xxx", "title": "...", "body": "...", "layer": "core", "kind": "rule",
              "tags": ["坑"], "weight": 0.8, "pinned": true, "status": "",
              "createdAt": 0, "updatedAt": 0, "hits": 0, "act": 0, "strength": 1 }],
  "edges": [{ "from": "m_a", "to": "m_b", "kind": "related", "weight": 0.6 }]
}
写入是原子的(tmp → rename),写失败不脏盘。删掉这个文件等于清空记忆。
结构
lib/index.js     host:7 个工具、每轮注入、/api/dsh-memory-nebula 路由
lib/store.js     存储、检索打分、连线、衰减、注入文本
lib/client.js    侧栏面板与画布(React + Canvas 2D,无第三方依赖)
cordis.patch.yml 挂载点
零运行时依赖。
测试
npm test
四套纯 Node 测试:边界与异常 52 项、五种视图 × 四种聚焦的布局矩阵、组件渲染冒烟(专门抓 node --check 查不出、只在真机白屏的那类错)、数据进出是否原样(500 条批量导入后逐条核对字段、导出再导入等价)。CI 在 Node 20 / 22 上自动跑。
License
MIT
No comments yet. Be the first to write one.