dsh-team-autopilot
Deterministic auto-dispatch for the native Agent Teams seam (ctx.agentTeams).
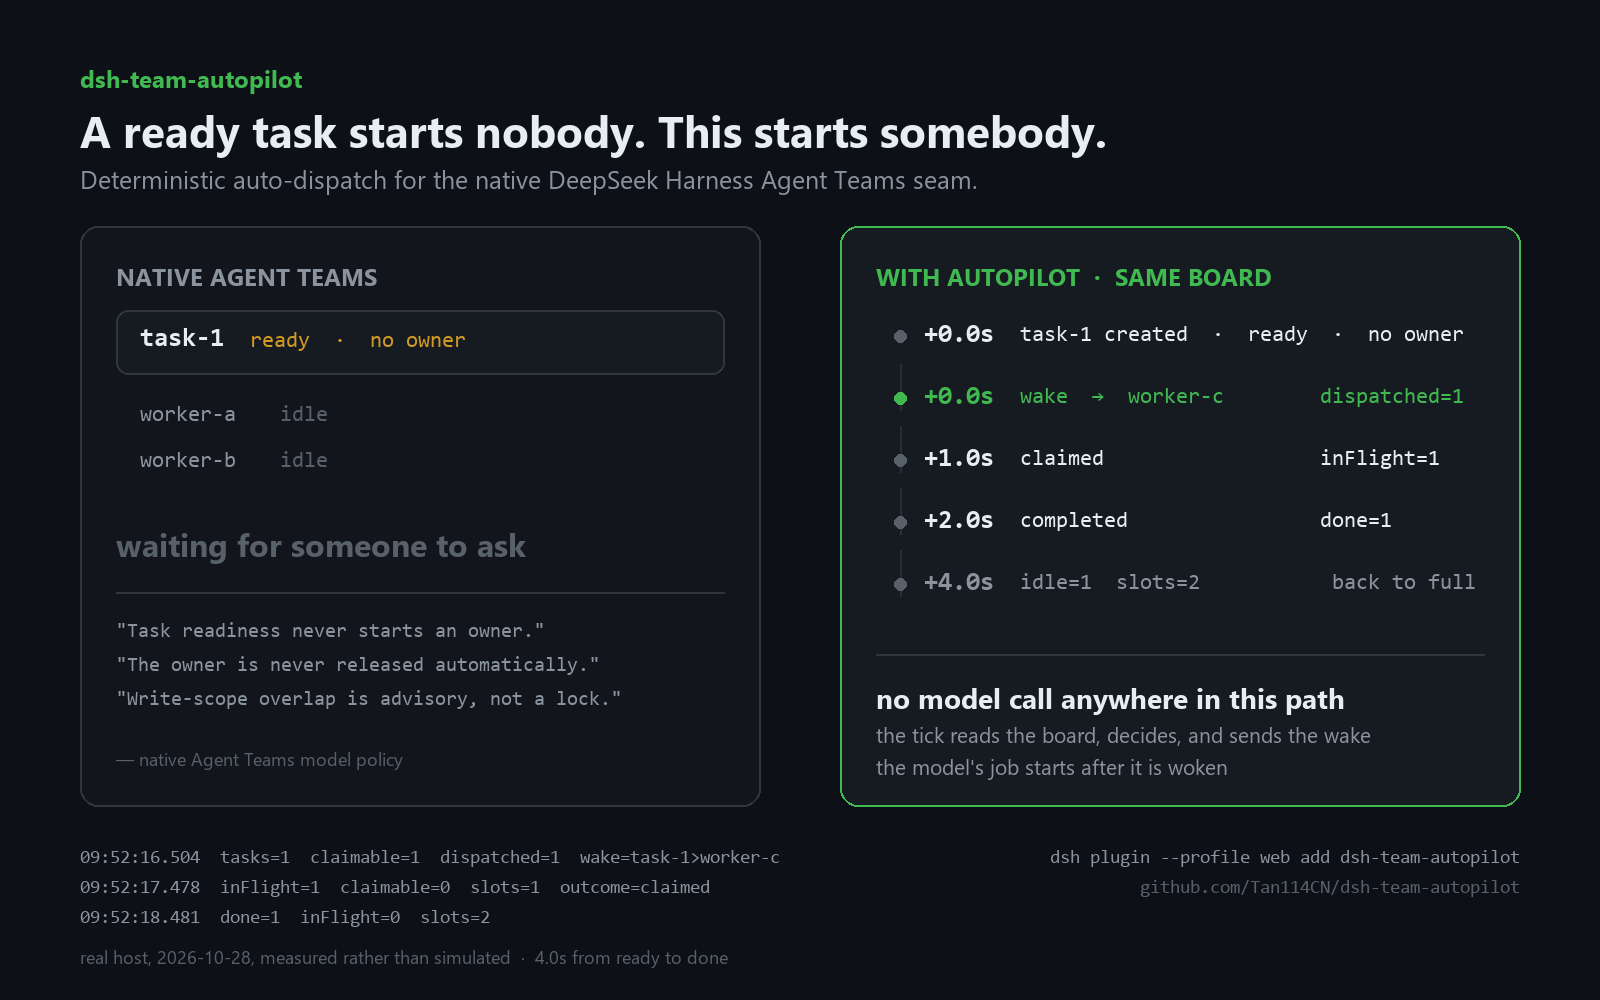
上图的右侧不是示意:底部三行是 2026-10-28 真机日志的原样字段,可对照 真机验证记录。图由 scripts/render-assets.py 从这些字段渲染,不是手绘。
官方 Agent Teams 给你 roster、任务板和 mailbox;本插件让这套东西自己转起来:任务 ready 且无主时,由一个后台 tick 唤醒空闲成员;持有者停摆时把任务收回池子;并把 advisory 的 writeScopes 重叠警告升级为派发时刻的有效软锁。
它不建第二个团队层——没有自己的任务存储、成员注册表或消息通道,卸载即失效、不留残留状态。
决策由代码做出,不是由模型做出:不向主 agent 注入策略文本,不消耗 token 做调度判断,也不依赖模型自觉遵守任何约定。
为什么需要它
原生 Agent Teams 的一个明确空档,写在它自己的模型策略里:
Task readiness never starts an owner.
wait_agentobserves only changes after that call starts, never wakes a member.
The owner is never released automatically — not for inactivity, interruption, process exit, or failed work.
Write-scope overlap is advisory, not a lock.
也就是说:任务变成可执行之后,没有人会被自动叫醒,得靠 Lead 手动发消息推动;成员停摆后它认领的任务永远挂在 in_progress,占着写域和并发槽,谁也接不了;而写域冲突只是提示,不会拦截。
这个插件补的正是这三件事。
和别的团队插件有什么不一样
dsh 生态里做多智能体协作的插件有十几款,但真正的分水岭不是「有没有这个功能」,而是决策由谁做出。
| 模型驱动 | 确定性调度 | |
|---|---|---|
| 做法 | 把派发规则写成策略文本注入 systemPrompt,由主 agent 每步读取并自觉调工具 |
后台 tick 扫描任务板,由代码判定并唤醒 |
| 决策成本 | 每步都要读策略文本,决策本身在烧 token | 零 token |
| 失效模式 | 模型不遵守即完全失效 | 规则既定即执行 |
| 代表 | dsh-eteams、dsh-plugin-teamflow、dsh-agent-hub 等 |
本插件(原生 seam)、@nanmicoder/dsh-agent-teams(自建状态) |
另一个维度是团队状态存在哪。上面那些模型驱动插件几乎都是自建派——自带 SQLite 或文件存储、自己的任务板与成员表,与官方 Teams 的状态互不认。原生派(状态直接来自 ctx.agentTeams)在第三方里目前只有本插件。选错派等于白装:你已经在用官方 Teams,装一个自建派插件只会得到第二套互不相通的任务板。
三条硬差异(均来自解包核验,不是措辞游戏):
- 写域冲突在派发时刻拦截,不是干完再审计——官方只给 advisory 提示,
@nanmicoder/dsh-agent-teams自述是 completion-time audit。 - 不接管团队状态——不写自定义 projection、不新增 SessionEvent、不注册第二个任务板。
- headless 可用——竞品的可视化面板都依赖 web profile;本插件在 CLI / headless 下行为完全一致,可观测性走纯文本工具
team_autopilot_status。
另外,任务依赖 DAG 不用自己做:官方 TeamTaskView 原生带 blockedBy: TeamTaskId[] 与派生的 ready 标记,task-graph 已做环检测、缺失与自引用校验,claim 时未就绪会抛 TEAM_TASK_BLOCKED。本插件的 claimableTasks 判定直接用 ready,等于白拿官方的 DAG——自建派插件(包括 @nanmicoder/dsh-agent-teams)的 DAG 是第二份状态,这里不是。
能不能一起装
先分清两种关系:官方 Agent Teams 是地基(没有它本插件根本不加载,这不是叠加而是依赖),其他团队插件才是叠加对象。
| 一起装的对象 | 结论 | 原因 |
|---|---|---|
官方 experimental-agent-team |
必须装(是依赖) | 本插件只读任务板,写操作只有两个:唤醒(sendMessage)与回收(reassign),用的都是官方自己的 action 和 Lead 身份 |
模型驱动派插件(把规则写进 systemPrompt) |
可以叠加,且互补 | 它只注入策略文本,不持有状态、不注册调度器;本插件注入 0 段 prompt |
@nanmicoder/dsh-agent-teams |
不要同时装 | 两个确定性调度器并行,且回收语义相反 |
与官方:争用是可恢复的
回收带 expectedRevision 做 compare-and-set。如果人类 Lead 或主 agent 在同一时刻改了同一个任务,我们这一侧会失败——此时只记录 lastError、不触发熔断,下一轮重读任务板再判。所以最坏情况是「回收晚一轮生效」,不会写坏状态,也不会连累同一轮还能正常派发的任务。
唯一仍未实测的是 wait_agent:从官方描述看它只观察不唤醒,而我们唤醒产生的 activity 变化正是它要等的东西,理论上互补。但「理论上」不等于验证过,见「仍未验证」。
与模型驱动:时钟互补,不是竞争
模型驱动派的机制是把派发规则写成文本塞进 systemPrompt,靠主 agent 每步读取后自觉调工具。它不写团队状态,所以和我们的两个写操作(唤醒、回收)没有交集。
真正的价值是时钟不同源:它的检查节奏绑在主 agent 的 step loop 上(主 agent idle、等用户、被 interrupt 时都不检查),而官方那条限制 Task readiness never starts an owner 描述的恰恰是没有活跃主 agent 的时刻。两者覆盖的是不同时间段,可以都装。
如果一起装,建议把 wakeCooldownMs 调大(默认 60s)。它按「任务 × 成员」去重,能减少主 agent 自己派活时与 tick 的重复唤醒。
引用变化(2026-10-28 复核):这一节原先用一个具体包做样本,逐字段核对过它的
inject、注册的工具名与 channels 默认值。该包已从 registry 下架(npm view返回 404),那些细节因此无法复现,只保留「这一类做法与本插件互补」的结论。要判断某个模型驱动插件能否共存,看它写哪套状态即可:只注入 prompt、不碰任务板 → 可叠加;经自建层改状态(例如@nanmicoder/dsh-agent-teams)→ 互斥。
结论:在官方 Agent Teams 上,"任务就绪后有人接"这件事只有本插件能做。 模型驱动插件在此环境里能发挥的是把低风险机械活外包给 helper(workflow / subagent 通道),与团队任务板无关。两者的痛点不同,可以叠加而非二选一。
与 nanmicoder:是替代关系,不是叠加
它同样有真调度器。加了回收之后冲突更具体:同一个僵死任务,我们回池(reassign 不带 owner → 无主 pending),它换人(reassign_task 指定新 owner)。两套状态源互不认(它读自建存储,我们读原生 ctx.agentTeams),谁也看不见对方已经动过手。
附带一个认知负担:它会注册 14 个 agent_teams_* 工具,官方另有 9 个团队工具,23 个名字相近的工具摆在同一只模型面前,调错概率不低。
安装顺序
模型驱动插件的安装脚本会备份并覆写 profiles/<profile>/package.json 里的 dsh.profile.bundles,而挂载本插件也是改同一个字段。手工编辑时后一次会覆盖前一次——用 dsh plugin add 由管理器合并才安全。
安装
npm i dsh-team-autopilot
或交给 dsh 插件管理器(CLI 版 dsh):
dsh plugin --profile web add dsh-team-autopilot
已发布版本自带预构建的 dist/,安装后无需再跑构建。
@deepseek-ai/* 全部声明为 optional peer,由宿主 profile 提供;在宿主之外单独 import 本包会在运行时抛 Cannot find package '@deepseek-ai/schemastery'——这是预期行为。
前置条件
必须先有一个提供 ctx.agentTeams 的组合:
dsh plugin --profile web add @deepseek-ai/dsh-experimental-agent-team-profile
然后把本插件叠在它之后:
dsh plugin --profile web add dsh-team-autopilot
cordis.patch.yml 会插入 team-autopilot 一行。若 agentTeams 不存在,插件因 inject 无法解析而不会加载——这是预期行为,不是 bug。
配置
| 键 | 默认 | 说明 |
|---|---|---|
enabled |
true |
关掉后只保留状态工具,不跑循环 |
tickTimeoutMs |
30000 |
每次等待窗口,原生硬限制 10000–3600000 |
maxConcurrent |
2 |
团队并发预算默认值(见下) |
wakeCooldownMs |
60000 |
同一任务在该窗口内不重复唤醒 |
dryRun |
false |
只记录决策,不发消息 |
teamBudgets |
{} |
按团队覆盖并发预算,key 为团队 TeamId(root Session 标识) |
errorThreshold |
3 |
连续 sendMessage 失败几次后切开熔断 |
openCooldownMs |
60000 |
熔断打开后保持多久再半开探针 |
halfOpenProbe |
1 |
半开阶段允许的探针派发次数 |
reclaimAfterMs |
300000 |
持有者 inactive 持续多久后把任务收回池子(1000–3600000) |
reclaimOnFailed |
true |
持有者 failed 时是否立即回收 |
statusFile |
'' |
状态有变化时追加一行到该文件(绝对路径),空 = 关闭。见下「零 token 观测」 |
statusHeartbeatMs |
600000 |
状态未变也至少这么久写一行;0 = 逐轮写 |
设计决策(都来自源码核验)
1. 只唤醒,不代认领。updateTask 的 claim 动作留给成员自己走 list → get → claim 流程。调度器代认领会和成员争抢所有权,而 CAS 冲突只会让成员白跑一轮。代价是多一次往返,换来的是所有权语义干净。唤醒消息把任务 title 当数据处理(折叠空白、按码点截断、中和反引号),避免任务标题被当成跨 agent 的指令注入。
2. 先挂 waiter,再读状态。waitForChange 内部只是一个 Map<TeamId, Set<Waiter>>,没有任何历史缓冲——注册之前发生的边沿永久丢失。所以顺序必须是「先 waitForChange,后全量 listTasks」,否则会漏掉窗口期内的变化。
3. 每轮重新解析 Lead(多团队各派各的)。waitForChange / listTasks / sendMessage 都要求一个 live Agent 当凭证。Lead 实例在会话重组后会被替换,缓存引用会失效。所以每轮都走 ctx.agents.roots() + tryMembership() 重新找——而且遍历所有 Lead,不是取第一个。桌面宿主会同时开着多个会话,每个会话就是一个独立 Team;若只取第一个 Lead,调度器会永远绑定最早注册的那个团队、静默忽略其余。现在主循环为每个 Lead 各跑一轮 tick,lastWake(冷却去重)和 breaker(熔断)都按 TeamId 拆分,团队之间互不干扰。
4. inactive 才是可唤醒状态。
成员只有 4 态:running / inactive / provisioning / failed。没有 idle。inactive 表示当前没有回合在执行,sendMessage 会启动或恢复它。running 在干活、provisioning 还没起来、failed 已废。
5. 写域判定与原生一致,但多一层防御。
用 left === right || left.startsWith(right + '/') || right.startsWith(left + '/') 的 / 分段规则(所以 src/a 不会误判与 src/ab 冲突)。另外 claimableTasks 除了看派生的 ready 标志,还强制要求 status === 'pending'——不盲目信任别的组件产出的派生值。真机注意:无主任务在运行时 ownerName 是 null(不是 undefined),所有 owner 判定统一用 == null,否则会把无主任务误判为"有主"而全部跳过。归一化还会折叠 ./.. 段,并在 win32 上折叠大小写(Windows 文件系统大小写不敏感,src/Auth 与 src/auth 视为同一目标)。
6. 同轮去重 + 冷却窗口。
一轮内多个任务可能写域重叠,先分配的会占住作用域;跨轮则用 wakeCooldownMs 抑制重复唤醒——因为发消息本身会触发 activity 通知,不设冷却会反复叫同一个还没 claim 的成员。
7. 团队级并发预算 + 错误率熔断。maxConcurrent 改成「默认预算」,新增 teamBudgets 按团队覆盖——teamKey 取 ctx.agentTeams.tryMembership(lead).id(即 TeamId,绑定 root Session;不用 Lead 显示名,因为名字可改、TeamId 稳定)。另外 breaker.ts 是一台独立纯状态机:连续 errorThreshold 次 sendMessage 失败后切开电路(breaker=open),暂停唤醒 openCooldownMs,随后进入 halfOpen 用 halfOpenProbe 次探针试探——全成功则闭合、任一失败立即重开。breaker / breakerTrips / breakerBlocked 进 team_autopilot_status 可观测。
8. 主循环与 Cordis 接线分离。
单轮 tick 与主循环 loop 放在 src/dispatch.ts,只依赖类型与零依赖纯模块(select.ts / lead.ts / breaker.ts),不 import dsh-tools;src/index.ts 只保留 Config 校验、team_autopilot_status 工具与 apply 接线。这样联调 harness 能直接驱动真实 tick,无需拉起整个宿主依赖树。
9. 僵死任务回收:回池,不换人。
官方明说「不会自动释放 owner」——成员 inactive、interrupt、进程退出、工作失败都不会释放,任务就永远挂在 in_progress,占着写域和并发槽,别人不能认领。回收走 reassign 动作且不指定 owner:它把任务清回 pending 且无主,正好落回 claimableTasks 的判定,下一轮由调度器重新挑人,且会再过一遍写域软锁和并发预算。选 reassign 而非 release 有两个原因:release 只认 in_progress,覆盖不了「已认领但未开工」的 pending;而 reassign 是 Lead-only,语义上就是 Lead 在重新分配。三种僵死按确定性递减处理:owner 已不在 roster(立即回收)、owner failed(立即,由 reclaimOnFailed 控制)、owner inactive 超过 reclaimAfterMs(给足启动宽限期,避免误伤刚被唤醒还在拉起的成员)。Lead 自己持有的任务一律不动。
回收发生在派发之前,释放的槽位同一轮即可再用。同一轮内,刚被回收的任务不会派回刚被剥夺的那个成员——否则会形成「僵死 → 回收 → 还给他 → 再僵死」的循环。
构建
npm run build # tsdown → dist/index.mjs + dist/index.d.mts
main / types / exports 均指向 dist/,dsh.bundle.patch 指向 cordis.patch.yml。从 registry 安装时 prepack 已保证 dist/ 是新鲜的;只有以本地路径 / git 方式挂载才需要手动 npm run build(dist/ 被 .gitignore 忽略,但 files 白名单会把它带进发布包)。
发布
npm run verify:pack     # 打包内容断言(不落盘)
npm publish --dry-run   # 走一遍 prepublishOnly + prepack,看清最终清单
npm publish             # prepack 自动重建 dist;prepublishOnly 跑类型检查与两套测试
dist/被.gitignore忽略,但prepack会在打包前强制重建,所以从干净检出发布也安全。- 版本号手动改
package.json(本项目不使用 changesets),并同步在CHANGELOG.md顶部加新版本段。请用npm publish,不要用pnpm publish。 - 发布后自检:
npm view dsh-team-autopilot dist.tarball,或npm pack dsh-team-autopilot && tar -tzf dsh-team-autopilot-*.tgz。
已验证
node node_modules/typescript/bin/tsc --noEmit   # → 零错误
node tests/verify.ts                            # → OK — 45 checks passed
node tests/integration.ts                       # → OK — 24 integration checks passed
node scripts/acceptance.mjs                     # → OK — 28 acceptance checks passed
node scripts/verify-status.mjs                  # → PASS(用真实 dsh-tools 编译器校验输出 schema)
node scripts/verify-pack.mjs                    # → 7 required files, 0 forbidden, 0 dangling
npm test=verify+integration+acceptance+verify:status四套聚合;npm run acceptance单独跑端到端验收。
verify:status是唯一用真实dsh-toolsschema 编译器校验team_autopilot_status输出的脚本——输出 schema 若被宿主拒绝,工具会在安装后静默失效(不报错、不派发),只有这一项能提前拦住。它同时覆盖冷启动(无团队)与热状态(带lastReclaim/lastDispatch嵌套对象,冷启动永远不会走到)两种形态。已接进prepublishOnly,发布前必跑。
- 类型对账通过:代码按 rc.3 源码结构编写,类型来自 npm 上的
0.2.1-rc.2,两者完全兼容,无 API 偏差。 - 零依赖自检:
tests/verify.ts的 45 项断言覆盖纯函数核心(选任务、选成员、写域冲突、并发预算、同轮去重、熔断状态机)与输出格式(日志行、状态签名、启动标记)。select.ts/breaker.ts/observe.ts只有import type或无外部依赖,所以这个脚本不需要任何node_modules也能跑。 - 进程内联调:
tests/integration.ts用可控宿主桩驱动真实tick()与loop(),24 项断言覆盖唤醒空闲成员、写域冲突拦截、连续失败触发熔断、TeamId级预算覆盖,以及三条容易「看起来对但其实没生效」的时序/写入规则——每团队每 interval 只 tick 一次、唤醒判定不早于冷却到期、只有累计计数变化的轮次不写日志。dispatch.ts不 importdsh-tools,所以同样零node_modules可跑。
开发环境注意事项
1. node-linker 必须是 hoisted
package.json 里声明了 "pnpm": { "nodeLinker": "hoisted" }。在当前的 Windows 环境上,pnpm 默认的 isolated 模式会创建 junction,而这一步静默失败——node_modules/@deepseek-ai/ 会变成空目录,tsc 报 Cannot find module。hoisted 模式直接写真实目录,绕开该问题。
2. pnpm install 可能需要在沙箱外执行
若 pnpm install 报成功但 node_modules 里没有条目,说明写入被沙箱拦截(pnpm 不报错)。换到非沙箱环境重装一次即可。
3. 不要用 pnpm run typecheck
pnpm run 会先触发一次自动 install,在上述环境下可能把 node_modules 又破坏掉。直接调用:
node node_modules/typescript/bin/tsc --noEmit
真实宿主联调
真机端到端需要真实 dsh 宿主 + 可用的 LLM provider(dsh web 要起真实会话),无法在无头环境跑。进程内已用真实 tick() 覆盖调度判定(见上),剩下的是「在真实宿主里观察」。
桌面版注意:
~/.dsh桌面 App(如0.2.1-rc.3)没有dshCLI,由 App 驱动,且已内置@deepseek-ai/dsh-experimental-agent-team-profile(团队前置条件天然满足)。挂载方式是把本包加进~/.dsh/profiles/desktop/package.json的dependencies与dsh.profile.bundles,在 profile 内pnpm install(pnpm 由 runtime 自带、不在 PATH),再重启 App。下面的 CLI 命令仅适用于 CLI 版 dsh。
桌面 profile 上有三个坑,都是实测撞过的:
- 用 runtime 自带的 pnpm,不要
corepack pnpm(下的是另一个大版本,可能重写锁文件):node ~/.dsh/dsh-runtimes/dsh-primary-runtime/dependencies/pnpm/bin/pnpm.cjs install。 - 新版本会被
minimumReleaseAge拦住:profile 启用了供应链策略,刚发布的版本落在 24 小时冷却窗口内。正确做法是在profiles/desktop/pnpm-workspace.yaml的minimumReleaseAgeExclude里加一行dsh-team-autopilot@<版本>(版本级豁免,不动全局策略),而不是--config.minimumReleaseAge=0。 - 换过包名后锁文件必须重解析:
package.json改了依赖名、锁文件没跟着变时,旧条目(例如已下架的旧包)会让 pnpm 在解析之前就整体拒装,报错点名的是旧包而不是新版本——等满冷却期也不会好。修法是删掉锁文件里旧包名对应的 importer /packages:/snapshots:三段,再pnpm install;不要用pnpm clean --lockfile重建(会把所有依赖的 caret 范围重新解析)。
# 1) 装宿主与团队 profile(版本对齐 0.2.1-rc.2)
npm i -g @deepseek-ai/dsh@0.2.1-rc.2
dsh plugin --profile web add @deepseek-ai/dsh-experimental-agent-team-profile

# 2) 叠上本插件(cordis.patch.yml 会自动插入 team-autopilot 一行)
dsh plugin --profile web add dsh-team-autopilot
# 未发布时改用本地 tarball:dsh plugin --profile web add ./dsh-team-autopilot-<版本>.tgz

# 3) 先开 dryRun 观察判定(把 patch 里 config.dryRun 设为 true),再起宿主
dsh web
逐场景验证(含失败排查表、dryRun 各场景、熔断、真实派发)见 docs/verify-host.md;僵死回收专项见 docs/verify-reclaim.md(含三个触发条件的可制造性、时序预期、负向场景);可直接粘贴进 Harness 的提示词见 docs/prompts-reclaim.md。挂载自检:node scripts/verify-mount.mjs(npm run verify:mount)。
观察点:
- 一个 ready 且无 owner 的任务 + 一个
inactive成员 → 下一轮team_autopilot_status应看到rounds递增、dispatched递增、breaker=closed。 - 一个写域与在飞任务重叠的 ready 任务 →
skipped增加且scope那一项跟着涨,且不产生唤醒。 - 故意让
sendMessage失败 → 连续errorThreshold次后breaker=open、trips≥1;冷却期内held递增(team_autopilot_status里叫breakerBlocked)且不再派发。注意别和任务桶的blocked(卡依赖)混了,两个词含义无关。 - 关掉
dryRun后,确认成员端实际 claim 时序,以及和官方wait_agent是否互相干扰。
真机验证记录
在 DeepSeek Harness 桌面版 0.2.1-rc.3 上(dryRun: true)实测:
- 写域冲突拦截:被跳过的任务计入
skipped(现在是scope/noMember/declined三项,当时只有lastBlocked=1)——task-2 被 in_progress 的 task-1 挡住 - 正路径派发:
dispatched=1(task-3 派给 idle 成员) - 冷却去重:
suppressed=2 - 诊断:
team=session-… tasks=3 inFlight=1 claimable=2 idle=1 slots=1 - 熔断保持
closed(dryRun 不发消息,符合预期)
真机还揪出并修复了一个单测没覆盖的 bug:无主任务的 ownerName 是 null 而非 undefined(详见设计决策 #5)。
真机第二个体检项:wakeMessage 曾误用不存在的 team_task_claim 工具,已改为真实的 team_task_update(action: "claim", expected_revision)。
dryRun: false 下实测:真实 sendMessage 成功唤醒成员,task-3 被队友认领并 completed(ownerId 为队友 session),确认 sendMessage → claim → complete 闭环;修正后的 team_task_update 文本已生效。
僵死回收(2026-10-28 真机实证)
桌面 profile,reclaimAfterMs: 60000,两轮验证:
第一轮(dryRun: true,只验判定)
reclaimed0 → 1,而 task-2 的status/owner/revision三项纹丝不动- 同时
dispatched=1、suppressed=2,但没有任何成员被真唤醒
即:判定发生、副作用为零。这与代码语义一致——dryRun 下 reclaim 与 dispatch 都是「计数后 continue」。
第二轮(dryRun: false,验副作用)
- task-3:
in_progress/ ownerworker-a/ rev 2 →pending/ owner 清空 / rev 3 reclaimed1 → 2,claimable=1,inFlight=0- 全程
worker-b处于冻结态(已指令其不看板、不认领),且它明确拒绝了自动派发
这条是铁证:owner 被清空为「无主」而不是转给某个成员——成员自主抢任务时 owner 只会变成它自己,绝不会经过无主态。所以这次状态迁移只能来自插件的 updateTask(action: 'reassign', expectedRevision)。revision 递增则证明 compare-and-set 真实落库,而非只改了本地视图。
结论:僵死回收在真实宿主上生效,语义为「回池」而非「换人」,与 @nanmicoder/dsh-agent-teams 的 reassign_task(指定新 owner)方向相反。
真机顺带发现的两条行为
- 成员 spawn 后立刻跑一个回合,并会主动扫任务板认领 ready 任务——成员侧天然存在模型驱动派发。但它只在 spawn 首回合(或被唤醒时)发生;新建任务本身不会触发任何成员,与官方「Task readiness never starts an owner」一致。造僵死场景时必须先把多余成员冻结,否则任务会被吃掉。
- 回池后若无人认领,autopilot 会周期性重复唤醒:本轮观测到
dispatched 1→3、suppressed 0→5。wakeCooldownMs按「任务 × 成员」去重,所以每个成员每窗口最多一次——不算刷屏,但任务长期滞留在池中时会持续产生唤醒消息。
仍未验证
- 真实宿主上熔断与
sendMessage错误形态的对应关系(真实失败较难人为制造) - 与官方
wait_agent工具共存是否互相干扰 - 僵死回收的两个触发条件未实证:owner 离开 roster(官方 9 个工具没有移除成员的入口,只能靠进程退出或冷恢复失败,难人为制造)与 owner
failed(中等难造)。已实证的是inactive超时这一条 - 负向场景「
running/provisioning持有者不被回收」未在真机跑过(进程内断言全绿) - 与
@nanmicoder/dsh-agent-teams双调度器并行的实际后果(上面「不要同时装」是源码层推断,未在真机上跑过双装场景)
可观测性:status 字段怎么读
team_autopilot_status 是 headless 下唯一的观测手段(竞品一个都没有,它们的看板全绑 web profile),所以字段设计按「能不能据此定位问题」取舍,而不是按「好不好看」。
autopilot active
totals rounds=N dispatched=N suppressed=N skipped=N unclaimed=N reclaimed=N
caller team=<id> tasks=N inFlight=N claimable=N blocked=N done=N idle=N slots=N (live)
teams=N
  team=<id> ticks=N dispatched=N suppressed=N skipped=N (scope=N noMember=N declined=N) why=<a,b|-> breaker=<state> trips=N held=N reclaimed=N unclaimed=N pending=N tasks=N inFlight=N claimable=N blocked=N done=N idle=N slots=N (<age>)
    lastReclaim task=<id> from=<member> reason='<cause>' applied|dry-run (<age>)
    lastDispatch task=<id> to=<member> wakes=N sent|dry-run outcome=claimed|unclaimed|unchecked (<age>)
团队行是一整行(上面为排版折过行,实际输出不分行):skipped 后面的括号和 breaker= 都在同一行里,grep 'breaker=open' 才拿得到。
四类字段,各回答一类问题(同一类里可能有多个键):
| 字段 | 回答什么 | 为什么必须有 |
|---|---|---|
skipped (scope=N noMember=N declined=N) |
任务为什么没派出去 | 三种原因三种处置:写域冲突要放宽写域、没有空闲成员要加人、全员拒绝要看成员为什么不接。只有一个 skipped 总数时,读者得回头翻日志才能分辨 |
lastReclaim(task / from / reason / 时刻) |
刚刚收回的是哪个任务、从谁手里、为什么 | 只有 reclaimed=2 时,判断「是不是同一个任务在循环」只能靠任务的 revision 数字往上爬来反推 |
lastDispatch(task / to / wakes / outcome / 时刻) |
派给谁了、叫了几次、有没有人接 | dispatched=3 看不出是 3 个任务各一次,还是 1 个任务叫了 3 次 |
unclaimed |
有多少次唤醒石沉大海 | 反复不接活的成员会一直占住派发通道,而这是插件当前唯一能让它显形的数字 |
pending(当前待判) |
现在有几条唤醒已发出、还没到判定时刻 | lastDispatch 只能记住一条;一轮唤醒两个任务时,第二个在 outcome 上完全看不见 |
why(scope / noMember / declined,本轮,无跳过时 -) |
这一轮为什么跳过 | 前面括号里那三个是累计值,任务一直没人接就每轮都涨,回答不了「此刻为什么不动」。why 是这一轮的答案,只在原因变化时才变,所以既安静又即时——「全员拒接、插件停手」不用等心跳。日志行与 status 用同一个词,status 里是数组(["declined","scope"],空数组即 -) |
outcome 的判定发生在唤醒过了冷却窗口之后,不是下一次读板就判:唤醒发出去的瞬间,成功与「没人接」在观测上完全相同,而成员读消息、调 team_task_update 需要时间。真机上变化驱动的轮次可能只隔 1 秒,那时判就等于在判成员的思考时间——曾因此把每一次唤醒都算成未认领、把正在认领的成员记进拒绝集合、把任务改派给同事造成重复劳动。冷却窗口是判定最早的合理时刻:任务在此之前本来也不允许改派给别人。
同一任务同一成员再次被唤醒时不另开记录,而是累加 wakes 并保留上一次的判定。unclaimed 每次唤醒只计一次,不按轮累加(任务滞留期间会有很多轮);一轮唤醒了多个任务时,每一个都会各自被判定,不会只判最后一个。
unclaimed >= 2 时报告会多打一行 warning,直接点出「有成员从不接活」。
outcome=unclaimed 会改变下一轮的决策
它不只是个数字。任务派给某成员后未被认领,该成员就被记进这个任务的拒绝集合,下一轮改派下一个空闲成员——否则那个成员按 roster 顺序永远排第一,同事全程空转,任务原地不动。
全部空闲成员都拒绝过时,派发主动停手:declined 计数上涨并打一行 note,而不是继续对着同一批成员重复唤醒烧 token。这是刻意的取舍——循环每轮都发消息且掩盖问题,停手不花钱且一眼看得见。
任务一旦易手(被认领、完成、或回收回池),该任务的拒绝记录立即清空,避免把一次「当时正忙」记成永久黑名单。
零 token 观测:statusFile
status 工具每次调用都要一整轮对话,报告还会一直留在上下文里。而插件状态活在宿主进程内存中,外部进程读不到——想不烧 token 地看,只有让插件自己写下来这一条路。
配一个绝对路径即开启:
team-autopilot:
  statusFile: C:/Users/you/.dsh/profiles/desktop/team-autopilot.log
只要这一轮的字段跟前一行不一样就追加一行,在轮次末尾写(记录的是这一轮产生的结果,含刚发出的唤醒),并在每次进程启动时先写一行启动标记。累计跳过计数(skip / scope / noMember / declined)不参与比较——它们每轮都在涨,算作变化就等于逐轮写;本轮的原因 why 参与比较,所以「开始被写域挡住」「全员拒接后停手」仍会立刻写一行:
2026-10-28T11:33:10.805Z autopilot-start version=0.3.5 tickMs=30000 wakeMs=60000 reclaimMs=60000 heartbeatMs=600000 dryRun=false
2026-10-28T15:52:31.412Z team=session-20f06011-6fdd ticks=12 dispatched=2 suppressed=1 skip=3 scope=0 noMember=0 declined=3 why=declined unclaimed=2 pending=0 reclaimed=0 tasks=4 inFlight=0 claimable=1 blocked=2 done=1 idle=2 slots=2 breaker=closed trips=0 held=0 wake=task-4>worker-a wakes=1 outcome=unclaimed reclaim=task-3<worker-a reclaimed
单行是刻意的:tail -1 是当前状态,tail -30 是最近历史,grep -c 数得出重复次数。多行美化版必须整份读完才有用,那对日志等于永远不会被读。
tail -1 team-autopilot.log                      # 现在什么状态
tail -20 team-autopilot.log | grep 'unclaimed=[1-9]'   # 出现过未认领的轮次
grep -c 'outcome=unclaimed' team-autopilot.log  # 累计多少次唤醒石沉大海
grep 'autopilot-start' team-autopilot.log       # 每次重启:哪个版本、什么配置
任务四个桶是分区,不是四个独立计数:inFlight + claimable + blocked + done == tasks。
| 桶 | 含义 | 派不发的原因 |
|---|---|---|
inFlight |
in_progress,或 pending 但已有 owner |
槽被占着 |
claimable |
pending + ready + 无 owner |
——(该派就派) |
blocked |
pending + 不 ready + 无 owner |
卡在自己的依赖上 |
done |
completed / deleted |
已经完事 |
所以 tasks=4 inFlight=0 claimable=0 这种「看着该派却派不出去」的谜面,配上 blocked=2 done=2 就直接变成答案——不需要再回一轮对话去问。
- 启动标记行:每次进程启动写一行
autopilot-start version=… tickMs=… wakeMs=… reclaimMs=… heartbeatMs=… dryRun=…。没有它,重启后「跑的是不是新版本、配置生效了没」只能靠猜;ticks=1虽然也能当重启标记,但说不出跑的是哪个 build - 没变化的轮次不写。循环每 30 秒每个团队都要 tick 一次,哪怕什么都没发生;逐轮写会让真正值得看的轮次淹在同样的行里——真机两团队实测 2.8 MB/天,一小时内就撞上 128 KB 上限、裁完只剩半小时历史。所以只写变化,另加一行心跳:
statusHeartbeatMs(默认 10 分钟)内没变化才跳过,设0恢复逐轮写。比较时不看累计跳过计数(skip/scope/noMember/declined):任务一直没人接时它们每轮都在涨,算作变化就等于逐轮写——0.3.4之前就是这样,有declined的团队日志会退化回每 tick 一行 - 默认关闭,仓库模板也不开——插件不主动往磁盘写东西
- 写入失败一律静默:观测是便利,满盘或只读 profile 不能卡住派发
- 熔断打开导致这一轮没派发时也会写——那正是最该看日志的时刻,静默等于在最需要的时候失声
- 超过 128 KB 自动裁掉前半,保留尾部;裁剪走「写临时文件 + 原子 rename」,进程在裁剪中途死掉也不会留下半个日志
dryRun下照写,回收记为reclaim-dry-run——要看的是判定,不是副作用- 已知限制:单进程内所有写入都是
await串行的,安全;但如果同一个 profile 同时跑桌面 App 和一个dshCLI 会话,两个进程共写同一文件时,裁剪那一步的读-改-写不是跨进程安全的,理论上会吞掉对方刚追加的行。用一个专属的statusFile路径即可避开
边界
- 不修改原生状态机,不用内部符号,不写自定义 SessionEvent,不写自定义 projection
- 不做独立工作目录:Team 层的
spawn_teammate只接受name/description/prompt/context,不转发cwd。subagent 层的 spawn request 确实有cwd,但走 subagent 就脱离 Team roster,既收不到 Team 消息也碰不到任务板。官方dsh-experimental-worktree已落地,文件隔离等官方即可 - 不做成员自治(原生 Explicit authority:只有 Lead 能 spawn / interrupt)
- 不做 per-member model:底层
dsh-subagent的 spawn request 支持agentOptions.model/provider/reasoningEffort,但 Team 层没转发这个参数。想实现只剩两条脏路——monkey-patchctx.agentTeams.spawnTeammate,或绕开 Team 层自建(产物不是 teammate)。两条都破坏上面第一条边界,且上游隔天一版、碎掉只是时间问题。等官方开口子再做 - 尚未做(都是官方书面声明的空档,但本插件当前未实现):投递确认与团队 token 预算闸。注意现有的
maxConcurrent/teamBudgets是并发预算,不是花钱预算。- 投递确认做不了,不只是「官方不保证重试」:
team/message/queued与team/message/delivered的 schema 仍在(历史可读),但 Team 已不再写入这两种事件(解包核实:包内无任何 append 点)。没有 delivered 事件就无法确认对方收到,剩下的只有「sendMessage抛错后重试」——那是发送重试,不是投递确认。
- 投递确认做不了,不只是「官方不保证重试」:
- 明确不做(判据均为源码层):质量门(验收属语义判断,与确定性定位冲突,且不在派发 tick 职责内)、toolPolicies(按角色限制工具需要拦截层,官方只提供
ctx.approval一次性人工批准,没有暴露策略接口)、per-member model(Team 层spawn_teammate不转发agentOptions)。 - 回收的边界:
avoid与拒绝集合都是任务级,不是成员级冷却——同一个成员仍可能被派到别的任务。若某成员对所有任务都不接,它会在每个任务上各被记录一次,那些任务最终各自停派(declined),要恢复得让任务易手(被认领、完成或回收)。真机上撞到的rev 3 → rev 20循环(同一任务反复派回同一成员、约 8–9 轮)已由此消除
官方会不会把这些做了
官方在这个区域同时推进五个方向——goal-round-driver(单会话轮次驱动)、ralph-bundle(显式循环)、schedule-bundle(定时提醒)、worktree(文件隔离)、experimental-agent-team(团队本体)——但没有一个在做自动派发或僵死回收。已解包核实:experimental-agent-team 里 dispatch / autoAssign 命中 0 个文件,包内的 scheduler 全部指 scheduleRecovery(崩溃恢复)。
更直接的信号是 goal-round-driver 的三句书面声明:
does not spawn a fresh agent, fork a session prefix… that workflow belongs to its own plugin layer
Round cap, not resource budget — token, currency, time, and provider quota policies remain independent
No abnormal auto-retry
也就是说,官方把「跨 agent 编排」「资源预算」「异常自动重试」三项明确划给了插件层。本插件就是那一层。
No comments yet. Be the first to write one.