记忆系统
本地优先的长期记忆,让每次对话都接得上。
JSONL 落盘 · 本机向量检索 · 五个模型工具 · 自动召回 · 硬性规则 · 可视化管理面板


它解决的不是「存一段文本」,而是「让模型在该记的时候记住、该用的时候用上」。 记忆默认只落在本机;没有向量服务也能工作——检索自动退化为词法,不产生任何网络请求。
它解决什么
| 常遇到的问题 | 记忆系统怎么做 |
|---|---|
| 新会话从零开始,换个窗口就问不出上次的结论 | 结论落成记忆;新会话第一步注入摘要,之后每轮按问题召回 |
| 同一个坑反复踩,上次查到的命令又要再查一遍 | 发布 / 部署 / 工具失败等行为会触发定向召回;查到的做法直接复用 |
| 写了规则没人执行,改过的规则旧会话不知道 | kind: rule 进系统提示常驻段;新增或编辑会补一条提醒 |
| 临时状态被当成永久事实 | kind: state 带默认 7 天 TTL 和「使用前验证」前缀;过期后默认隐藏,但不会自动删除 |
| 云端记忆不可控,敏感内容不敢写 | 全部本地 JSONL;写入前过凭据扫描;检索默认不联网 |
它也不是「把聊天记录整段塞给模型」:每条记忆是一句自洽的话,按作用域、类型和重要度管理;
召回有 token 预算与去重;旧结论可以用 supersedes 标注修正,被修正的旧版本默认不再参与
检索 / 摘要 / 召回(历史仍可用 memory_get 和面板查看),而不是悄悄覆盖。
功能
| 能力 | 说明 |
|---|---|
| 五个工具 | memory_save / memory_search / memory_list / memory_get / memory_forget。memory_search 只回印象(8 位 id / 作用域 / 类型 / 标签 / 短摘要),正文和元数据用 memory_get 的 fields 按需取 |
| 四种作用域 | 会话 / 项目 / global / 自定义名。默认写进当前会话,读默认合并会话 + 项目 + global;项目作用域可起别名 |
| 双通道检索 | 词法(IDF + 中文 bigram)+ 向量(本机 llama-server 的 OpenAI 兼容 /v1/embeddings)。向量缺席自动降级,不报错、不阻塞 |
| 自动召回 | 每轮按用户问题召回;新会话第一步注入项目 / global 摘要;发布、部署、工具失败等行为按标签触发定向召回 |
| 印象形态 | 每轮只给每条记忆的短摘要;模型判断相关但需要细节时再 memory_get 取全文,省 token 也不丢信息 |
| 硬性规则 | kind: rule 进系统提示常驻段;旧会话会收到新增 / 编辑提醒;超预算有明确警告,不静默丢弃 |
| 状态记忆 | kind: state 默认 7 天 TTL;注入带「状态,使用前验证」;过期后默认不进检索 / 摘要 / 召回,但 memory_get 与面板仍可取 |
| 流程索引 | kind: procedure 的目录进系统提示:按当前工作区 + 触发词(工具名 / 关键词)列 id · 触发词 → 标题,需要时再用 memory_get 取全文 |
| 可视化管理 | 记录浏览 / 搜索 / 新建 / 编辑 / 删除;记录页可主动做语义检索(与 memory_search 同一套排序);记忆树展示作用域、类型与修正链;设置改完即存;导入导出 |
| 一键向量后端 | 面板里下载 llama.cpp 运行时与内置模型,按 CPU / 内存 / 显卡推荐;换模型自动重建向量 |
| 跨进程安全 | 每个作用域一把写锁,锁内重新读盘再合并;多个 DSH 实例或 MCP server 共用一个 store 不丢数据 |
界面
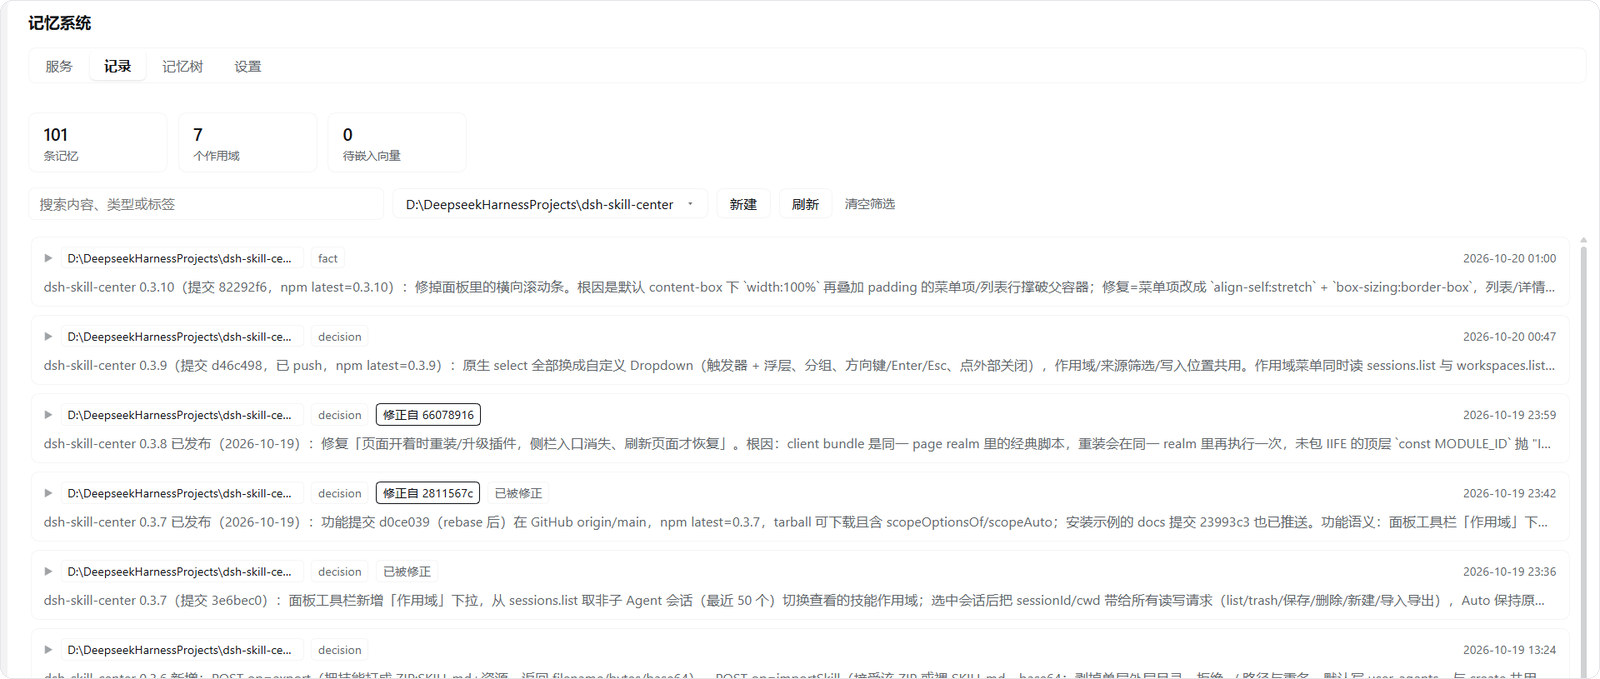
记录页的语义检索
记录页搜索框旁边有「语义检索」开关。开启后,搜索不再按关键词过滤,而是把这句话交给和
memory_search 同一套的召回排序(向量 + 词法,必要时再重排),结果按相关度返回并标出得分。
- 开关只在向量后端已配置时可用;没装后端时保持禁用并说明原因。
- 语义检索是只读浏览:不增加访问计数,不会把
memory_search后续的排序带偏。 - 结果卡上的「得分」是排序分(向量/词法命中 × 重要度 × 时效 × 访问次数),不是概率, 访问次数多时可能大于 1;结果顺序与这个分数一致。
- 结果说明会如实写出这次是「语义排序」还是「关键词回退」:例如记录还没嵌入向量、或向量服务 没有响应时,不会把词法结果冒充成语义结果。嵌入完成后列表会自动刷新成语义结果。
- 作用域下拉与新建 / 编辑 / 删除仍然照常工作;从审计页点记忆 ID 跳过来时会自动回到普通列表并展开该条。
记忆树
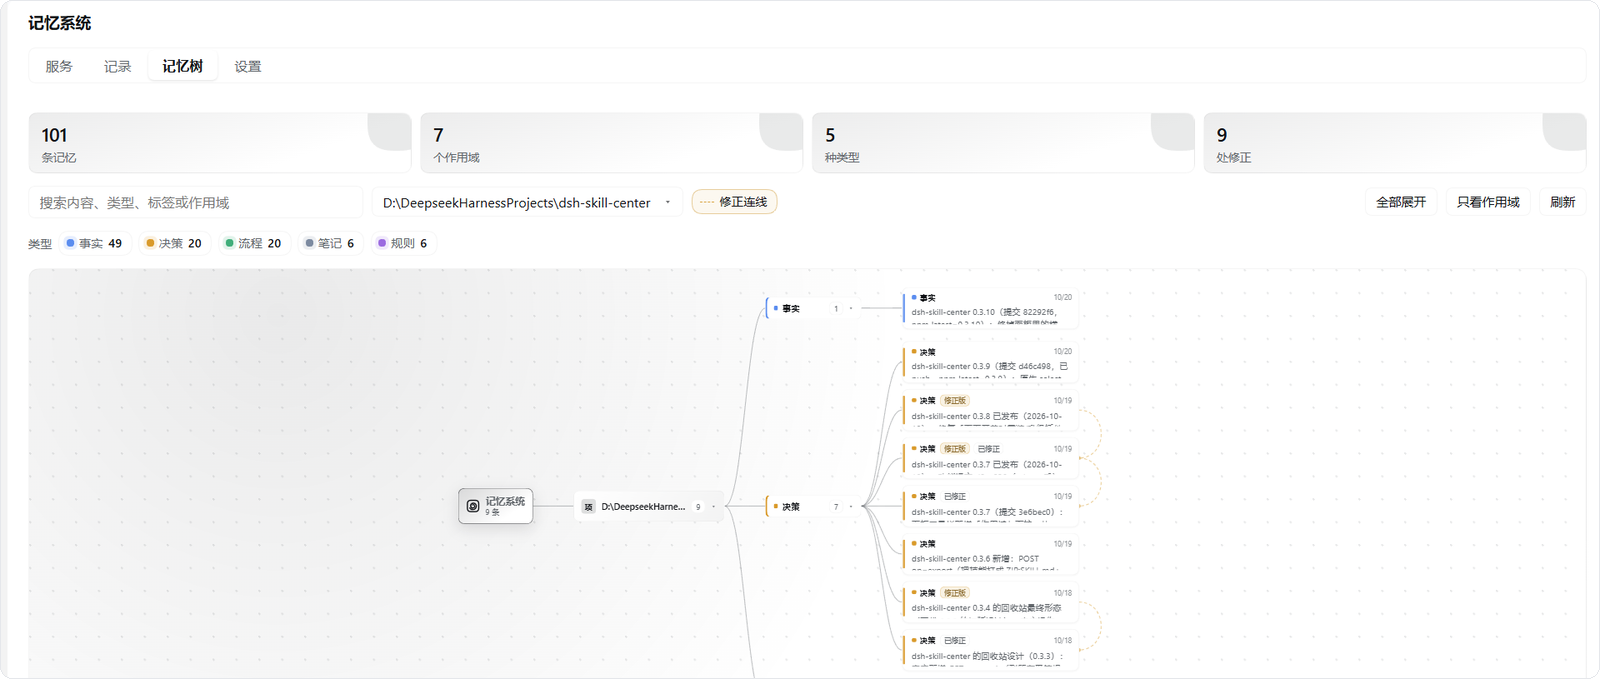
按 作用域 → 类型 → 记录 三层展开,根节点显示总数。supersedes 是关系而不是层级,
所以不改树结构:金色虚线从修正版弯到旧版,悬停或选中任意一端,整条修正链一起点亮。
设置
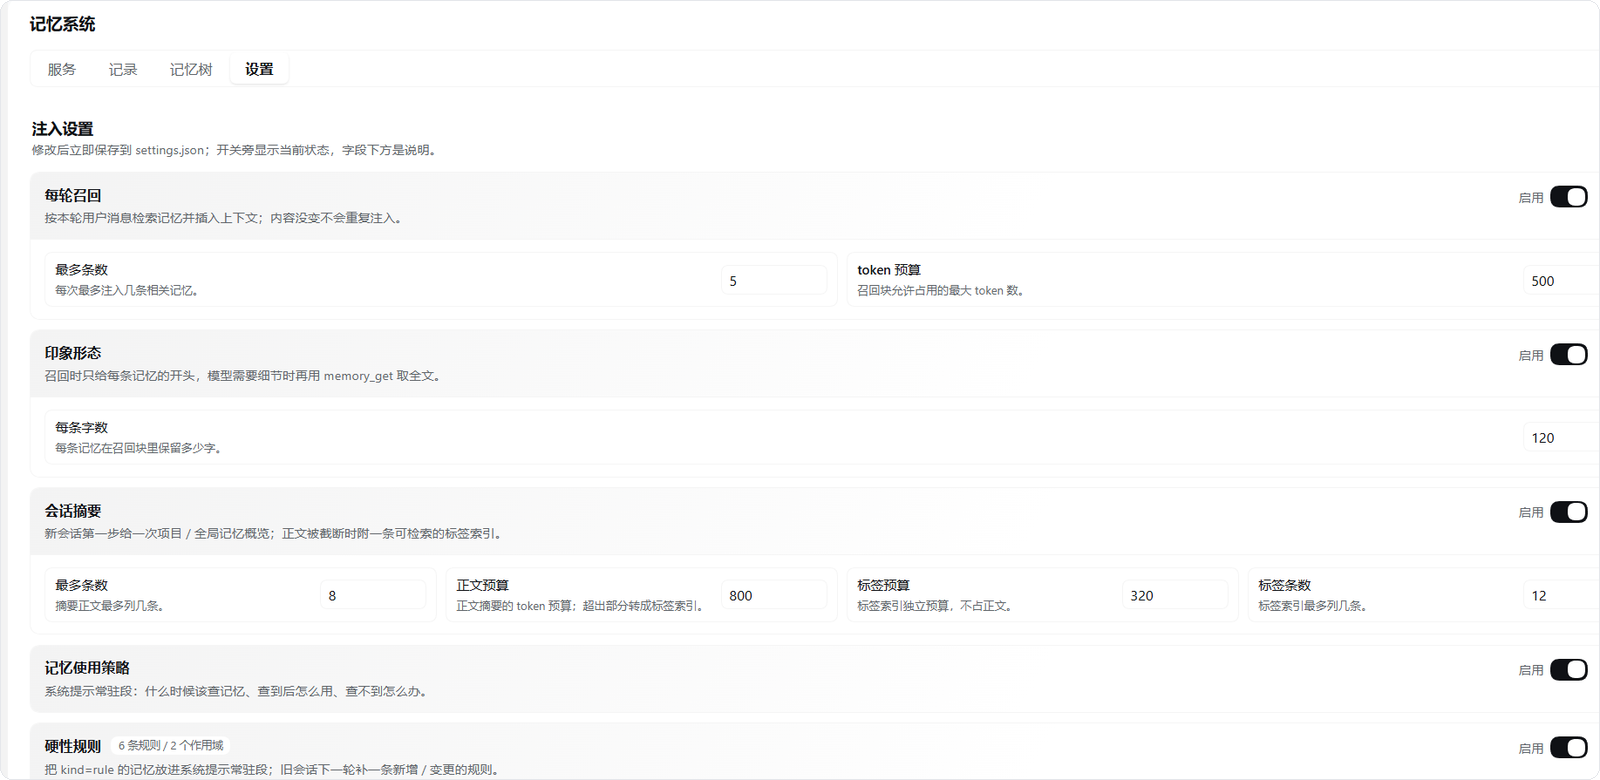
召回、摘要、印象、策略、状态、流程索引、规则、自动召回逐项开关;每个开关都有可见 label、说明和当前状态。
修改立即写入 settings.json,不需要点保存。
向量服务
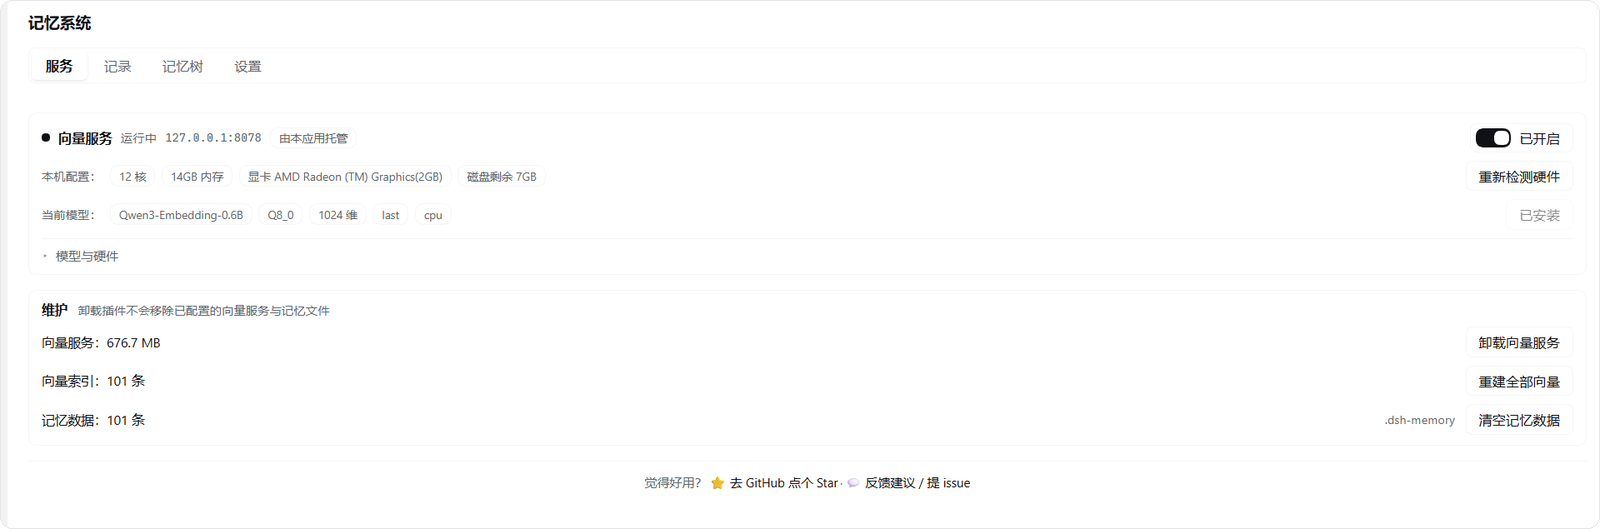
在本机托管 llama-server,下载运行时与模型;内置清单为每个模型配好 dims 与 pooling,
避免维度写错导致向量通道静默失效。按硬件推荐,也支持自定义 GGUF。
安装
一条命令装进 Web profile:
dsh plugin --profile web add @restregular/dsh-memory
也可以手动加进 profile 的依赖(桌面端 ~/.dsh/profiles/desktop,Web 端 ~/.dsh/profiles/web):
pnpm add @restregular/dsh-memory
# 或
npm i @restregular/dsh-memory
装进任意 DSH profile(桌面端 ~/.dsh/profiles/desktop,Web 端 ~/.dsh/profiles/web)。
包自带 cordis.patch.yml,注册唯一一条 entry:
- insert:
    - id: dsh-memory
      name: '@restregular/dsh-memory'
不写任何配置就能用:检索退化为词法,不产生任何网络请求。需要语义检索时, 在面板「服务 → 向量服务」里一键装本机后端即可。
为什么是一个包(给想改结构的人)宿主只允许一个包名、一个解析源,所以本插件是「一个包 + 一条 entry + 面板与服务端同包」。 拆成两个包会触发
resolves from multiple active Loader sources,客户端图组合失败, 桌面端直接起不来。这段设计约束写在下面的折叠块里,不影响使用。
宿主的 dsh-client-modules 只在「某条活的 Loader entry 能解析到包名」时才为该包提供
client bundle,并且 reconcilePackage 要求一个包名只有一个解析源。因此稳定形态只有一种:
一个包名、一条 entry、两侧都在。入口 lib/index.js 组合四个半边,每个半边各自
try/catch——任何一半失败都只记一行日志,绝不让 DSH 启动失败。
| 半边 | 作用 |
|---|---|
lib/provider |
提供 memory 服务:JSONL 存储、双通道检索、向量回填、向量后端生命周期与一键安装 |
lib/tools |
注册五个模型工具 |
lib/inject |
agent/pre-step 召回、摘要、策略、规则与行为触发 |
lib/panel |
/memory/api 管理接口(含同源 / 登录围栏) |
lib/client.js |
设置页「记忆系统」区块与左侧栏入口(注册 id == 包名) |
快速开始
1. 打开面板
设置页 →「记忆系统」;也可以在「设置 → 侧栏入口」打开左侧栏的「记忆系统」按钮。 面板分四个标签:服务 / 记录 / 记忆树 / 设置。记录页的搜索框旁有「语义检索」开关, 开启后可以直接用一句话主动搜索(需要先配置向量后端)。
2. 存一条记忆
模型自己会调,也可以直接对 Agent 说「记住:……」。工具入参如下:
memory_save({
  "content": "本仓库用 pnpm 11 安装依赖;PATH 上的 pnpm 10 会报 ERR_PNPM_UNEXPECTED_STORE。",
  "kind": "procedure",            // fact / decision / preference / procedure / note / rule / state
  "tags": ["pnpm", "toolchain"],
  "triggers": ["pnpm", "install"], // 可选:流程索引按工具名/关键词匹配;缺省用 tags
  "importance": 0.8,              // 0~1
  "expiresAt": 1793836800000,     // 可选:过期时间(ms);kind=state 不传时按默认 TTL(7 天),也可传 ttlMs
  "path": "D:/repositories/dsh-memory" // 可选:写入 project:<该路径>
})
3. 检索、取全文、列出、忘记
memory_search({ "query": "pnpm 装依赖", "topK": 5 })              // 只回 id / 作用域 / 类型 / 标签 / 摘要
memory_search({ "query": "旧的发布流程", "includeSuperseded": true }) // 默认隐藏被修正/覆盖的旧版本
memory_get({ "ids": ["3f2a9c1d"] })                                // 默认:正文 + scope + kind + tags
memory_get({ "ids": ["3f2a9c1d"], "fields": ["summary", "updatedAt"] })
memory_get({ "ids": ["3f2a9c1d"], "fields": ["content"] })         // 只要正文
memory_list({ "limit": 20 })
memory_forget({ "id": "3f2a9c1d" })          // 按内容删:memory_forget({ query, scope })
memory_search 不再返回正文:每条只有 8 位 id、作用域、类型、标签和摘要(默认 160 字,
summaryChars 可调 20~2000)。判断相关后用 memory_get 取正文或元数据:
fields省略 =content + scope + kind + tags(与旧版看到的一致);- 只取摘要:
["summary"];只取正文:["content"]; - 元数据可选
importance/createdAt/updatedAt/expiresAt/triggers/supersedes; id始终返回;未知字段会明确报FIELDS_INVALID,不会静默忽略。
memory_search 省略 scope 时合并会话 + 项目 + global(按来源标注、按 id 去重);
scope: "all" 查所有已发现的作用域,写入路径会明确拒绝 all。
4. 作用域怎么选
| 写法 | 含义 |
|---|---|
省略 / session |
当前会话(子代理共享父会话;拿不到会话信息时回退当前项目) |
project |
当前工作区(键是 project:<cwd>) |
path + 可选 scope |
指定工作区目录;scope 成为这个项目作用域的显示名(别名) |
global |
所有项目共享 |
handbook、项目笔记 … |
自定义作用域,首次 memory_save 自动创建 |
session:<id> / project:<path> |
显式钉住某个会话 / 工作区 |
all / * |
只在读取时可用:跨所有已发现作用域 |
项目作用域的身份永远是 project:<绝对路径>,别名只影响显示与引用,不迁移数据。
同一路径重复用同一个名字是幂等的;换名字会覆盖原别名;另一个路径抢同一个名字会被拒绝
(SCOPE_NAME_TAKEN)。
5. 导入 / 导出
导出是纯文本 JSON:作用域、类型、内容、标签、重要度、时间戳,不含向量。 导入时逐条走保存路径,按当前模型重新嵌入,并按「作用域 + 内容」去重;一次最多 5000 条。
注入链路
| 层 | 触发 | 作用 |
|---|---|---|
recall |
每轮 agent/pre-step |
按本轮用户问题检索,按 topK / token 预算注入;默认只给每条 120 字摘要 + memory_get 指引 |
digest |
会话第一步 | 注入项目 + global 概览:按重要度 × 新鲜度挑选;kind=rule 不进摘要(已常驻系统提示);正文超预算时附可检索的标签索引 |
policy |
系统提示常驻 | 什么时候查记忆、查到怎么复用、查不到时低风险推断 / 高风险先问用户 |
rules |
系统提示常驻 | kind: rule 的硬性规则,限量与预算;mandatory / pinned 排在最前 |
procedures |
系统提示常驻 | kind: procedure 的目录:当前工作区 + 触发词命中的流程,每行 id · 触发词 → 标题;正文按需 memory_get |
turnEnd |
每轮结束(默认关) | 下一轮开头提醒「有可复用结论先落盘」 |
| 行为召回 | 可见文本 / 任务 / 命令 / 工具失败 | 命中标签后,在下一个 agent/pre-step 定向检索;工具失败优先用该工具自己的 description |
行为召回只检索 global + 当前会话 + 当前工作区,不把自定义作用域或 fork 父会话带进来。
匹配源包括可见 assistant 文本、todo、command/run、goal/change、带 description 的 tool/call,以及工具失败描述;没有 description 的工具调用不触发,memory_* 工具一律不触发(memory_search 本身在取记忆,再召回一次只会重复注入)。不读取隐藏思维链。
规则会跟进旧会话
系统提示段每步都会重渲染,但那只是提示词文本变化,不会产生对话消息;常驻段还有 token 预算,
新规则可能被更重要的旧规则挤掉。rules.delta(默认开)会在每轮第一步比较「该会话上一轮开始时
的规则快照」与当前规则:新增、以及编辑过(同一 id 的行变了)的规则都补一条提醒,没变化不重复;
宿主重启用历史里的规则行做种子,不会整批重提醒。关掉它只停提醒,常驻段与检索照旧。
流程索引(procedure)
流程通常很长,全部常驻会挤爆系统提示;而注入发生在 agent/pre-step,模型决定调用工具之前拿不到工具名。
所以系统提示里只放一个目录:当前工作区的 procedure 总是可见;其他作用域的流程必须命中
triggers(缺省用 tags),匹配源是本轮用户消息、本会话最近调用过的工具名和当前项目路径。
每行是 id · 触发词 → 标题,模型判断相关后用 memory_get 取全文。条数与 token 预算可在设置里调;
没有命中项时不注入。
去重与修正
- 召回按 sessionId + 记忆 id / 版本 去重;只给过标签的记录,任务命中后可补正文;内容更新会重新评估。
- 被
supersedes指向的旧记录不再进入memory_search、memory_list、摘要、规则段和自动召回;memory_get(id)与面板仍可查历史。需要历史检索时memory_search({ includeSuperseded: true })。 - 摘要排除
kind=rule;规则段实际进入系统提示的 id 会写进会话注入状态,recall 不再重复注入同一条规则。 - 同一轮最多发生一次 signal 驱动召回;同 tag / 同 query 的第二个信号只记一条
signal_dropped审计。 kind=state过期后默认从检索 / 摘要 / 召回 / 列表隐藏,但数据不删除;memory_get与面板仍可取。- compaction 后重置摘要与注入去重状态。
检索
- 词法通道:IDF 加权 + 中文 bigram;记录标签也并入可检索文本,所以中文正文 + 英文标签也能被标签查询命中。
- 向量通道:调用
llama-server的 OpenAI 兼容/v1/embeddings;可用面板一键安装,也可接自己的端点。 - 可选 LLM 重排:
retrieval.llm.enabled,默认关。 - 自动降级:端点没配、进程没起、向量身份不匹配时,只走词法,不报错、不阻塞。
- 面板主动语义检索:记录页的「语义检索」开关走
GET /memory/api/search,用同一套召回排序 (只读、不写访问计数),并在结果说明里标明向量通道是否真的参与;旧 provider 会退回关键词过滤并在界面注明。
向量边车 .vec 的首行是身份头 #<model>\t<dims>\t<pooling>。任一对不上就整份丢弃并重新嵌入;
重建期间检索暂时只用词法。老边车只有 model + dims 两段,按兼容接受,下一次写向量时自动升级。
换模型 = 向量作废重建,面板会在切换前告诉你涉及多少条记忆。
minScore 默认 0.5 是按 BGE 的 CLS 噪声底定的;换模型后如果召回太少就调低、太杂就调高。
向量后端与硬件
- 内置 8 个模型:BGE-M3(Q4_K_M / Q8_0)、Qwen3-Embedding 0.6B / 4B / 8B、Nomic Embed v1.5、BGE 中文 small / base / large。
- 维度与 pooling 自动配对:每个模型自带
dims与pooling,选它就自动写入。维度写错会让向量通道静默失效,这是最容易踩的坑。 - 按本机推荐:探测 CPU 核数 / 内存 / 磁盘剩余 / 显卡与显存;质量优先,能整块放进显存就用 GPU;CPU 上重罚 4B / 8B;显存 < 4GB 的核显不算可用显卡。
- 运行时风味:
cpu/vulkan/cuda/metal/auto。Vulkan 自包含;CUDA 会一并下载 cudart 伴随包;所选风味找不到时退回 CPU 并在面板说明。 - 自定义 GGUF:填 URL + 维度即可装清单之外的模型;需要前缀的模型(Nomic 的
search_query:/search_document:)自动带上。 - 一次只保留一份:已装运行时 + 模型时不能再装第二个;换模型先去「维护 → 卸载向量服务」,否则「现在跑的是哪个」说不清。
retrieval:
  vector:
    preset: 'qwen3-embedding-0.6b'   # 清单 id
    variant: 'q8_0'                  # 量化档
    flavor: 'auto'                   # auto / cpu / vulkan / cuda / metal
    # customModel: { url: 'https://…/model.gguf', dims: 1024, pooling: 'auto' }
spawn.enabled: true 时,应用启动会后台拉起向量服务、退出时自动关闭;带 PID 文件的遗留实例会被接管,
没有 PID 文件的外部实例不接管。
配置
- id: dsh-memory
  name: '@restregular/dsh-memory'
  config:
    storeDir: '~/.dsh/memory-store'       # 建议绝对路径;默认 .dsh-memory
    scopes:
      global: true
      project: true
      session: true
      custom: { enabled: true, max: 200 } # 只统计自定义作用域
    retrieval:
      topK: 5
      recallN: 30
      vector:
        enabled: true
        endpoint: 'http://127.0.0.1:8078/v1/embeddings'
        model: bge-m3
        dims: 1024
        timeoutMs: 300                     # 交互检索预算,要紧
        writeTimeoutMs: 10000              # 保存时嵌整条记录
        backfillTimeoutMs: 30000
        backfillMaxChars: 8000
        spawn:
          enabled: true
          exe: '/path/to/llama-server.exe'
          model: '/path/to/bge-m3-Q4_K_M.gguf'
          cwd: '/path/to/llamacpp'         # 目录里要有 llama-server-impl.dll
          logFile: '/path/to/llama-server.log'
      llm: { enabled: false }
    limits: { maxRecordsPerScope: 2000, maxRecordChars: 4000 }
    secrets: { enabled: true, mode: refuse }   # refuse | redact
    tools: { defaultScope: session }            # session / project / global
    inject:
      enabled: true                             # 整个注入半边总开关
      extraScopes: ['handbook']                 # 可选:额外参与普通召回的 scope
      recall: { enabled: true, topK: 5, tokenBudget: 500 }
      impression: { enabled: true, chars: 120 }
      digest: { enabled: true, topK: 8, tokenBudget: 800, hintBudget: 160, hintMaxItems: 6 }
      policy: { enabled: true }
      rules: { enabled: true, maxItems: 10, tokenBudget: 300, delta: true }
      turnEnd: { enabled: false }
    panel: { route: '/memory/api' }
面板改过的值写入 <storeDir>/settings.json,优先级高于这里的配置。
注入分层各自独立开关;inject.enabled: false 全关,但工具检索不受影响。
只有写了 endpoint、配了 spawn、或面板里装了本地后端,插件才会碰网络;否则一个请求都不发。
数据与文件布局
| 路径 | 内容 |
|---|---|
<storeDir>/global.jsonl |
global 作用域,一行一条 |
<storeDir>/projects/<sha1(scope)>.jsonl |
其它作用域(会话 / 项目 / 自定义);文件名是 scope 键的 SHA-1,路径分隔符无法穿越 |
<storeDir>/projects/<sha1(scope)>.vec |
向量边车;首行 #<model>\t<dims>\t<pooling>,后面每行 id\t<base64 向量> |
<storeDir>/settings.json |
面板设置(覆盖配置文件里的默认值) |
<storeDir>/scopes.json |
项目作用域别名(显示名 → project:<路径>) |
<storeDir>/*.lock |
跨进程写锁;陈旧锁(持有者已死或 10s 未动)会被接管 |
<installRoot>/llamacpp/ |
llama-server 运行时、依赖 dll、llama-server.log |
<installRoot>/models/ |
下载的 GGUF 模型 |
<installRoot>/selected-model.json |
面板里选过哪一档 |
storeDir 默认 .dsh-memory(相对启动目录),建议显式配一个绝对路径。文件首次写入才创建;
作用域被删空后,它的 .jsonl 与 .vec 会在下一次落盘时一起移除(global.jsonl 例外:只清内容、留文件)。
scope 键有三种形态:global、project:<cwd>、session:<会话 id>,其余是自定义名
(小写折叠、内部空白折成一个空格、最长 64 字符,禁止 :、路径分隔符、控制字符、..
与保留名 global/project/session/all)。没有任何数据迁移:旧的 project:<cwd> 文件继续原样读写。
installRoot 默认 ~/.dsh/memory-vector;显式配了 storeDir 时取它的父目录。
多进程共用
写入按 scope 走锁文件,每次「锁内重新读盘 + 合并本次增量」,不再用内存快照整份覆盖磁盘; 读路径每秒 stat 一次,别的进程刚写的记录不用重启就能看到。实测 4 个进程 × 20 条并发写同一个 scope 零丢失。 已知取舍:同内容去重仍是进程内判断,两个进程同时写完全相同的内容理论上会落两条。
安全
/memory/api的每条路由都先过refuseRequest:宿主connection.requestRejection可用时以它为准 (Host / Origin 围栏 + 浏览器登录),围栏抛错一律 403(失败关闭);旧宿主没有该服务时退化为 「只认 loopback 权威 + 同源」。原因是注册在裸webServer上的路由不在宿主/api围栏之后, 而这里的接口能读、改、删、清空全部记忆。- 记忆内容写入前过凭据扫描(
secrets.mode: refuse | redact),默认拒绝。 - 清空记忆是两步确认 + 接口要求显式
confirm: "delete"。 - 数据默认只在本机:JSONL 不加密,向量端点默认 loopback;请自行保护 store 目录,导出文件也是明文。
诊断与审计
面板顶部有独立的「审计」标签页,不需要手工请求 HTTP。它按事件流展示每次注入的评估、过滤、预算、投递与失败原因,并支持按会话 / 通道 / 结果 / 时间筛选、分页、详情抽屉和导出当前筛选。
审计严格区分三件事:
- 评估(evaluation):候选、选中、省略、预算、检索/加载结果;
- 投递(delivery):最终消息是否通过本地保护并被放进上下文;
- 使用/遵守:Agent 后续是否引用或执行了记忆。当前系统无法可靠证明,面板不会声称已验证。
因此 selected.contentIds 只表示“评估选中”,不等于“已投递”。宿主没有向 middleware 回执最终采纳结果时,delivery.status 记为 unknown(面板显示“已准备(投递未确认)”),不会乐观写成 appended。
API
GET /memory/api/audit
  ?session=<id>&trace=<id>&operation=<id>&memory=<id>
  &channel=digest|recall|rules|rules_delta|policy|nudge|signal|lifecycle
  &trigger=<trigger>&outcome=success|failed|skipped|partial|unknown
  &problem=1&since=<ms|ISO>&until=<ms|ISO>&limit=1..200&cursor=<seq>

GET /memory/api/audit/stats
GET /memory/api/audit/export?format=json|jsonl&<same filters>

GET /memory/api/anchor?session=<id>&turn=<n>&step=<n>&callId=<optional>
响应为 { ok: true, value: { entries, total, nextCursor?, stats, query } }。旧调用 GET /audit?session=<id> 仍兼容;不带 session 时查询全部会话,query.scope 会标记为 all。
和会话轨迹互相跳转
DSH 自带的 Trajectory 面板是一个纯投影:它只声明 conversation.trajectory.images 一个子槽,没有行/列扩展点,选中状态也只存在组件内部。因此插件不能直接往轨迹表格里插审计行。当前采用的是一条不碰轨迹 React 树的组合:
- 轨迹 → 记忆审计:Trajectory 的选中行带有
data-trajectory-row-key。注意它在 DOM 上经过encodeURIComponent(工具行实际是tool%00call%00<callId>),插件会先解码再取 callId。有审计的调用行左侧会显示产品年轮线条图标;选中行右侧另有「记忆 N」徽标,点击按op:<callId>打开审计。两者都会按轨迹滚动容器(扣除 sticky 表头与底部浮动 composer)裁剪,行滚出可视区后被遮住时不会残留。 - 轨迹详情页签:点击轨迹里的任意记录后,右侧详情面板的页签行会多出一个「记忆审计」页签(用
shell.overlay贴着详情面板,不改轨迹的 React 树)。它展示该记录 callId 对应的审计事件,底部按钮直接打开本会话的记忆审计面板;没有 callId 的记录明确提示无法精确过滤。 - 记忆审计 → 轨迹:审计详情里的「在轨迹中定位」把条目上的
operationId(记忆工具调用、触发召回的工具调用)交给 Trajectory 的openView('trajectory', callId);主面板会先打开会话,再切换轨迹并选中该记录,右侧详情面板自动打开。没有operationId的按轮/步事件先请求/anchor,由 Host 从会话事件窗口里找该 turn/step 的第一个tool/call;找不到就只切到轨迹页,不伪造定位。 - 会话内的「记忆」视图:与 Chat / 轨迹同一个 view ring,按当前会话展示审计;它直接使用宿主传给每个 view 的
openView,因此跳转是官方支持路径。它声明data-conversation-composer-overlay让壳层压住外层滚动,审计列表在自己的滚动容器里滚动,外层界面不需要跟着滚。主面板不在 view ring 内,通过conversation.session注册的 per-session store 调同一个 action;拿不到时退化为打开会话/轨迹页。 - 记忆工具调用(
memory_save/search/list/get/forget)本身会额外留一条stage: tool_call的审计锚点:即使自动召回关闭,也能从这条记录精确跳回轨迹里的那次调用。
/anchor 只返回 { callId, tool?, turn?, step?, reason },不返回工具参数、消息正文或记忆内容;找不到会话/工具时 callId 为 null 并给出稳定 reason。
审计数据默认只在内存:容量 2000 条、每会话 200 条,超出时优先保留 digest / rules / delivery / error 等关键通道;stats 暴露 entries / capacity / dropped / writeErrors / persistence。重启后记录丢失,面板会明确提示。
写入前所有自由文本都经过统一 sanitizer:先限制扫描长度(4000 字符),再做凭据模式脱敏,最后截到 200 字;只保存 ID、计数、枚举原因、字符数和短 hash,不保存记忆正文、原始工具参数、异常堆栈。模式脱敏是保守匹配,不承诺覆盖所有秘密形状。
卸载 / 迁移
pnpm remove @restregular/dsh-memory # 再从 profile 的 patch 里删掉那条 entry
卸载插件不会移除已配置的向量服务与记忆文件——它们不在 node_modules 里,而是在
<storeDir> 与 <installRoot>。要清掉,先打开面板「服务 → 维护」:
- 卸载向量服务:删运行时与模型(两步确认,显示释放空间);记忆数据保留。
- 清空记忆数据:删全部 JSONL 与向量边车(两步确认,不可恢复)。
插件被卸掉后面板就打不开了,所以这件事只能在卸载之前做。迁移时直接复制这两个目录即可; 只想带走记忆内容,用「设置 → 数据 → 导出」。
开发
npm test        # node --experimental-strip-types --test source/*/test/*.test.ts
npm run build   # source/ → packages/dsh-memory(含产物契约检查)
npm run verify  # 构建到 .verify/,不落 packages/
构建用 Node 内置类型剥离,相对 .ts 说明符改写为 .js,每个产出文件 node --check。
产物契约检查覆盖会静默失败的几处:patch 恰好一行、exports 放行 ./client 与 locale、
__ModuleLoader__.load({ id }) 等于包名、四个半边的相对 import 都在、icon.svg 体积在宿主上限内。
发布:
node tools/publish-npm-packages.mjs --scope @restregular --version x.y.z。 npm token 不经过命令行,默认从 DevCred 读取,由devcred inject写进临时.npmrc,发布后连目录删除。 npm 的暂存发布会短暂出现版本不可下载、latest未更新;先轮询确认,不要重复发布或 bump 版本。
常见问题
向量服务起不来
看 <installRoot>/llamacpp/llama-server.log。常见原因:端口被占、cwd 里缺 llama-server-impl.dll、
模型与运行时风味不匹配(比如 GPU 风味但没驱动)。
检索很差 / 全是词法命中
先看面板「当前模型」那行的维度是否与模型一致,再看 .vec 身份头。维度或 pooling 写错不会报错,
只会让向量通道悄悄失效。minScore 可能需要按模型微调。
想换模型 先「维护 → 卸载向量服务」再装;换完现有记忆会重新嵌入。
面板里看不到「记忆系统」
包名与 Loader entry 必须一一对应;确认 profile 的 patch 里只有一条 @restregular/dsh-memory,
以及依赖真的装上了。
插件列表里还是包名,没有「记忆系统」
先确认版本 ≥ 0.11.0 且包里有 locale/ 目录;然后重启一次 DSH 桌面端。宿主的 Node 进程会缓存
package.json 的 exports 映射,原地更新不会让这份缓存失效;重启后恢复,之后的版本更新不再需要。
记忆没有自动召回
确认 inject.recall / autoRecall 已开、当前作用域在召回范围内(标签触发的自动召回只含 global + 当前会话 +
当前工作区,普通每轮召回按 inject.extraScopes 配置),并检查标签是否真的命中。打开面板顶部的「审计」标签页,
按会话/通道/问题筛选即可看到触发原因、候选、过滤、省略、预算和投递状态;也可以直接请求
GET /memory/api/audit?session=<id>。
作用域列表里出现两个同名路径 / 用 path 存的记忆工作区里看不到
0.11.0 及以前,D:/repo 与 D:\repo 会被当成两个项目作用域(写的人用正斜杠、会话读的是宿主给的反斜杠)。
0.11.1 起路径写法统一,首次启动会把历史分叉合并到规范键(记录、别名都跟着走,旧文件删除)。
数据怎么备份
复制整个 <storeDir>;或用面板导出 JSON。导入会按当前模型重新嵌入,不携带旧向量。
更新日志
- 0.12.7 —— 审计详情可完整滚到底;ID 浮窗改为按气泡位置固定显示,延迟 hover 显示、可移入浮窗,点击气泡或浮窗都直接跳转。
- 0.12.6 —— 审计详情分类展示选中/新增/标签/省略/去重 ID;记忆与会话 ID 支持 hover 浮窗和点击跳转;详情独立滚动可到底。
- 0.12.5 —— 审计表头移入滚动容器并 sticky,与行严格对齐;重分配列宽,行内预算改紧凑条。
- 0.12.4 —— 审计页默认每 0.5 秒自动刷新(可关/可调间隔);移除顶部标题与气泡,整页固定在窗口内,仅列表滚动;新增表头并优化列宽;复制/导出提示就地显示。
- 0.12.3 —— 审计页筛选改为两行紧凑布局与自绘时间范围/开关;事件列表放入独立滚动容器。
- 0.12.2 —— 修复
CordisMemoryService未转发审计方法,导致审计页显示“provider 未提供注入审计接口”;升级后需重启 DSH。 - 0.12.1 —— 审计 v2 收尾:详情无障碍/唯一 key、JSON 导出、摘要渲染失败记录、部分注入 outcome。
- 0.12.0 —— 注入审计 v2:评估/投递分离、失败与跳过可解释、统一脱敏、有界存储与容量统计、分页筛选 API、独立「审计」标签页与 JSON/JSONL 导出。
- 0.11.1 —— 修复项目作用域因路径写法不同而分叉:
D:/repo与D:\repo统一成同一个键,历史分叉首次启动自动合并。 - 0.11.0 —— 插件显示名改为「记忆系统」,重写 README 并更新截图;无 API / 配置 / 数据格式变更。
- 0.10.1 —— 深色模式开关跟随宿主 token,修复白点融进白轨道。
- 0.10.0 —— 多进程安全写入、向量身份加入 pooling、读路径能看到其它进程的新写入。
完整记录见 CHANGELOG.md。
License
English: Memory System — local-first long-term memory for DeepSeek Harness. One npm package, one loader entry: JSONL storage, local vector recall through llama-server, five model tools, automatic recall, hard rules, and a visual management panel. Memory stays on your machine.
No comments yet. Be the first to write one.