AgentMemHub
统一提取你电脑上所有 AI Agent Harness 的对话历史 → 归一为全量事件流(含工具链、思维链、Shell 执行、代码补丁)→ 本地 SQLite 存储可搜索 → 记忆蒸馏(LLM 离线提炼为结构化记忆)→ 内置记忆引擎 agentmemhub.rag(向量化 + 混合召回 + 价值评分,进程内直调、无独立服务)→ 面板四标签页浏览(统一会话 / 记忆报表 / wiki知识库:L2 蒸馏产物 + 外部投喂页面 / 设置:只读配置视图)。
让任何 Agent 的会话经验,变成可检索、可迁移、可复用的统一记忆资产。
界面一览
下列截图用虚构演示数据生成(
scripts/make_demo_data.py造的「星轨笔记」示例库: 6 个会话 / 21 条记忆 / 11 篇知识库页 / 2 份投喂素材),不含任何真实会话与配置。 想自己看:跑该脚本后用AGENTMEMHUB_CONFIG=demo/config.yaml起一个独立端口。
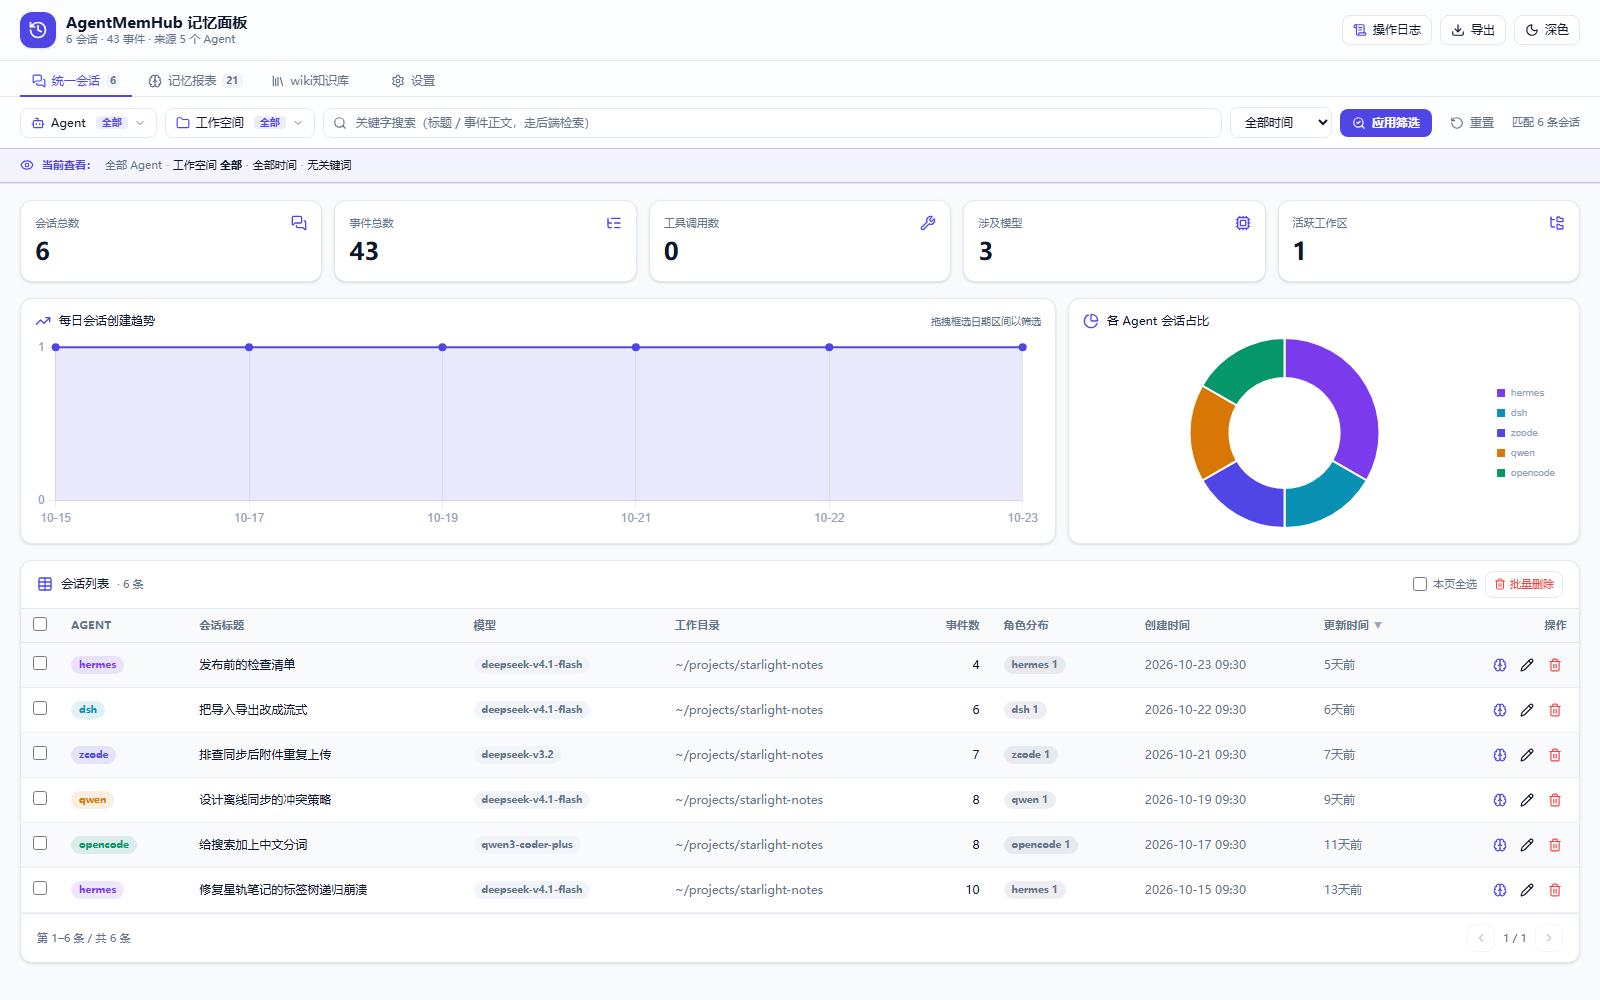
① 会话 —— 默认视图:来源徽章、模型、事件数、任务完成度
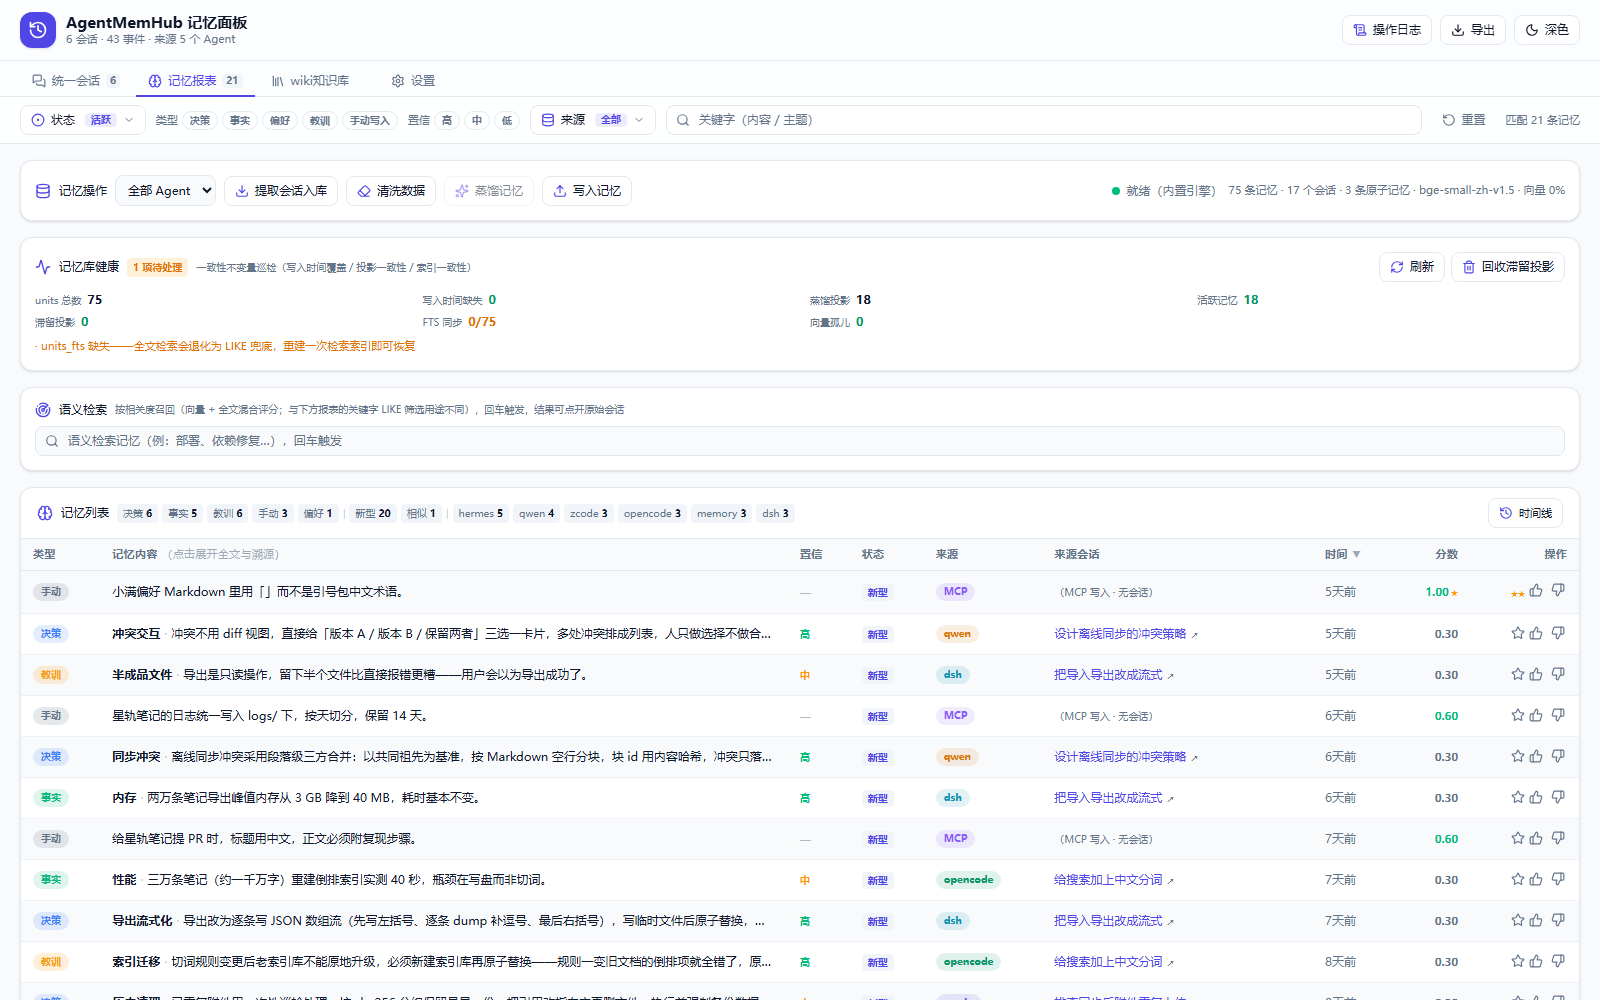
② 记忆报表 —— 蒸馏终稿 + 溯源 + ⭐ 手动加权 + 👍👎 反馈
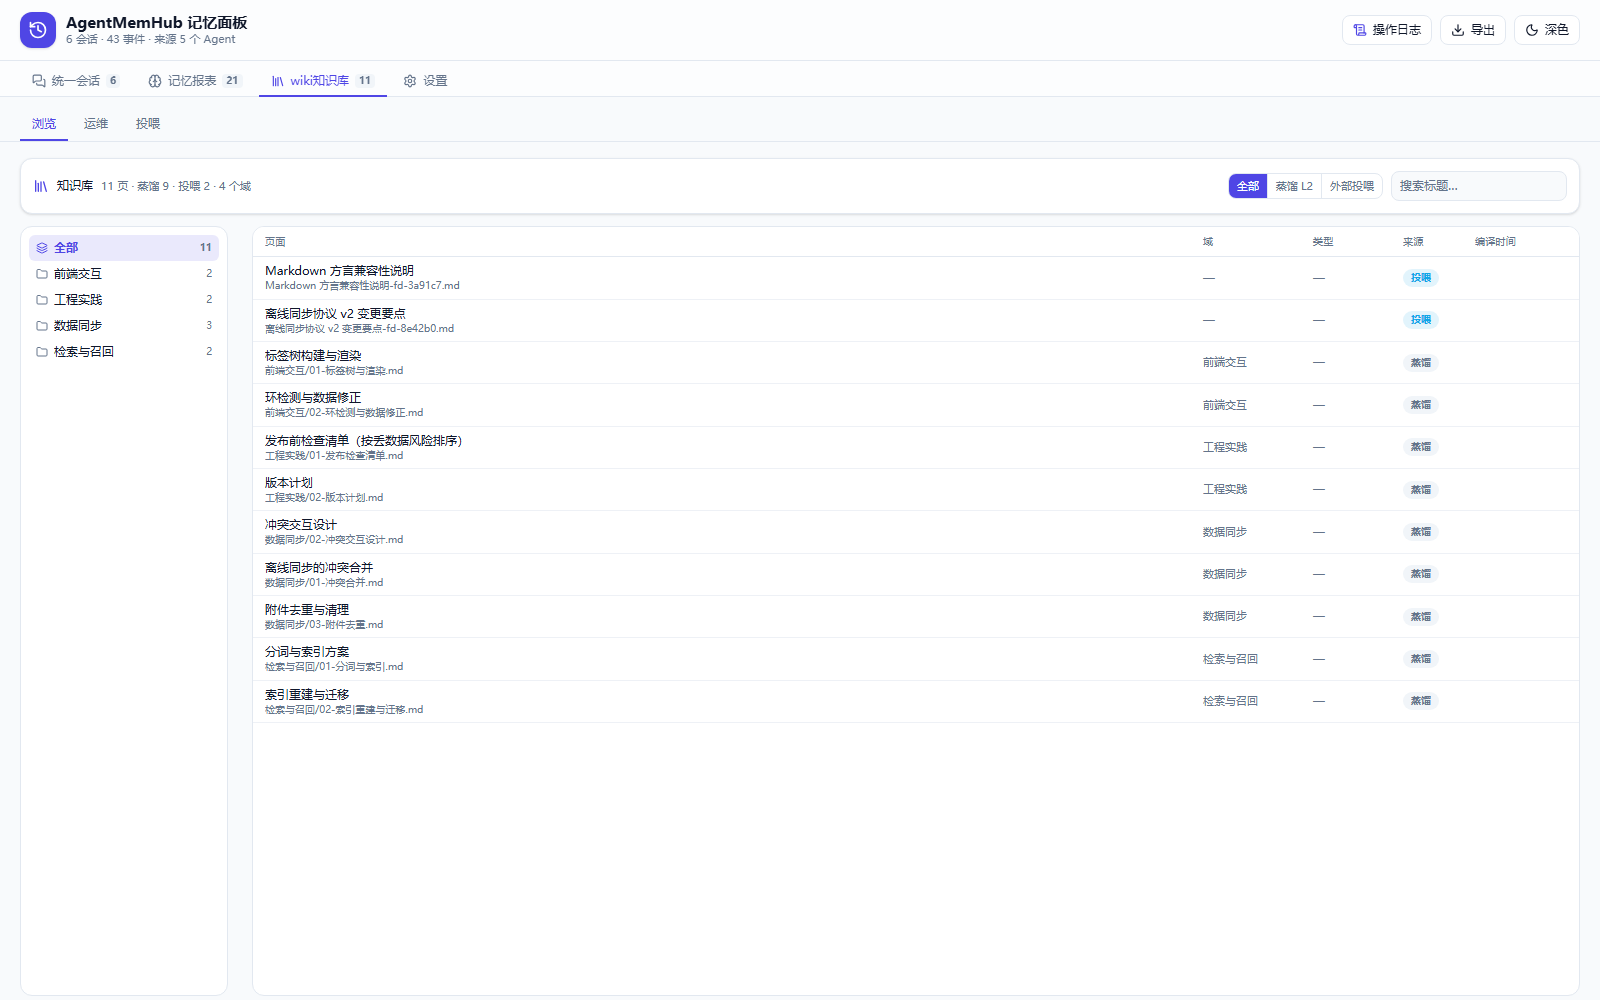
③ wiki 知识库 —— L2 蒸馏产物与外部投喂页面按域分组;正文里的 [m3236] 可点开溯源
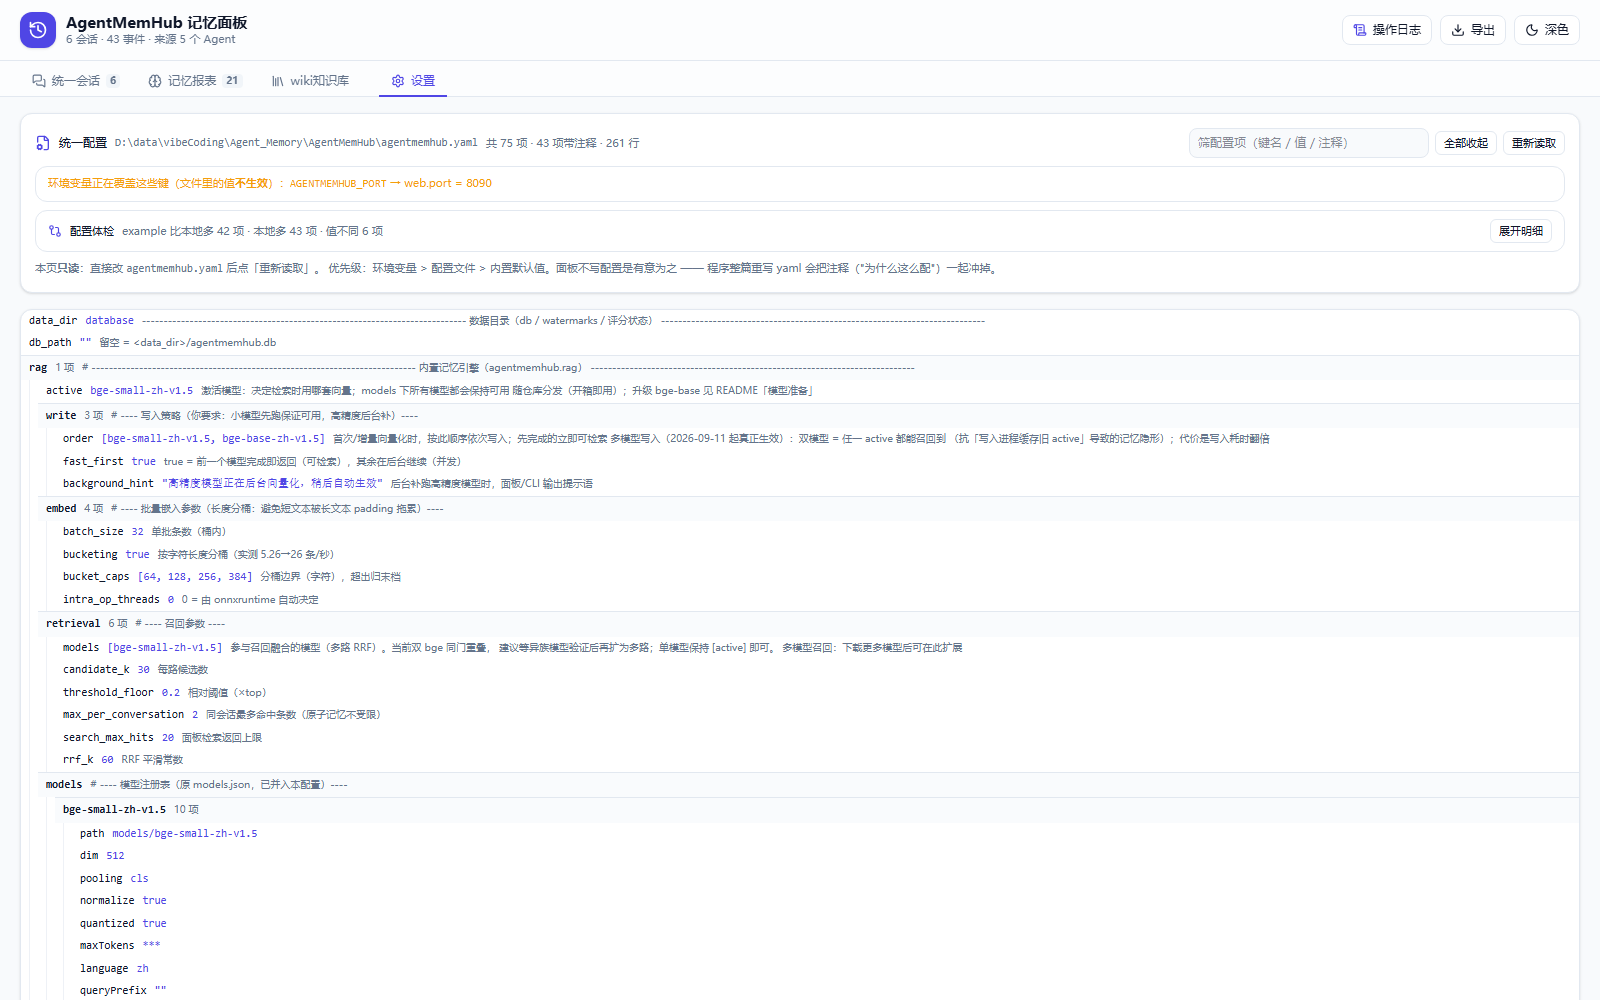
④ 设置 —— agentmemhub.yaml 的只读视图,保留每个键的原注释,标出被环境变量覆盖的项
v2.8(2026-10-24):MemOS 上游依赖彻底移除 —— vendored
memOS/目录、agentmemhub.memos模块、/api/v1/import端点、memos子命令、memory_backend与memos.*配置键全部删除,不再有回退开关。v2.7(2026-10-23):wiki 增量从「整会话重编」改为页级增量 —— 会话分桶 + L2 只重编受影响的页 + 投影只算变化页,12 条新记忆的编译耗时从 ~50 分钟降到 ~4 分钟。
v2.0(2026-09-10):记忆后端从上游 MemOS 引擎切换为自研内置引擎
agentmemhub.rag——进程内直调,无独立服务、无端口、无守护进程,启动面板或跑sync即完整可用。 MCP 五工具与面板契约零改动(2026-10 又新增了 3 个投喂工具,原有五工具的签名与返回 一字未改)。召回机制与实测数据见 docs/recall-fusion.md。更早的逐版变更见文末 Roadmap。
模型准备(首次使用必读)
记忆索引依赖嵌入模型将文本向量化。仓库自带最轻量模型开箱即用,更大模型按需下载:
| 模型 | 维度 | 体积 | 说明 |
|---|---|---|---|
| bge-small-zh-v1.5 | 512 | ~23MB | 随仓库分发,clone 即可用(默认启用) |
| bge-base-zh-v1.5 | 768 | ~99MB | 精度更高(召回 0.930 vs 0.887),按需下载 |
下载更大模型(可选,二选一后改 agentmemhub.yaml 的 rag.active):
# 从 HuggingFace 镜像下载(默认走 hf-mirror)
uv run python scripts/fetch_model.py Xenova/bge-base-zh-v1.5

# 下载后在 agentmemhub.yaml 中把 rag.active 改为 bge-base-zh-v1.5
# (模型目录名即模型 id;下载脚本会自动登记到配置)
换 active 模型的标准流程(顺序错会出现"记忆搜不到"):
- 改
agentmemhub.yaml的rag.active(新模型须先登记进rag.models); - 重建向量:
uv run python -m agentmemhub.rag.cli reembed --model <新模型>(只补缺失用uv run python -m agentmemhub rebuild --mode repair); - 重启常驻进程(面板 / MCP server)——它们启动时加载配置,不重启将 继续按旧模型写入,新记忆会落进另一张向量表、在召回侧"隐形"。
嫌换模型麻烦?把 rag.write.order 配成多模型(如 small + base),
写入时每个模型各存一份向量,任意 active 都能召回。
模型来源:Xenova/bge-small-zh-v1.5 ·
Xenova/bge-base-zh-v1.5(均为量化 ONNX)。
网络受限时脚本自动回退代理;国内可加 --base https://hf-mirror.com。
LLM 模型选型(记忆蒸馏 / Wiki 编译用)
上面是嵌入模型(负责检索)。蒸馏与 wiki 编译还要配一个生成模型(llm 段),
选型直接决定质量与成本:
| 模型 | 输入 / 输出(USD/百万 token) | 说明 |
|---|---|---|
xiaomi/mimo-v2.6-flash ⭐ 推荐 |
0.14 / 0.28 | 2026-09-22 上游新上架,价格与 V2.5 持平,按"同价优先新模型"切换;质量指标待重测(上一版 V2.5 实测 12/12 稳定、思维链仅占输出 24~37%,可作预期参考)。配 repair_model 补 JSON 遵从性 |
xiaomi/mimo-v2.5 |
0.14 / 0.28 | 同价回退位(已实测:真实成本≈deepseek 的一半);新模型出问题时换回 |
meituan/LongCat-2.0:free ⭐ 次选 |
免费(100 请求/天) | 适合放后台大批量、多次重跑——同一批目标跑多轮取更优结果,零成本提质量 |
deepseek/deepseek-v4.1-flash |
0.15 / 0.60(低谷) | 247 tok/s(全表最快);注意峰谷计价(国内工作时段翻倍) |
z-ai/glm-5.3-flash |
0.15 / 0.50 | 官网 Intelligence 41.9(全表最高),付费档质量优先 |
zai-org/GLM-5.2-Fast |
3.00 / 10.25 | ⚠️ "Fast"是高吞吐定位不是便宜——比同厂 glm-5.3-flash 贵 20 倍,极易误选 |
免费档还有 inclusionai/ling-3.0-flash-sante:free(100 请求/天)与
poolside/laguna-s-2.1-free(唯一无日限)。完整对标(含计费模式与三个坑)
见 docs/model-selection.md。
配置位置:agentmemhub.yaml 的 llm 段;两级 wiki 编译刻意不级联
(wiki.llm 与 wiki.l2.llm 各自相对顶层覆盖,见 docs/llm-wiki.md)。
支持的 Agent
| Agent | 数据来源 | 格式 |
|---|---|---|
| ZCode | ~/.zcode/cli/db/db.sqlite |
SQLite |
| OpenCode | ~/.local/share/opencode/opencode.db |
SQLite |
| Hermes | %LOCALAPPDATA%\hermes\state.db |
SQLite |
| WorkBuddy | ~/.workbuddy/workbuddy.db + audit-log |
SQLite + JSONL |
| Qwen | ~/.qwen/projects/*/chats/*.jsonl |
JSONL |
| QoderCN | ~/.qoder-cn/.../*.jsonl |
JSONL |
| DSH | ~/.dsh/sessions/*/session.jsonl.zstd |
zstd JSONL |
| Trae (CN) | %APPDATA%\Trae CN\ModularData\ai-agent\ + ~/.trae-cn/ |
Git 快照 + JSON + Markdown |
部分支持来源(最小可用):WorkBuddy 与 Trae 受源数据封闭限制,目前只能拿到 会话清单 + 局部数据(WorkBuddy:Shell 命令审计;Trae:每轮代码变更 diff + SOLO 产物清单 + 项目记忆),拿不到用户/助手的完整输入输出——等待官方开放接口后补全。
项目架构
   ┌───────────────────────────── AgentMemHub(本项目) ─────────────────────────────┐
   │                                                                                 │
   │  采集层                        存储层                 消费层                     │
   │  ┌──────────────┐           ┌────────────┐     ┌────────────────────┐          │
   │  │ adapters/    │  ingest   │ SQLite 会话库│    │ CLI(22 个子命令)      │          │
   │  │ 8 个数据源     │ ────────▶│ (store.py) │     │ 控制台(start.bat)    │          │
   │  │ (sqlite/jsonl)│           │ events+fts │     │ Web 看板(/api/*)    │          │
   │  └──────────────┘           └─────┬──────┘     └────────┬───────────┘          │
   │                                  │                      │                      │
   │   记忆层   ┌──────────────────────┼──────────────────────┘                      │
   │            ▼                      ▼                                             │
   │      统一事件流        向量化 ingest(按长度分桶 + 多模型编排)                      │
   │            │                      │                                             │
   │            │                      ▼                                             │
   │            │             ┌──────────────────────────────────┐                   │
   │            │             │ 内置记忆引擎 agentmemhub/rag      │                   │
   │            └────────────▶│ units + vec_<model> + trigram FTS │                   │
   │          (检索/看板/导出)│ 六路通道 RRF 融合 + 价值评分       │                   │
   │                          └──────────────────────────────────┘                   │
   │                                                                                 │
   │   配置层:agentmemhub.yaml(全路径可配置)+ 环境变量覆盖                           │
   └─────────────────────────────────────────────────────────────────────────────────┘
目录结构
AgentMemHub/
├── agentmemhub/                  # 核心包(36 个顶层模块 + adapters/ web/ rag/ feed/)
│   ├── cli.py / console.py       # 命令行入口 / 交互式控制台
│   ├── config.py / config_doc.py # 统一配置(YAML + 环境变量)/ 保注释的行扫描读取
│   ├── store.py + schema.sql     # SQLite 会话库(conversations/events/events_fts)
│   ├── watermarks.py             # 增量同步水位/变更集(delta)状态
│   ├── rag/                      # ★ 内置记忆引擎(v2.0)
│   │                             #   config/embedder/ingest/search/memstore/runtime
│   ├── rag_bridge.py             # ★ 引擎接缝:MCP/面板/cli 的统一调用入口
│   ├── distill.py / scoring.py   # 记忆蒸馏 / LLM 三轴评分(策略层)
│   ├── llm.py                    # LLM 接入(重试退避 / 总时长上限 / 沙箱熔断)
│   ├── wiki.py / wiki_index.py   # ★ LLM Wiki 两级编译 + 页面投影进召回面
│   ├── wiki_manifest.py          #   L1 输入清单(脏会话与增量判定的真源)
│   ├── wiki_pending.py           #   待更新记忆:软/硬删除 + 忽略与恢复
│   ├── wiki_triggers.py          #   离线触发器(时点/阈值/总闸,写 overrides 不改 yaml)
│   ├── llm_batch.py              # ★ 离线批处理(Batch API,官方价五折)
│   ├── batch_client.py           #   厂商 Batch 客户端(提交/轮询/取结果)
│   ├── batch_ops.py              #   CLI 与 HTTP 共用的动作层
│   ├── task_queue.py             #   通用惰性收割(开 DSH / 写记忆时顺手推进一次)
│   ├── wiki_batch.py             #   wiki 两级的离线批处理适配
│   ├── snapshot.py               # 快照与回滚(索引库 + wiki 产物目录)
│   ├── health.py                 # 记忆库一致性巡检(面板健康卡片/CLI/测试共用判据)
│   ├── failures.py               # ★ 长任务失败清单(分类/汇总/单独重跑,供 wiki 两级使用)
│   ├── logs.py / notify.py       # 事实流日志 / 通知推送(通道可插拔)
│   ├── mcp_server.py             # MCP 记忆网关(stdio / Streamable HTTP;含调用审计与 feed 投喂工具)
│   ├── mdmini.py                 # 面板用的极简 Markdown 渲染(先转义再套结构)
│   ├── export.py / sanitize.py   # 导出 / 内容脱敏
│   ├── feed/                     # ★ 外部投喂转译层(格式注册表 + 三段物料)
│   ├── adapters/                 # 8 个 Agent 数据源适配器(src_id/turn_key/注入识别)
│   ├── web/                      # FastAPI 记忆面板 + 前端 + /api/* 网关
│   └── engine_api.py           # 引擎运行时门面(/api/v1/* 端点派发到进程内 rag_bridge)
├── models/                       # 嵌入模型(自带 bge-small 开箱即用)
├── agentmemhub.yaml(.example)    # 统一配置(模型/分桶/召回/后端开关;本体 gitignore)
├── database/                     # 数据目录(gitignore):采集库 + 索引库 + 水位 + 评分状态
├── scripts/                      # 工具脚本(仅列常用)
│   ├── fetch_model.py            #   下载更大嵌入模型并登记到配置
│   ├── check_eval_grounding.py   #   召回评测集落地校验
│   ├── sensitive_scan.py         #   推送前敏感信息扫描
│   ├── audit_frontend_api.py     #   路由 ↔ 前端调用对账(--used / --json)
│   ├── check_config_keys.py      #   僵尸配置键检测(定义了但没人读的键)
│   ├── web_verify.py             #   面板前后端接口联调自检(对运行中的服务)
│   ├── health_check.py           #   记忆库一致性巡检(与面板「记忆库健康」同判据)
│   ├── mcp_log.py                #   MCP 调用审计查询(logs/mcp.log 的读取端)
│   ├── wiki_compile.py           #   LLM Wiki 第一级:逐会话把零散记忆编译成页面
│   ├── wiki_aggregate.py         #   LLM Wiki 第二级:跨会话按主题聚合成实体页
│   ├── wiki_linkfix.py           #   wiki 链接修复(按合并关系重定向失效链接)
│   ├── sync_llm_from_dsh.py      #   从 DSH 配置同步 LLM 接入参数(密钥只写本地 yaml)
│   └── e2e/                      #   浏览器级端到端测试
├── eval/                         # 召回评测示例集(queries.example.yaml;私有集不入库)
├── tests/                        # pytest(1466 项通过 / 1 项条件跳过;88 个测试文件)
├── docs/                         # 技术文档(架构全景/蒸馏/召回/wiki/模型选型/接口契约)
├── start.bat                     # 启动控制台(Windows)
├── ClearData.bat / ClearTest.bat # 清空数据 / 恢复干净测试环境
└── AGENTS.md / ARCHITECTURE.md   # 协作约定 / 架构说明
接口文档:对外接口(HTTP API / MCP 工具 / CLI)的完整契约见
docs/API.md;服务运行时还有交互式文档 /api/docs(Swagger UI)
与机器可读的 /openapi.json。
数据流(三阶段闭环)
- 采集:
ingest从各 Agent 的官方数据位置读取会话(路径可经agents.*配置覆盖),归一为全量事件流(含工具链/思维链/Shell/补丁,每事件带src_id/turn_key稳定锚与系统注入标记)写入本地 SQLite - 消费:CLI/控制台/Web 看板检索、浏览、导出、管理会话——全部读本地库,不上传任何数据
- 记忆:
sync把事件流向量化写入内置索引(按长度分桶批处理、多模型并发、src_id幂等)→ 对话时经六路通道召回(向量 / 全文 / 标识符 / 多词短语 + 页面专属两路)融合命中
派生层(只读,不改写上面三层)
- 编译:
scripts/wiki_compile.py把蒸馏记忆逐会话编译成页面 →scripts/wiki_aggregate.py跨会话聚合成主题实体页 →scripts/wiki_linkfix.py按合并关系修链接。 产物是独立 markdown,随时可全量重建;RAG 与用户数据可以影响 wiki, wiki 不会反向影响 RAG。详见 docs/llm-wiki.md。
快速开始
方式 A — 控制台(推荐,新用户入口)
# Windows 双击 start.bat,或命令行无参数直接进入菜单:
uv run python -m agentmemhub
菜单涵盖:提取入库 → 清洗数据 → 蒸馏记忆 → 写入记忆(向量化)→ 检索 → 看板启停 → 状态总览。 (自动评分入口已隐藏,见下方「命令行」表格备注)
方式 B — 命令行
# 1. 提取所有 Agent 并入库
uv run python -m agentmemhub ingest

# 2. 搜索(FTS5 英文 + 中文子串)
uv run python -m agentmemhub search "登录"

# 3. 查看某个会话(Markdown,含思维链+工具)
uv run python -m agentmemhub show zcode sess_xxxx

# 4. 导出全量(JSONL 每行一事件 / Markdown 可读)
uv run python -m agentmemhub export --format jsonl --out exports/
uv run python -m agentmemhub export --format markdown --out exports_md/

# 5. 写入记忆:采集 + 向量化(小模型先跑完即可检索,大模型后台并发补齐)
uv run python -m agentmemhub sync

# 6. LLM 批量评分(⚠️ 当前不生效:实测多为 neutral/全跳过;命令保留备查)
uv run python -m agentmemhub score
查询示例
# ---- 关键词搜索 ----
# 中文自动走 LIKE 子串匹配,英文/词组走 FTS5 全文索引
python -m agentmemhub search "登录"                        # 全部 8 个来源
python -m agentmemhub search "登录" --source zcode         # 只搜某个来源
python -m agentmemhub search "登录" --role tool            # 只搜工具事件
python -m agentmemhub search "登录" --role reasoning       # 只搜思维链
python -m agentmemhub search "登录" --limit 50             # 条数限制(默认 20)

# ---- 查看单个会话(Markdown,含思维链/工具/补丁渲染)----
python -m agentmemhub show zcode sess_d8648672-3cc8-4bbc-8e4f-3e50afc6b032
python -m agentmemhub show opencode ses_0b10aad95ffe70V5

# ---- 列出会话 ----
python -m agentmemhub list                        # 全部来源
python -m agentmemhub list --source hermes        # 只列某个来源
导出示例
# 导出为 JSONL:每个会话一个 <source>__<session_id>.jsonl,每行一个事件
python -m agentmemhub export --format jsonl --out exports/
# → exports/zcode__sess_d86486....jsonl, exports/opencode__ses_0b10....jsonl, ...

# 导出为 Markdown:人类可读,含 👤用户/💭思考/🔧工具/📝修改 渲染
python -m agentmemhub export --format markdown --out exports_md/
# → exports_md/zcode__sess_d86486....md, ...

# 只导出某个来源、指定输出目录
python -m agentmemhub export --format markdown --source zcode --out exports_zcode/

# 写入记忆索引(采集 + 向量化;小模型先跑完即可检索)
python -m agentmemhub sync
导出的 JSONL 每行就是一个标准事件:
{"role":"user","content":"帮我修复登录页面","time":1750000001}
{"role":"reasoning","content":"登录按钮没反应,先看代码","time":1750000002}
{"role":"tool","tool_name":"Bash","tool_input":{"command":"npm test"},"tool_output":"FAIL src/login.ts","tool_status":"completed","time":1750000003}
数据与文件存放位置
| 内容 | 默认位置 | 覆盖方式 |
|---|---|---|
| 数据目录(所有本地状态) | 项目内 database/ |
环境变量 AGENTMEM_HUB_DATA_DIR 或 yaml data_dir |
| 采集库(统一事件流) | database/agentmemhub.db |
环境变量 AGENTMEMHUB_DB |
| 记忆索引库(向量 + 全文 + 评分) | database/session_rag.db |
随数据目录 |
| 投喂素材库(原件快照 / 正文 / 发布页登记) | database/materials.db |
随数据目录 |
| 通知发送记录 | database/notify.db |
随数据目录 |
| 增量水位 / 评分记账 | database/watermarks.json · scored_traces.json |
随数据目录 |
| wiki 产物(L1 / L2 页面 + 逐页 json) | exports/wiki_work/out_l1_mimo · out_l2_mimo · out_feed |
yaml wiki.out_l1 / wiki.out_l2 |
| 嵌入模型 | models/ |
自带 bge-small;scripts/fetch_model.py 下载更多 |
| 导出目录 | exports/ |
--out 参数 |
默认数据已收进项目内
database/(已 gitignore,随项目走,备份/整机迁移只需带走项目目录)。 从旧版~/.agentmemhub迁移:把旧目录内容整体复制到database/即可 (agentmemhub.db连同-wal/-shm、scored_traces.json、config.json); 不迁移则视为全新环境,由增量 ingest 从各 Agent 源自动重建。
数据库三张核心表:
conversations— 会话元数据(source / id / title / cwd / model / 时间)events— 全量事件流(role / content / tool / reasoning / patch / shell,含raw_json原始保底)events_fts— FTS5 全文索引(英文检索)
记忆索引库(database/session_rag.db,由内置引擎管理):
units— 记忆单元(消息级文本,模型无关;含turn_key轮次锚、legacy_id旧系统别名与tags标签)vec_<model>— 每模型独立的向量表(sqlite-vec,维度建表时固定)units_fts— trigram 全文索引(中文友好,与标题列联合)unit_values/unit_feedback— 价值评分与反馈明细(引擎存值,打分策略在 Hub 侧)memory_exclusions— 位于采集库:记录哪些会话/轮次不写入记忆
exports/已加入.gitignore,含真实对话的导出不会进入仓库。
编程访问(Python)
核心存储层可直接编程调用:
from agentmemhub.store import Store

store = Store()                                  # 默认 <项目根>/database/agentmemhub.db
convs = store.list_conversations("zcode")        # 列出 zcode 的会话
events = store.get_events("zcode", "<session-id>")  # 读取某会话事件流
hits = store.search("登录", role="tool")          # 搜索工具事件
统一事件流(全量保留)
不丢弃工具链、思维链、Shell 执行、代码补丁——每行一个 JSON 事件:
{"role":"user","content":"帮我修复登录页面","time":1750000001}
{"role":"reasoning","content":"登录按钮没反应,先看代码","time":1750000002}
{"role":"tool","tool_name":"Bash","tool_input":{"command":"npm test"},"tool_output":"FAIL src/login.ts","tool_status":"completed","time":1750000003}
{"role":"assistant","content":"是事件监听器问题","model":"claude-x","time":1750000004}
{"role":"patch","patch_file":"src/login.ts","patch_diff":"@@ -12,3 +12,5 @@","time":1750000005}
每个事件保留 raw_json(各 Agent 原始 JSON)实现无损保底。
命令行
| 命令 | 说明 |
|---|---|
ingest [--source x] [--full] |
提取全部/指定 adapter 并入库(默认会话级增量:只重读变化会话,见下文「增量同步架构」;--full 整源清空重建) |
list [--source x] |
列出会话 |
show <source> <id> |
查看会话(Markdown) |
search <q> [--source] [--role] [--limit] |
全文搜索事件正文 |
export --format jsonl|markdown [--source] [--out dir] |
导出 |
folders [--source] [--limit] |
按文件夹统计各 Agent 会话数 |
sync [--source] [--full] |
采集 + 向量化写入记忆索引(增量;小模型先跑完即可检索,大模型后台并发补齐) |
mcp [--http] [--bind H] [--port P] |
MCP 记忆网关:默认 stdio(Agent 拉起);--http 常驻为 Streamable HTTP 供团队共享 |
feed --action add|list|show|retry|retract|forget|lint|formats|scan|batch |
外部投喂转译层:把 md / 网页 / PDF / Office / 思维导图 / 表格转译成知识库页面(与自有 wiki 并列,origin=external,不进记忆与 wiki 编译)。add 支持"路径 / 二进制 / URL / 正文"四形态(CLI 侧是 feed add <路径> 或 feed add --stdin);scan 只读预览、batch 默认不落盘(--apply 才写);formats 控制允许哪些后缀 —— 详见 docs/modules/feed.md |
clean [--source x] [--apply] |
记忆清洗:删除系统注入事件(默认预览,--apply 才执行并重建 FTS/计数;sync 会自动只清变更会话) |
score [--pending] [--limit N] [--dry-run] [--workers N] [--ids id1,id2] [--unscored-count] [--sync-episodes] |
⚠️ 当前不生效(入口已从控制台/面板隐藏;实测评为 neutral 居多且跑批全跳过,质量把关由蒸馏置信度 + 面板 👍/👎 承担)——命令保留备查。原功能:LLM 批量自动评分历史记忆(增量优先:pending_score 队列非空只评队列·定点读零全量枚举,队列空则先筛未评 id 再读正文;--pending 仅评队列,--ids 只评指定条(写后即评),--unscored-count 统计未评条数(只读 id),--sync-episodes 回填 episode.r_task;三档 verdict 均记入跳过清单——positive/negative 写 value、neutral 不写值但仍标记「已评」避免下次重评(dry-run 一律不记录);网关内容审核拒评(如智谱 1301)自动归 neutral 并记账,不再每次卡该条报错;LLM 调用强制直连、不受系统代理影响,确需代理设 AGENTMEMHUB_LLM_PROXY) |
rebuild [--mode repair|rebuild] |
补向量:给缺向量的记忆补嵌(repair)/ 全量重算(导入记忆后修复语义检索) |
weight --ids id1,id2 [--value V] |
记忆手动加权:锁定价值分(优先于自动聚合、不衰减) |
wiki --action failures|retry --out DIR [--stage l1|l2] [--src DIR_L1] [--workers N] |
LLM Wiki 运维:查看失败清单(按原因分类)/ 定向补跑失败项(只跑失败的,不全量重来) |
wiki --action pending|ignored|drop|restore |
待更新记忆的查看与删除:pending 列明细;drop --ids a,b --mode soft(不进 wiki、仍可召回)/ --mode hard --confirm(真删);ignored 列已忽略;restore 取消 |
wiki --action triggers|trigger|align|update |
触发器状态 / 手动触发 / 对齐审计(只读)/ 增量更新;triggers --set-batch on|off 热改离线触发器总闸(写 overrides,不用重启) |
wiki --action backfill-manual|index-pages |
backfill-manual:历史 Agent 直写记忆回填蒸馏表(幂等);index-pages:把 L2 知识页投影进召回面(页级召回) |
wiki --action full-run [--offline] |
全量重跑:重新归域 + 全部域重编 + 覆盖写盘(域编号会重排)。什么时候用:增量归类"撑不住"时(align 提示"『待整理』域已有 N 页")—— 该重新归纳的是域结构本身。通道由 wiki.full.mode(realtime/offline)决定,--offline 可临时覆盖;⚠️ 编译段约 300+ 条请求,动手前自动留快照 |
wiki --action batch-status|batch-run|batch-cancel|batch-resubmit |
离线批处理(MiMo Batch API,官方价是实时的 50%):batch-status 查在飞任务(厂商状态 / 进度 / 已等多久 / 建议);batch-run 推进一段(无在飞→提交、结果到位→交下一段或落盘,状态机自判);batch-cancel 取消作废;batch-resubmit 平台侧 validation_failed 后用原输入文件重提。收割是自动的(开 DSH / 写记忆 / 跑任意 CLI 命令都会顺手推进一次),发起由离线触发器 wiki.batch.enabled 或手动 batch-run 决定,详见 docs/modules/batch-offline.md §3.4/§3.5 |
memory-log [--event write|read] [--path mcp|http|distill|cli] [--grep 词] [--json] |
记忆操作事实流:什么时候写了/读了什么记忆(含内容全文与来源路径) |
snapshot [--snapshot-action create|list|restore] |
快照与回滚(索引库整库 + wiki 产物目录) |
llm-config [--json] |
配置自检:列出各 LLM 使用点(蒸馏/评分/Wiki 一级/二级)最终生效的配置,并标出每项是继承还是覆盖 |
stats / adapters |
统计 / adapter 状态 |
更完整的代码与 SQL 示例(按 Agent 查询、按文件夹跨 Agent 统计、会话角色分布、直连数据库等)见 docs/EXAMPLES.md。
增量同步架构
提取入库、清洗、推送、评分不再全量扫描——整条链路围绕一个**变更集(delta)**运转:
adapter.list_sessions(轻量清单) ──对比──▶ 库内 updated_at
        │ 只重读变化会话(load(only_ids))
        ▼
store.upsert_sessions(会话级 upsert,单事务,源端已删会话保留=历史保全)
        │ 变更集写入 <data_dir>/watermarks.json
        ▼
clean(只清变更会话的注入事件) → push(只构建/推送变更会话的 traces)
        │ 推送成功的 trace id 入 pending_score 队列
        ▼
score(增量优先:队列非空只评队列·定点读引擎库,队列空才全量筛未评——零无谓全表枚举)
适配器三级增量策略(新 adapter 按数据源能力自选层级,见 adapters/base.py):
| 层级 | 机制 | 适用 |
|---|---|---|
| 会话级清单 | list_sessions() 只读 id/时间(单 SELECT / rglob+stat / 首行 peek),精确对比逐会话 |
zcode、opencode、hermes、workbuddy(表)、qwen、qodercn、dsh(peek 首行) |
| 源级新鲜度 | source_freshness() 最大 mtime > 上次水位 → 整源重扫(force upsert),兜底清单看不见的变更 |
workbuddy 审计日志追加 |
| 整源重扫 | 无轻量清单 → 整源 load,upsert 按 updated_at 幂等对比 | trae(快照 git 仓库,量小) |
watermarks.json(<data_dir>/,version 化,扩展点:新流水线阶段读 delta、登记自己的 consumed 时间戳即可接入):
last_ingest.sources— 每源上次同步水位(新鲜度信号对比基准)delta.conversations— 变更会话集[{source, id, status}];连续两次 ingest 之间下游未消费时自动合并防丢;超cap(5000) 标记oversized,下游该轮回退全量扫描(正确性优先)pending_score— 待评分 trace id 队列(评分入口增量优先消费:面板/控制台/score/score --pending队列非空即只定点评这批,成功后出队、有失败整队列保留下次重试)consumed— 各阶段消费水位;推送有失败批次时不标记,下次 sync 重试
水位文件缺失/损坏 = 无状态,下一次 ingest 仍可运行(对比基准是库本身),下游回退全量——任何时候 ingest --full 都是逃生口。
数据默认存放在项目内(database/)
可写数据(SQLite 库、watermarks、评分状态、托管 pid)默认落 <项目根>/database/
——随项目走,备份/整机迁移只需带走项目目录;database/ 已 gitignore,严禁入库。
环境变量 AGENTMEM_HUB_DATA_DIR 或 yaml data_dir 仍可覆盖(测试隔离/自定义位置,
测试套件由 conftest 强制指向临时目录)。
ClearData.bat Y 一键清空应用数据重新开始(不动引擎与 Agent 源数据);
旧版数据在 ~/.agentmemhub,整体复制进 database/ 即完成迁移。
Agent 协作配置(装完必做)
记忆能力要真正用起来,需要三步配置。只配 MCP 不配另两项,记忆不会自动沉淀—— Agent 不会自觉保存,必须靠规则约束。
步骤 1:注册 MCP server(能力)
见下节「MCP 记忆网关 → 注册配置」。配好后 Agent 才能调用 memory_save / memory_search。
步骤 2:安装 save-memory Skill(流程)
git clone https://github.com/MerlinShieh/Agent-skill-save-memory.git ~/.zcode/skills/save-memory # ZCode;其他 Harness 放对应 skills 目录
Skill 定义何时保存(写入即完成,不自动评分——价值分由真实使用演化)。它不含存储实现, 强绑定本项目的 MCP 工具,无降级路径。
步骤 3:把记忆纪律写进 AGENTS.md(触发保障)⚠️ 最容易漏
Skill 的触发依赖模型自觉,长对话/高负载下会漏触发。必须把下面这条硬规则
加入当前项目的 AGENTS.md 或 Harness 的全局指令文件
(如 ~/.zcode/AGENTS.md、~/.config/opencode/AGENTS.md、~/.qwen/QWEN.md):
## 记忆保存纪律(硬性规则)

长期记忆存在本地记忆索引(AgentMemHub 内置引擎 agentmemhub.rag),
通过 agentmemhub MCP 工具读写。任务收尾时自查:本次是否产出了可复用结论
(问题解决步骤 / 踩坑解法 / 架构决策 / 关键配置变更)?命中必须:

1. memory_stats 探活——不可用时告知用户建立索引
   (AgentMemHub 项目内 uv run python -m agentmemhub sync;内置引擎无守护进程,
   没有"启动引擎"这个动作),不硬写;
2. memory_save 写入自包含结论(背景一句话 + 结论/做法);
3. 写入后不自动评分——价值分由真实使用演化(面板 👍/👎,或按需 memory_score)。

⚠️ 只写 Agent 自己的本地会话记忆不算完成——必须落到记忆索引。
需要历史经验时主动 memory_search,与保存流程互相独立。
本项目仓库内已含
AGENTS.md(见根目录),可直接参考;跨项目使用时把上面这段 复制到你自己的项目或全局指令文件。为什么必须做这步:没有这条规则,Skill 只是"能力"而非"义务", 会在最需要它的时候被遗忘——这是实践中反复验证的结论。
MCP 记忆网关(实时记忆读写)
把内置记忆引擎(agentmemhub.rag)的语义检索/写入包装成 MCP server,挂在 ZCode / OpenCode /
Claude Code 等支持 MCP 的 Agent harness 上——模型在会话进行中即可检索历史记忆、
主动保存值得长期保留的结论。与离线链路(统一提取 → bundle → 导入)互补。
⚠️ 本网关必须与 save-memory Skill
配套安装(触发纪律所在,见下文「必装组件」),只配 MCP 不装 Skill 不算接入完成。
| 工具 | 说明 |
|---|---|
memory_search(query, topK?, origin?, note?) |
语义检索历史记忆(六路通道融合),返回命中条目(带层级与来源标注)+ 注入上下文 |
memory_recent(limit) |
最近写入的记忆时间线,快速了解近期积累 |
memory_stats() |
索引就绪状态 / 记忆总量 / 嵌入模型与 LLM 评分可用性 |
memory_save(content, importance?, tags?, note?) |
写一条记忆。importance 为可选档位(high/normal/low → 初始价值 0.8/0.6/0.4,不传即 normal),由 Agent 用当前推理直接判断,无需外挂评分模型;tags 为可选标签数组(面板筛选/溯源用,引擎纯透传)。即时入库并补向量,写后验证 imported,失败明确报错不伪装 |
memory_score(trace_id, polarity, note?) |
按需对任意一条记忆打分(反馈 → 引擎即时重算 value/priority;写后即评流程已废除,仅用户明确要求加权时使用) |
表中
note?是这三个工具共有的可选参数:写一句话操作意图(例:note="排查用户说的召回异常")。 它只进审计日志logs/mcp.log,不参与检索与存储——调用本身由服务端自动记录,note补充的是"为什么"。 查询日志:python scripts/mcp_log.py [--tool X] [--failed] [--grep 词]。
# 0. 确保记忆索引已建立(v2.0 起引擎内置,无需启动任何服务):
uv run python -m agentmemhub sync

# 用法一:本地个人(stdio,Agent 拉起子进程)——见下方「注册配置」
# 用法二:团队共享(Streamable HTTP,一台机器常驻网关):
uv run python -m agentmemhub mcp --http --bind 0.0.0.0 --port 9100

# 验证:在 Agent 会话里调用 memory_stats / memory_search
注册配置(两种传输的 MCP 配置直接贴这里)
⚠️ 记得把下方
<项目根>替换为你机器上的实际路径(例如D:/path/to/AgentMemHub)。 不要用uv run python——MCP 子进程在项目目录之外启动时会解析到错误的 python(No module named agentmemhub)。 ZCode 写在mcp.json的mcpServers段;OpenCode 写在opencode.json的mcp段(模板另见 docs/mcp-register.example.json)。
A. 本地个人(stdio)
{
  "mcpServers": {
    "agentmemhub": {
      "type": "stdio",
      "command": "<项目根>/.venv/Scripts/python.exe",
      "args": ["-m", "agentmemhub", "mcp"],
      "env": {}
    }
  }
}
OpenCode 对应写法(含裸命令备选:pip install -e . 后把 .venv/Scripts 加入 PATH,command 直接用 agentmemhub-mcp):
{
  "mcp": {
    "agentmemhub": {
      "type": "stdio",
      "command": "<项目根>/.venv/Scripts/python.exe",
      "args": ["-m", "agentmemhub", "mcp"],
      "enabled": true
    }
  }
}
B. 团队共享(Streamable HTTP)
服务端先常驻:python -m agentmemhub mcp --http --bind 0.0.0.0 --port 9100(默认只监听 127.0.0.1,开放局域网需显式 --bind 0.0.0.0 并自行做好访问控制)。客户端注册:
{
  "mcpServers": {
    "agentmemhub": {
      "type": "http",
      "url": "http://<服务器IP或hostname>:9100/mcp"
    }
  }
}
两种传输的工具完全一致(
memory_search/memory_recent/memory_stats/memory_save/memory_score),按场景选一种即可。
⚠️ 必装组件:save-memory Skill(与本项目强绑定)
MCP 网关只提供「做得到」(执行层工具),不解决「何时必须做」——Agent 主动保存记忆并 写后即评的触发纪律,由独立 Skill 仓库承载:
该 Skill 是本记忆链路的必装组件(不装则模型保存记忆行为不可靠:漏保存、保存不评分, 本项目实测踩过)。完整启用需要三件套,缺一不可:
- MCP 服务(执行层,本仓库)——按下方「注册配置」接入 harness;
- save-memory Skill(行为协议层)——克隆到当前 harness 的 skills 目录:
# ZCode git clone https://github.com/MerlinShieh/Agent-skill-save-memory ~/.zcode/skills/save-memory # OpenCode(或 ~/.agents/skills/) git clone https://github.com/MerlinShieh/Agent-skill-save-memory ~/.config/opencode/skills/save-memory - AGENTS.md 硬规则(触发保障)——把 SKILL.md「生效前提」中的规则原文粘贴进项目
AGENTS.md或 harness 全局指令文件(如~/.zcode/AGENTS.md)。
三层边界:AGENTS.md 管「必须做」、SKILL.md 管「怎么做」、MCP 管「做得到」。 Skill 与 MCP 强绑定、无降级路径——MCP 不可用时 Skill 会明确提醒配置而非改用别的方式保存。
设计要点:
- 引擎由调用方进程加载(v2.0 起进程内直调,无独立服务、无端口);网关只把请求
派发到本进程内的
rag_bridge,不存在「引擎离线」这种状态 - 协议层与传输层分离:stdio 零新依赖;Streamable HTTP 复用 web 依赖
(fastapi/uvicorn),
POST /mcp单端点(GET 405、DELETE 结束会话), 兼容 MCP 2024-11-05 / 2025-06-18 - 复用引擎网关的自动登录(已保存密码时免密直连);不写本地库、不改引擎源码
数据模型
采集库(database/agentmemhub.db):
- conversations:会话元数据(source/id/title/cwd/model/时间/signature,另含
session_uid全局递增会话 ID 与title_custom用户改标题标记) - events:全量事件流(role/content/tool/reasoning/patch/shell/raw_json)
- events_fts:FTS5 全文索引(英文走 FTS,中文子串走 LIKE 兜底)
- memory_exclusions:会话/轮次级「不写入记忆」标记(CLI/MCP 可用)
- deleted_conversations:删除墓碑(防 ingest 回灌,保住 uid 与标题资产)
索引库(database/session_rag.db):
- units:原子记忆文本(模型无关)。
src_id前缀区分来源:dst_<hash>= 蒸馏投影、mcp_<hash>= Agent 直写、wiki_<hash>= 知识页投影 - vec_ / units_fts:每个模型一张向量表(
sqlite-vec,换模型不互相污染, 表名由模型 id 推出)+ trigram 全文索引 - unit_values / unit_feedback:价值分(
manual_value= 用户 ⭐ 锁定值)与反馈记录 - distilled_memories:蒸馏终稿(type/topic/content/confidence/status + 完整溯源)
- distill_hashes:蒸馏幂等锚(切片/合并级内容哈希 + 提示词版本)
详见 ARCHITECTURE.md 与 docs/memory-distillation.md。
记忆引擎管理(内置 agentmemhub.rag)
v2.0 起记忆引擎内置于本项目(agentmemhub/rag/),进程内直调:
无独立服务、无端口、无守护进程、无鉴权。启动面板或执行一次 sync 即完整可用。
AgentMemHub/
├── agentmemhub/
│   ├── rag/                     ← 内置记忆引擎(向量化 / 混合召回 / 价值评分)
│   └── rag_bridge.py            ← 引擎接缝:以原 MemOS 端点语义实现进程内调用
├── database/                    ← 采集库 agentmemhub.db + 索引库 session_rag.db
├── models/                      ← 嵌入模型(自带 bge-small;更大模型按需下载)
└── agentmemhub.yaml             ← 统一配置(模型/分桶/召回/后端开关)
常用操作:
uv run python -m agentmemhub sync        # 采集 + 向量化写入记忆索引(首次必跑)
uv run python -m agentmemhub score       # LLM 批量评分(⚠️ 当前不生效,见命令行表格备注)
uv run python -m agentmemhub stats       # 索引规模统计
uv run python -m agentmemhub serve       # 启动记忆面板 http://127.0.0.1:8086
要点:
- "启动引擎"这个概念没有了:内置引擎由调用方进程加载。建立索引 =
sync; 面板/CLI/MCP 谁会用到谁就在自己进程里加载,不需要也不能"启停服务"。 - 多模型写入:
agentmemhub.yaml的rag.write.order支持多模型。 默认策略是小模型先跑完即可检索(bge-small 约 3 分钟完成全量), 高精度模型在后台子进程并发补齐,完成后自动生效。 - 性能优化:批量嵌入按文本长度分桶,避免短文本被长文本 padding 拖累 (实测 bge-base 从 5.26 → 26 条/秒,全量 51 分钟 → 11.6 分钟)。
- 没有回退开关了:MemOS 上游已于 2026-10-24 彻底移除(vendored 目录、模块、
导入端点、
memos子命令、memory_backend配置键全删)。agentmemhub/engine_api.py名字保留,但它现在只是进程内引擎的运行时门面(把 MemOS 时代的/api/v1/*端点语义派发到rag_bridge),没有守护进程可启停。
记忆蒸馏(把会话提炼为结构化记忆)
离线把原始会话去噪提炼为结构化记忆(决策 decision / 事实 fact / 偏好 preference / 教训 lesson),是检索质量的来源。四个使用入口:
| 入口 | 方式 |
|---|---|
| Python | from agentmemhub.distill import run_distill; run_distill(settings) |
| CLI | uv run python -m agentmemhub distill [--source X] [--limit N] [--dry-run] |
| 控制台 | start.bat → [3] 蒸馏记忆 |
| 面板 | 「记忆报表」页 →「蒸馏记忆」按钮(后台任务 + 进度条,两页可见) |
流程(五阶段,全本地):
S0 切片      固定轮数窗口(默认 16 轮)+ 话题边界细化 —— 追加新对话时
             已满窗口的历史切片逐字不变(增量稳定,不反复重蒸)
S1 段级蒸馏  LLM 逐片提炼 → 结构化 JSON(脱敏;丢弃寒暄与过程叙述)
S2 合并沉淀  同会话多片再合并去重(层级合并,批次化防超上下文)
S3 跨会话去重 与既有记忆向量近邻 → 三档标记 new / similar / duplicate
S4 投影      新/相似条目写入 units(role='distilled')→ 立即可被召回
要点:
- 幂等:切片级与合并级都按「内容哈希 + 提示词版本」判重,重复执行自动跳过; 已蒸馏会话追加新内容时只蒸新增切片,再与历史终稿重新合并
- 脱敏:prompt 层要求忽略凭据类内容 + 正则兜底(
agentmemhub/sanitize.py) - fail-open:单切片失败只计数不中断、不登记哈希,重跑自动补齐
- 结果隔离:蒸馏产物只存在于索引库(
distilled_memories+ 投影 units), 不影响采集库原文;排除(memory_exclusions)与删除会同步作用于投影 - 权重:蒸馏来源初始分 0.3(Agent 主动写入 0.6),可被 👍👎 反馈与 ⭐ 手动加权(锁定后不衰减)覆盖
LLM 接入(agentmemhub.yaml 的 llm 段;也可用 scripts/sync_llm_from_zcode.py
从 ZCode 客户端配置一键同步,密钥只写入 gitignore 的本地配置):
llm:
  endpoint: "https://api.deepseek.com/chat/completions"   # OpenAI 兼容端点
  api_key: ""                    # 只写入 agentmemhub.yaml(已 gitignore),不入库
  model: "deepseek-v4-flash"
  headers:                       # 可选:provider 特定请求头
    User-Agent: "AgentMemHub/1.0"
LLM Wiki(把碎片记忆编译成可读知识库)
RAG 之外的第二条路径。RAG 在查询时从原始碎片检索,每次重新推导、无累积, 优化的是「能不能捞到」;LLM Wiki 把已经沉淀的结论编译成结构化、互相链接的 markdown 页面,人和 Agent 都能直接读,优化的是「有没有结构」。
两层是单向关系:原始记忆可以影响 wiki,wiki 不会反向影响 RAG。
N 条蒸馏记忆
      │
      ├─ 第一级  scripts/wiki_compile.py    逐会话编译   → 每会话若干页(json + md)
      │                                      压缩比约 1.7:1
      └─ 第二级  scripts/wiki_aggregate.py  跨会话聚合   → 主题实体页
两级都只读运行:打开索引库副本、产出独立 markdown、不写任何数据表。
第一级:会话内编译
uv run python scripts/wiki_compile.py --list                    # 列出候选会话
uv run python scripts/wiki_compile.py --all --out DIR \
    --index-db database/session_rag.db --workers 8              # 全量
uv run python scripts/wiki_compile.py --source X --conversation-id Y --out DIR
先让 LLM 把会话内的记忆按主题分组(没有现成的分组键可用:topic 几乎唯一、
slice_key 是会话级的),再逐组编译成页面。长会话强制走两段式——推理模型的
思维链计入 max_tokens,一次喂 45 条记忆会在 32K 上限处被截断。
支撑断点续跑:已有产出的会话自动跳过,失败不中断整批。
第二级:跨会话聚合
# 只归域(便宜,先看域表质量)
uv run python scripts/wiki_aggregate.py --src 一级产出目录 --out DIR \
    --db database/session_rag.db --stage domains
# 单域试跑
uv run python scripts/wiki_aggregate.py --src ... --out DIR --db ... --domain DSH
三阶段:归域(几百个标题 → 主题域)→ 域内细分(决定哪几页合并成一页)→ 重新编译(把同一主题散在多个会话里的页面重写成一篇,不是拼接)。
第一级的页面按会话切,所以同一主题会散成好几页(AgentMemHub 一个实体就散在
十几个会话、几十个标题里);第二级按主题合回来,这才是真正的收敛点。
第二级会把正文里的会话内序号引用提升成全局记忆编号
[m123]—— 聚合后编号不冲突,且直接可追溯回distilled_memories。
详见 docs/llm-wiki.md。
配置:两级刻意不级联
wiki:
  llm:                    # 第一级(继承顶层 llm,只覆盖差异)
    thinking: "disabled"  # DeepSeek 官方支持彻底关推理
  l2:
    llm:                  # 第二级:**同样继承顶层 llm**,刻意跳过 wiki.llm
      reasoning_effort: "low"
      timeout: 900        # 默认 60s 对"输入几万字符"的调用必然读超时
      max_total_seconds: 600   # 单次调用"总时长"硬上限 —— socket 超时管不住
                               # "一直有数据在来但整体极慢"(实测有人 975 秒才返回)
级联继承会让第一级换 provider 时连带改掉第二级——实测踩过:第一级切到 DeepSeek 官方关推理后,第二级因此丢掉了 Command Code 的凭据。
统一配置
所有路径/端口默认采用官方默认;需要覆盖时创建 agentmemhub.yaml(模板见 agentmemhub.yaml.example)。优先级:环境变量 > 配置文件 > 内置默认。
data_dir: database                    # 本地状态根目录(采集库/索引/水位/评分)
db_path: ""                           # 采集库 SQLite(留空 = <data_dir>/agentmemhub.db)

rag:
  active: bge-small-zh-v1.5           # 检索用模型(随仓库分发,开箱即用)
  write:
    # 多模型写入(真正生效):逐模型各存一份向量——换 active 后旧记忆不会
    # 因向量在另一张表而在召回侧隐形;代价是写入耗时随模型数增加
    order: [bge-small-zh-v1.5]        # 向量化顺序;可加更多模型
    fast_first: true                  # 首个模型完成即返回可检索,其余后台并发
    background_hint: "高精度模型正在后台向量化,稍后自动生效"
  embed:
    batch_size: 32
    bucketing: true                   # 按文本长度分桶批处理(性能关键)
    bucket_caps: [64, 128, 256, 384]  # 分桶边界(字符)
  retrieval:
    # 多模型召回融合(真正生效,2026-09-11 起):逐模型向量路 + RRF;
    # 同门模型重叠度高,扩展前先评测
    models: [bge-small-zh-v1.5]
    # 召回严格度档位 1~5(1 最严格 … 5 最宽松,默认 3「均衡」)。
    # **一条刻度统一给出**:候选宽度 / 相对阈值 / 终审阈值 / 页面席位 /
    # 字面兜底席 / 证据门槛线 —— 不要再分别去配 candidate_k / threshold_floor
    # 那些单项(它们已由档位决定,见 docs/data-architecture.md §4.3/§13)。
    recall_level: 3
    # 按调用方细分档位(与 logs.files 同一模式:不配则回落上面的全局值):
    #   mcp=Agent 自动召回(求"少而准")/ panel=面板查询(求"不遗漏")
    #   cli=命令行 / eval=召回评测
    # callers:
    #   mcp: 3
    #   panel: 4
  models:                             # 模型注册表(新增模型在此登记)
    bge-small-zh-v1.5:
      path: models/bge-small-zh-v1.5
      dim: 512
      pooling: cls
      quantized: true
      maxTokens: 512

agents:
  zcode: ""                           # 各 harness 会话位置;留空=官方默认自动发现
  hermes: ""
web:
  port: 8086

llm:                                  # 蒸馏与评分共用(OpenAI 兼容端点)
  endpoint: "https://api.deepseek.com/chat/completions"
  api_key: ""                         # 只写入本地 agentmemhub.yaml(gitignore)
  model: "deepseek-v4-flash"
  headers: {}                         # 可选:provider 特定请求头

distillation:                         # 记忆蒸馏全部可调(不硬编码)
  enabled: true
  prompt_ver: null                    # 留空=跟随代码内版本(改提示词自动重蒸)
  direct_bucket: daily                # Agent 直写记忆(mcp/direct)按天分桶。
                                      # 不分桶时所有直写记忆共用一个虚拟会话,任一条新增
                                      # 都要整会话重编(详见 Roadmap v2.7);none = 退回旧行为
  slice: {max_turns: 16, max_chars: 24000, topic_boundary: true}
  merge: {enabled: true, max_chars: 8000, max_rounds: 6}
  dedup: {cosine_duplicate: 0.92, cosine_similar: 0.80}
  sanitize: {enabled: true}
  runtime: {max_concurrent: 4, timeout: 60}
  # llm: {}                           # 可选:蒸馏单独覆盖顶层 llm(继承+合并)
相对路径相对项目根解析,~ 展开为用户目录。
配置的「继承」有四种形态(改配置前必读)
同一个键可能被上层决定,也可能覆盖上层 —— 机制不止一种,不弄清容易写出 "配了不生效"或"覆盖范围超出预期"的配置。完整说明(含检查清单)见 docs/data-architecture.md §13。
| 机制 | 例子 | 覆盖项写在哪 |
|---|---|---|
| 内置默认 < 配置文件 | DEFAULT_WIKI → wiki 段 |
—(不配即用默认) |
| 集中式细分覆盖 | logs.rotate < logs.files.<日志名> |
集中在同名键下 |
rag.retrieval.recall_level < rag.retrieval.callers.<调用方> |
同上 | |
| 就地覆盖 | llm < wiki.llm / distillation.llm / wiki.l2.llm |
分散在各使用段 |
| 三层(仅页面策略) | 内置默认 < 档位 < rag.retrieval.page.* |
— |
"某个调用方到底在用哪份 LLM 配置"看不出来时:
uv run python -m agentmemhub llm-config          # 生效配置 + 继承/覆盖标注
uv run python -m agentmemhub llm-config --json   # 机器读
加/改配置键之后跑一次 uv run python scripts/check_config_keys.py —— 查"定义了
却没有任何读取点"的僵尸键(本项目踩过三次:wiki.single_shot_max、
wiki.workers、wiki.l2.*,共同特征是配置值恰好等于代码里硬编码的默认值,
所以既不报错、也不让测试变红)。
⚠️ 该脚本是启发式:按"键名在代码里出现过"判定,不保证真的从 yaml 读。 例:
rag.retrieval.candidate_k在代码里出现过(档位展开的 profile 有同名字段), 但 yaml 里配它不生效 —— 那类要人工复核(见 §13 检查清单)。
技术文档
按"想知道什么"索引(架构细节一律以第一份为准):
| 文档 | 内容 |
|---|---|
| docs/data-architecture.md | 架构全景(权威):三层数据模型、表矩阵、ID 锚体系、六路召回与准入、价值体系、快照回滚、运维速查、演进时间线 |
| docs/branch-milestones.md | 分支里程碑时间线:四个大里程碑做了什么 + 即将做的事(Roadmap) |
| docs/memory-deletion.md | 记忆软删除与 wiki 引用状态(设计基准):数据模型、接口、召回行为、环境安全(待实施) |
| ARCHITECTURE.md | 代码结构与模块职责(速览) |
| docs/recall-fusion.md | 多路召回融合的机制、算法与评测数据 |
| docs/memory-distillation.md | 记忆蒸馏:切片 / 合并 / 去重 / 投影全流程 |
| docs/llm-wiki.md | LLM Wiki 两级编译、增量更新、触发器、失败兜底与格式修复 |
| docs/batch-offline-plan.md | 离线批处理(Batch API)接入计划:决策记录 D1–D6、三段式流水线状态机、里程碑追踪与风险清单(M0–M3 已落地并实测两轮端到端,M4 开关与 M5 触发器已接核心部分;剩 M6 收尾) |
| docs/model-selection.md | LLM 模型选型与定价(含免费档与跑批注意事项) |
| docs/API.md | 对外契约:HTTP / MCP / CLI(含错误语义与长任务约定) |
| docs/EXAMPLES.md | SQL / CLI / Python 查询示例 |
| docs/branch-divergence.md | 历史归档:feat/llm-wiki 相对 main 的差异记录(该分支已于 2026-10-23 删除,内容全部并入 feat/kb-ui,删除前打了 tag llm-wiki-done = d5dd4f4) |
服务运行时另有交互式接口文档 /api/docs(Swagger UI)。
模块地图(改代码用)
上面的技术文档按"想知道什么"索引;这里是按职责域的代码地图, 每份固定六小节(职责边界 / 对外入口 / 数据流与不变量 / 配置项 / 调试与排障 / 测试在哪)。 不逐文件写 README(几十份必然与实现漂移),按域合并。
| 职责域 | 代码 | 模块文档 | 状态 |
|---|---|---|---|
| LLM Wiki 编译链 | wiki.py、wiki_index.py、wiki_manifest.py、wiki_pending.py、wiki_triggers.py、scripts/wiki_*.py、obsidian.py |
docs/modules/wiki.md | 已写 |
| 配置体系 | config.py、config_doc.py、scripts/check_config_keys.py、scripts/sync_llm_*.py |
docs/modules/config.md | 已写 |
| 日志与可观测性 | logs.py、failures.py、snapshot.py、notify.py |
docs/logging.md(事件字典 + 排查剧本) | 已写 |
| 离线批处理(Batch API) | llm_batch.py、batch_client.py、wiki_batch.py、task_queue.py(通用惰性收割)、batch_ops.py(CLI/HTTP 共用动作层) |
docs/modules/batch-offline.md | 已落地(M0–M3 + M4/M5 核心;剩 M6 收尾,见 计划) |
| 通知与推送 | notify.py(通道可插拔)、logs.py(audit_notify) |
docs/modules/notify.md | 已写(2026-10-04) |
| 外部投喂转译层 | agentmemhub/feed/**(转换器注册表 + 三段物料)、cli.py(feed 子命令)、mcp_server.py(feed_add/feed_list/feed_status) |
docs/modules/feed.md | 常用文档已适配:md/txt · 网页(含本地另存)· 公众号 · PDF · DOCX · PPTX · XLSX · XMIND · CSV/TSV;MCP 三个投喂工具与通知已接(M5 ✅);面板投喂视图已落地(清单/四形态投喂/扫描批量/重转/撤下/删除/体检/格式白名单,2026-10-22);剩 T4 图片 OCR(见 计划) |
| 记忆引擎(内置 rag) | agentmemhub/rag/** |
docs/modules/memory-engine.md | 已写(2026-10-23) |
| 面板后端网关 | agentmemhub/web/**、mdmini.py |
docs/modules/panel.md | 已写(2026-10-23) |
| 采集与适配 | agentmemhub/adapters/**、store.py、models.py、watermarks.py |
docs/modules/ingest-adapters.md | 已写(2026-10-23) |
| 蒸馏与 LLM 接入 | distill.py、scoring.py、llm.py、export.py |
docs/modules/distill-llm.md | 已写(2026-10-23) |
| 三层对外入口 | mcp_server.py、cli.py、console.py、health.py |
docs/modules/interfaces.md | 已写(2026-10-23) |
需求
- Python 3.10+(推荐用 uv 管理:
uv sync即可装齐依赖) - 核心依赖:
onnxruntime(嵌入推理)、tokenizers、numpy、sqlite-vec(向量检索)、pyyaml(配置)、zstandard(DSH 数据源解压) - Web 面板另需:
fastapi、uvicorn(uv sync --extra web) - 内存/磁盘:嵌入模型 23MB 起(自带 bge-small);索引库随会话量增长 (约 18k 记忆单元 ≈ 150MB,含向量)
Web 页面(可选)
不想敲命令行?启动本地 Web 仪表盘,在浏览器里浏览/搜索/管理所有 Agent 会话:
# 首次:安装 web 可选依赖(fastapi + uvicorn)
uv pip install -e ".[web]"

# 启动(默认 http://127.0.0.1:8086,--open 自动打开浏览器)
uv run python -m agentmemhub serve
uv run python -m agentmemhub serve --port 9000 --no-open --db D:/path/to/agentmemhub.db
功能:四标签页——「统一会话」「记忆报表」「wiki知识库」「设置」分开呈现,互不混排。
统一会话页:Agent/工作空间多选筛选 · 服务端分页列表 · 全文搜索(FTS5+LIKE)· 统计卡与图表 ·
会话详情抽屉(用户消息/思维链/工具调用/代码补丁 全渲染,按记忆轮次分组)· 标题编辑与会话删除(真实写库)。
每行「🧠 查看该会话记忆」直达记忆报表并自动筛选该会话;标题修改与删除不会被后续 ingest 覆盖
(全局递增 session_uid + 用户修改保护 + 删除墓碑)。
记忆报表页:展示目前存放的全部记忆(蒸馏终稿 ∪ Agent 手动写入,每条带来源会话与轮次锚)。
- 状态下拉(默认「活跃」= 新型+相似,可勾选已合并/重复)+ 来源下拉(含 MCP 写入项, 与采集来源同列多选,全选/全不选)+ 类型/置信 chips + 关键字 即时生效
- 表头点击排序:类型 / 置信 / 状态 / 来源 / 来源会话 / 时间 / 分数,升降序切换; 置信按「高→低」、状态按「新型→重复」的语义序(非字典序);「来源会话」按采集库 标题排(跨库 ATTACH 只读,失败自动降级回时间序)。分页 20/50/100,带首页 / 末页跳转
- 点击任意行展开全文与溯源(类型/主题/置信/状态/来源/蒸馏模型/召回单元/会话UID/轮次锚), 可一键跳回原始会话并定位到该轮
- 每行 ⭐ 手动加权(两态:加权 1.0 ↔ 取消;锁定后不衰减)+
👍/👎 状态式反馈(当前态高亮,再点同极性即取消、干净回退来源初始分)。
两种操作都为就地更新(不重拉列表、不丢滚动与筛选位置)且带防连点。
反馈语义与 MCP
memory_score的"历史累加"分开:面板是当前表态(一 unit 一条), 累加均值会越点越钝、且无法取消,不适合人工按钮 - 记忆库健康卡片:把"是否正常"变成可断言的不变量——
units.updated_at覆盖率、 蒸馏投影一致性(投影数须等于有投影的活跃记忆数)、FTS 与向量索引一致性。 异常时列出可执行的处置建议,并提供一键「回收滞留投影」(幂等,与蒸馏流程 自动执行的是同一个函数)。同一套判据也能从命令行跑:scripts/health_check.py(退出码 0/1,可挂 CI)。 - 来源列区分
MCP(Agent 主动写入的原子记忆,无原始会话、会话列不可点)与采集来源; 每行标注「召回单元」与「有无原始会话」,避免误点失效链接 - 语义检索框(向量+全文混合评分召回,结果可点开原始会话)
- 记忆时间线(2026-10-23):表头的「时间线」按钮弹出明细层,按天分组倒序展示原始轨迹 (用户输入 / Agent 输出摘要 + 分值 + 轮次锚),滚到底自动加载下一页; 适合回答"最近到底记了什么"(报表是蒸馏后的终稿,时间线是原始输入,两者口径不同)
- 「记忆操作」工具栏:提取会话入库 → 清洗数据 → 蒸馏记忆 → 写入记忆, (自动评分按钮已隐藏——蒸馏置信度 + 👍/👎 已覆盖质量把关) 全部为后台任务;全局进度条(两页可见,按百分比分级配色、结果实时回显、同一时刻只允许一个任务)
记忆排除(会话级/轮次级「不写入记忆」)的后端能力保留(
memory_exclusions表、/api/*/memory-exclusion、CLI/MCP 均可用),面板 UI 自 P3 起下线——会话列表只做查看/删除/改标题。
wiki知识库页(2026-10-18 新增):展示页面产物 —— L2 蒸馏知识库 + 外部投喂交付物。 它与「统一会话」零耦合(页面不是会话),后期会话页降级或隐藏都不影响它。
- 左栏 = 域列表(22 个域 + 每域页数;来源用
origin区分蒸馏 / 投喂) - 右栏 = 页面列表(标题 · 域 · 类型 · 来源 · 编译时间),点标题即在右栏内打开渲染后的正文
- 顶部:来源切换(全部 / 蒸馏 L2 / 外部投喂)· 标题搜索 · 分页
- 数据以磁盘为准(不查投影表):投影(
index-pages)是运维动作、会滞后 —— 两者行数从不保证相等(曾实测磁盘 424 页 / 投影 399 行);面板要看的是 知识库本身,"能否被召回"是另一件事 - 正文渲染走
agentmemhub/mdmini.py(先转义再套结构:内容里的<script>只会显示成文本, 链接只放行 http/https) - 溯源可点(2026-10-23):正文里的
[m3236]就是distilled_memories.id,渲染成可点徽章; 点开是速览浮层(正文 / 类型 / 置信 / 来源会话 / 轮次锚 / 去重链),可一键跳到记忆报表或 原始会话。采集库已无该会话时不给回跳按钮(给了就是死链)
运维(同一页的二级视图,2026-10-18):浏览 / 运维 / 投喂 三态切换,运维页六块 ——
- 健康概览:两级一致性(
l1_ahead时直接提示更新)、覆盖率、死链、待更新/失败计数、 触发器状态;卡住的更新锁会单独告警(in_progress长期不变 ⇒ 上轮异常退出, 并给出处置路径) - 待更新记忆:明细(id / 类型 / 来源 / 置信 / 摘要)+ 勾选后软删除 (不进 wiki、仍可被召回)或硬删除(真删,二次确认)+ 「已忽略」视图与恢复
- 编译失败:清单(stage / target / kind / attempts / error)+ 定向补跑(只跑失败的)
- 触发器规则:启用 / 时点 / 脏记忆阈值 / 每日首次 —— 写运行时覆盖,不改 yaml
- 离线批处理:在飞状态 + 推进一段 / 取消 / 重提 + 检测流水
- 快照与回滚(2026-10-23):现有快照列表(时间 / 原因 / 大小)· 立即快照 · 分范围回滚(全部 / 只 wiki 产物 / 只数据库;回滚前自动存保护快照)。超过保留上限时自动删最旧
⚠️ 运维页里的长任务(增量更新 / 补跑 / 批次推进)复用全局进度条(/api/admin/job),
任务结束后自动刷新本页;所有有副作用的动作都走二次确认。
投喂视图(2026-10-22):素材登记层的写入与管理。它与「浏览」是两层东西 —— 浏览看"转换后的知识页",投喂看"转换前的素材",混在一起就分不清"页面有问题"还是"源有问题"。
- 清单(状态 / 格式 / 质量 / 告警,可只看低质量)+ 详情(三段路径 / 转换器 / 失败原因)
- 四形态投喂:本地路径 / 网页链接 / 上传文件(可多选)/ 直接正文
- 扫目录批量:先
scan只读预览(可投喂 N / 被格式挡掉 M + 按后缀分布 + 被挡原因), 人确认后再跑 - 素材级操作:重转 / 撤下(
retract)/ 删除(可勾选purge连原件一起删) - 体检(P0/P1 分级)与格式白名单热改
- ⚠️ 面板可以删素材,MCP 侧仍然不给删除 —— 那是给 Agent 的接口约束(只给写入与查看), 人工勾选 + 二次确认是另一回事,别拿 MCP 的约束去砍面板的能力
设置页(2026-10-23):agentmemhub.yaml 的只读视图 —— 按模块分组、带原注释、可搜索,
并标出哪些键正被环境变量覆盖(AGENTMEMHUB_CONFIG 等)。
- 数据源是
agentmemhub/config_doc.py(行扫描,不是yaml.safe_load):保留每个键自己的注释,value_raw保留 yaml 原文('8000'的引号、[...]行内列表都不改写) - 只读是刻意的:
PUT /api/config不存在,也没有任何代码路径会把配置写回 yaml, 所以中文注释不可能被程序冲掉。真要做"面板改配置",正确做法是"按行号文本级定点替换", 而不是把配置拆成config/多个文件(成本与收益对比见docs/modules/config.md§8)
设计要点:
- 大库友好:事件流不预载——只有点开某条会话的抽屉时才从后端按需加载该会话的事件; 超长会话自动截断(前 88 + 后 12 条)并标注;统计聚合下推 SQL 且带 TTL 缓存
- 离线可用:Tailwind / lucide / Chart.js 已本地化到
agentmemhub/web/static/vendor/ - 只绑定 127.0.0.1,不上传任何数据;Swagger 文档在
/api/docs - 前端由
WebsiteDesign设计稿改造而来,接口契约见docs/与/api/docs
隐私与脱敏
本项目本地运行、不上传任何数据。推送到公开仓库的部分严格脱敏:
- 代码用
Path.home()/ 环境变量在运行时发现路径,不硬编码真实用户名或绝对路径 - 敏感配置用示例文件给出:
.env.example(环境变量占位)、scripts/sensitive_scan.py(敏感扫描) - 真实会话导出默认为
exports/(已在.gitignore,勿强制推送) - 详细规则见 SECURITY.md
Roadmap
- 统一事件模型 + SQLite 存储(FTS5)
- 8 个 Agent Adapter(含 src_id/turn_key 稳定锚与系统注入识别)
- Trae 适配器(最小可用:会话清单 + 每轮快照 diff + 项目记忆;对话正文等官方开放接口)
- 全量检索 + JSONL/Markdown 导出
- MemOS bundle 桥接(v2.0 起退役;v2.8 起代码与配置全部移除)
- Web 仪表盘(FastAPI + 原生 JS,服务端分页、事件按需加载、真删改)
- 交互式控制台入口(start.bat / 无参数菜单)
- 记忆引擎一体化管理(MemOS 平移)(v2.0 起改为内置引擎;v2.8 移除上游)
- 统一配置体系(agentmemhub.yaml:全路径可配置)
- MCP 记忆网关(stdio / Streamable HTTP 双传输,供 ZCode/OpenCode 等 harness 检索/写入记忆)
- 记忆清洗(clean:删除系统注入事件,预览→执行并重建 FTS/计数)
- LLM 批量自动评分(score:三轴评估写价值分——入口已隐藏:实测多为 neutral/全跳过,质量把关改由蒸馏置信度 + 面板 👍/👎 承担;命令保留备查)
- 统一日志(
<程序根>/logs/:web/cli/mcp/engine/tasks 分文件,面板可查历史;mcp.log为 MCP 调用审计) - MCP 写后即评(memory_score 工具 + save-memory Skill 独立仓:触发纪律/生效前提/逻辑归属)
- 导入数据质量(meta 幽灵轮剔除、纯工具轮标题兜底、恢复环境整源丢失修复)
- 增量同步架构(会话级清单对比 → upsert → watermarks 变更集贯通 clean/push;评分增量优先·定点读零全量枚举;cap 超限回退全量;默认数据目录收进项目内 database/)
v2.0(2026-09-10)记忆引擎自研内核
- 内置记忆引擎
agentmemhub.rag(向量化 / 六路通道融合召回 / 价值评分,进程内直调、无独立服务) - 引擎接缝
rag_bridge:原 MemOS 端点语义的进程内实现,MCP 五工具与面板契约零改动 - 一行配置回退 MemOS(v2.8 已移除:不可能再回退,见模块文档)
- 存量零丢失迁移(MemOS 2286 traces / 3836 feedback → 新索引)
- 记忆写入控制:会话级 + 轮次级排除(后端能力保留;面板 UI 自 P3 起下线,改用双标签页报表)
- 面板改造为「AgentMemHub 记忆面板」:双标签页(统一会话 / 记忆报表)、记忆报表(筛选·展开溯源·⭐加权·反馈·语义检索)、会话↔记忆双向跳转、标题修改与删除防 ingest 覆盖
- 批量嵌入性能优化:按文本长度分桶(bge-base 5.26 → 26 条/秒,全量 51 → 11.6 分钟)
- 多模型写入编排:小模型先跑完即可检索,高精度模型后台子进程并发补齐
- 统一配置
agentmemhub.yaml(模型注册/分桶/召回/写入策略/后端开关单文件) - 记忆蒸馏(离线,四入口:Python/CLI/start.bat 控制台/面板):S0 窗口化切片 → S1 段级蒸馏 → S2 同会话合并 → S3 跨会话去重 → S4 投影为可召回 unit;幂等增量、脱敏、失败可重跑
- 权重体系:来源初始分 → 反馈演化(状态式可撤销)→ 手动加权(⭐ 两态锁定不衰减,有界 boost)
- MCP 调用审计:每次调用(记忆:save / search / recent / stats / score;投喂:feed_add / feed_list / feed_status)由服务端在唯一分发点自动留痕到
logs/mcp.log(每次两条call/result+call_id,含参数摘要、耗时、成败),不依赖 Agent 记得写;Agent 可用可选参数note补充意图(为什么);查询走scripts/mcp_log.py - 带标签的版本锚点(
v0-pre-rag回滚点 /v1-rag-backend-only/ v2.0)
v2.1(2026-09-18)LLM Wiki 两级编译 + 调用兜底
LLM Wiki(碎片 → 可读知识库):在 RAG 之外增加一条派生路径——把已沉淀的 蒸馏记忆编译成结构化、互相链接、人和 Agent 都能直接读的 markdown 页面。 RAG 优化「能不能捞到」,wiki 优化「有没有结构」;wiki 不会反向改写记忆。
- 第一级
scripts/wiki_compile.py:逐会话把零散记忆归纳成页面(先分组再编译,两段式) - 第二级
scripts/wiki_aggregate.py:跨会话按主题聚合成实体页(归域 → 域内细分 → 重新编译) -
scripts/wiki_linkfix.py:按「被合并页 → 合并后页」重定向,死链 92.6% → 0% - 溯源提升:正文引用从会话内序号
[n]提升为全局记忆号[m<id>],可直接追回distilled_memories - 实测:223 会话 / 1562 条记忆 → 第一级 660 页 → 第二级 20 域 / 233 页(压缩比 2.8:1)
调用兜底(长任务可运维性):
- 长任务日志
logs/wiki.log:每次 LLM 调用(阶段/目标/重试/耗时/token 增量)、 每会话与每页成败、运行汇总——跑几十分钟的任务必须能从日志回答 "跑到哪了、哪些失败了、花了多少、上次断在哪" - 失败清单
agentmemhub/failures.py:JSONL 落盘、跨次累积、按原因分类;quota/auth/model三类醒目提示"重试与继续跑都无意义" - 补跑服务接口(
agentmemhub/wiki.py)——补跑不能只靠人敲脚本: CLIpython -m agentmemhub wiki --action failures|retry、 HTTPGET /api/wiki/failures+POST /api/wiki/retry(后台任务)、 以及 Pythonwiki.retry_failed() / retry_all();CLI 与面板共用同一份实现 - 格式修复模型(
llm.repair_model):主模型返回了内容但 JSON 解析失败时, 把原始输出交给 JSON 遵从性更好的模型转格式——救回被截断的内容, 而不是丢弃或退化成拼接 - 记忆内容硬截断:
CONTENT_MAX=120从"提示词软约束"改为代码级兜底 (实测没有任何模型稳定遵守,超标率 38–53%)
成本优化:
- LLM 接入切换为
xiaomi/mimo-v2.5(实测思维链仅 24–37%, 算上推理 token 的真实成本约为 deepseek 的一半) - 2026-09-22 随上游上架切换到
xiaomi/mimo-v2.6-flash(价格与 V2.5 持平, 同价优先新模型;ID 经实测探测确认,mimo-v2.6/mimo-v2.5-flash均不支持) -
thinking/reasoning_effort开关 + 用量与成本统计(usage_snapshot/estimate_cost) - 两级 wiki 各自相对顶层
llm覆盖,互不牵连 (级联会让第一级换 provider 时连带改掉第二级,已实测踩过)
v2.2(2026-09-20)Wiki 页面进召回面 + 召回调优
页面层进召回面:L2 知识页整页投影为 wiki_<crc32> 单元,走页面专属两条
通道(子集向量 + 子集全文),与消息层/记忆层同池融合——知识库与记忆本质是
同一种数据,一次检索同时拿到"聚合答案"(page)与"具体结论"(memory)。
- 页面层投影(
agentmemhub/wiki_index.py:全量对齐、幂等收敛) - 召回结果带层级与来源标注(
kind= page/memory/message ×origin= native/external) - 页面准入策略:高分优先 + 低分字面兜底 + 席位。三轮实测迭代——
"分数不能当门槛" → "证据也不能当门槛" → "证据等级绝对优先仍不行",
每次都靠真实查询证伪(详见
docs/data-architecture.md§4.2) - 召回严格度档位
rag.retrieval.recall_level(1 最严格 … 5 最宽松,默认 3): 把候选宽度 / 相对阈值 / 终审阈值 / 页面席位收成一条单调刻度,带单调性测试守卫 - 短语精确匹配通道:
command code、api key这类多词英文专名—— 此前 12 个含 "Command Code" 的单元有 11 个连候选池都进不去(§4.4) - 两处链路级修复:页面豁免通用相对阈值;页面保位用替换而非追加 (否则会被下游"取前 N 条"截断切掉,§4.0)
- 快照保留份数配置化(
snapshot.keep,默认 5,非法值回退默认)+ 补一份全量统一版本快照 - 文档:新增
docs/data-architecture.md(架构全景·权威)、docs/model-selection.md(模型选型与定价);六路通道表述同步进 README / ARCHITECTURE / API
v2.3(2026-09-21)可观测性:三个事实流
按视角拆日志——"这条记忆到底写进去没有""这次 wiki 为什么跑 / 为什么没跑" 此前只能靠翻库和反推代码:
-
logs/mcp.log协议层:谁调了什么工具、参数、耗时、成败(服务端唯一分发点自动写) -
logs/memory.log数据层:哪条记忆被写/读、内容全文、来自mcp/http/distill/cli哪条路径 -
logs/wiki.log流水线层:编译跑到哪、花了多少、断在哪;新增触发判定留痕 (trigger_check记下should_run/reasons/dirty) - 日志滚动与归档由
logs配置段统一控制:全局默认 + 单文件覆盖(空则回落); 滚动规则二选一(max_mb > 0按大小优先,否则按自然日首次写入); 归档进logs/archive/<日志名>/,keep_days默认 30 - 写入点一律"建目录 + 追加打开":手工删掉日志文件甚至整个
logs/也能自动重建续记 - 同日暴露并修复 wiki 静默落后于记忆却一直显示健康(三处叠加缺陷 + 一个观测盲区 +
一个配置漏配,详见 v2.4 与
docs/llm-wiki.md)
v2.4(2026-09-22)编译可靠性 + 待更新记忆可运维
把"能跑"钉死成"跑得住、失败也不骗人":
- 组级并发(
wiki.page_workers,默认 3)+ 结果按组序重排(完成顺序不确定, 直接 append 会让页序漂移、产物不可复现);实测 32 组约 48 分钟 → 约 12 分钟 - 分组分批(
wiki.plan_batch_max,默认 40):分组是"输出规模随输入线性增长"的调用 - 429 进程级共享闸门:撞限就推后"下次允许发请求的时间",所有线程一起等
(避免多 worker 各自退避造成的"退避共振")+ 尊重
Retry-After(上限 300s) -
HTTPException纳入瞬态重试:IncompleteRead/RemoteDisconnected继承自它 而非OSError,旧捕获会漏掉 → "切网丢一组、一次都不重试" - 组级失败剔除新基线:单组失败不影响整会话(对),但会话仍算成功 → 那几组记忆照样进新基线、被永久掩盖(实测 23 组失败 3 组、20 条记忆差点静默丢弃)
- 跨进程单飞行锁(
O_CREAT|O_EXCL原子创建 + PID/时间戳 + 陈旧抢占):threading.Lock只管进程内、msvcrt.locking跨进程无效、不依赖psutil - 计时双口径:墙钟
seconds+ 累计调用耗时call_seconds(机器休眠会把墙钟撑大,实测一次 L2 显示 9.2 小时而实际约 1 小时) - 待更新记忆的查看与删除:
wiki --action pending|ignored|drop|restore(HTTP 同步四路由)。软删除 = 打wiki_ignore_at,记忆仍可召回、只是不进 wiki、 可恢复、不触发重编;硬删除 = 真删(蒸馏行 + 投影 + 向量)需confirm, 删完重建 manifest。边界:只处理尚未进 wiki 的记忆(删除不产生死链), 已进 wiki 的删除属docs/memory-deletion.md范畴,drop()会拒绝 - 主模型切换
xiaomi/mimo-v2.6-flash(同价优先新模型,V2.5 留作回退位)
v2.5(2026-10-15 ~ 10-22)外部文档投喂
知识来源从"对话"扩到"文档":
- 素材登记层(
materials.db)+ 三段物料(原件快照 / 转换后正文 / 发布页), 与自有 wiki 并列而非从属:不参与蒸馏、不参与 L1/L2 编译,产物落旁路根out_feed/ - 格式覆盖:md/txt · 网页(含本地另存)· 公众号 · PDF · DOCX · PPTX · XLSX · XMIND · CSV/TSV(表格转 markdown 有行列/单元格上限,超限截断并标注)
- 11 个 HTTP 接口 + 3 个 MCP 工具(
feed_add/feed_list/feed_status)—— MCP 只给写入与查看、不给删除(无人值守约束);面板人工勾选 + 二次确认,可以删 - 幂等(内容哈希判重,重复投喂答"已投喂过")+ 后缀白名单热改
- 面板投喂视图:清单 / 四形态投喂(路径·链接·上传·正文)/ 扫描批量(先只读预览)/ 重转·撤下·删除 / 体检(P0/P1)/ 白名单
v2.6(2026-10-18 ~ 10-23)面板 UI 统一重做
把"后端做完了但没入口"补齐(62 个路由只调了 18 个 → 64 个路由调了 53 个):
- 四标签页:「统一会话」/「记忆报表」/「wiki知识库」/「设置」,各管一层、互不混排
- 知识库三子视图:浏览(磁盘为准、不查投影)/ 运维(健康·待更新·失败补跑· 触发器热改·离线批次·快照回滚六块)/ 投喂
- 记忆溯源可点:正文里的
[m3236]即distilled_memories.id,点开浮层看 类型/置信/来源会话/去重链(GET /api/memories/{mid}),可一跳报表、一跳原始会话 (采集库已无该会话时不给回跳按钮,避免死链) - 记忆时间线:按天分组的原始输入轨迹,与报表的"蒸馏终稿"口径分开
- 设置页(只读):
config_doc.py行扫描保留每个键的原注释 + 与agentmemhub.yaml.example做键集体检(缺失/多余/取值不同);刻意不提供写接口 - 守护:
scripts/audit_frontend_api.py(路由↔前端对账)、tests/test_web_layout.py(四个视图容器必须挂在#app之内—— div 数量平衡 ≠ 嵌套正确,设置页整片空白就是这么来的)
v2.7(2026-10-23)wiki 增量:从「整会话重编」到「页级重编」
让"12 条新记忆"不再等于"重编 270 页" —— 这一轮修的是放大倍数,不是功能:
- 直写记忆按日分桶:
mcp/direct原本是唯一的巨型虚拟会话 —— Agent 经 MCP 直写的记忆全部落在同一个conversation_id上(当时 210 条记忆 / 84 个 L1 页), 任何一条新增都会把整会话判脏。改为按天分桶(distillation.direct_bucket: daily), 脏单位自然降到"新增那一段";none可退回旧行为 - L2 页级重编:每页 json 的
from_files记录了它由哪些 L1 页合成,增量时只重算 受影响页、其余页原样保留(合并写盘、空闲序号、崩塌判据都按范围算)。 实测 12 条新记忆的 L2 重编范围从 270 页降到 4 页 - 页面投影只重算变化页:
project_pages()原先把整库(当时 626 页)重新 encode 并全量 UPDATE —— 每轮固定 188 秒;改为「新页 / 内容或元数据变 / 向量缺失」三判据后 188 秒 → 0.4 秒(元数据必须一起比:doc_id变而正文没变时也要更新,否则溯源链断) - LLM 调用加总时长上限:
wiki.l2.llm.max_total_seconds(默认 600)。socket 超时 管不住"一直有数据在来、但整体极慢"的调用(实测有一条 975 秒才返回、且ok=True、attempt=1);改用工作线程 +join(上限)硬收口(Windows 上socket.shutdown()中断不了阻塞中的recv,实测无效)。同时消除call_json(tries=3)×complete_json(max_retries=2)的重试叠乘(最坏 9 次) - 陈旧「更新进行中」判为异常退出:
update_started_at只是面板展示标记、不是锁; 真正的互斥是logs/wiki_update.lock文件锁(O_CREAT|O_EXCL,3 小时自动过期) —— 早先把它当成锁告警过一次,是假告警 - 日志与进度口径:
pages报「本轮编译页数」而非「域总页数」(否则会以为编了 200 页 实际只编了 2 页);面板进度条接上[N/M]百分比,并把细分/域规划/LLM 调用事件一并转出
v2.8(2026-10-24)彻底移除 MemOS 上游依赖
让"上游"这个词从项目里消失 —— 不是换个依赖,是把四层不同的东西一层层剥掉:
- 物理实体:
memOS/vendored 目录(931.6 MB / 10856 文件,一直靠.gitignore挡在库外) - 代码链路:
agentmemhub/memos.py整个删除;rag_bridge.import_bundle换成单条写入口save_memory_trace();MCPmemory_save不再走 HTTP 推送, 改为进程内直写 —— 顺带消掉「写在另一个库、再靠侧车对齐」那条路径 - 配置面:
memory.backend/memos.*全部删除,没有回退开关;/api/engine/*保留但语义改为"内置引擎运行时状态"(memos_daemon→engine_api) - 语义锚不动:
source='memory'+conversation_id='mcp'这一对历史锚保留 —— 它在索引库里标记"Agent 直写"的行,与 MemOS 无关;改名要迁移历史数据,不值
判据:git grep -i memos 只剩 engine_api.py 头部的来历说明与台账文档里的历史叙述。
- 更多 Agent(Claude Code / Cursor / Gemini CLI / CodeBuddy)
- 记忆折叠压缩(超长会话压缩、相邻轮折叠)
- 存储扩展(单库增长的按 source 分片/归档;data_root 已参数化,见 watermarks 扩展点设计)
No comments yet. Be the first to write one.