OpenDesign Go for DSH
在 DSH 里使用 OpenDesign 订阅的模型(Go 为 14 个,Plus / Pro / Max 更多):推理走 OpenAI 风格的 chat/completions 或 responses,额度、用量和多账号都在设置页里。
关于作者
交易员,业余写工具。这个插件起源于我自己拿 DeepSeek 做量化策略研究和复盘时的需要。
| 平台 | 地址 |
|---|---|
| 知乎 | 勇者别嚣张 |
| YouTube | @valortrader |
| B站 | 勇者别嚣张的交易室 |
| 微信公众号 | 勇者别嚣张的交易室 |
功能
| 功能 | 说明 |
|---|---|
| 接入 Go 套餐 | 注册一个 dsh-opendesign-go provider,提供 Design Plan 的 14 个模型 |
| 三条接口协议 | 同一网关的 chat/completions、responses 与 Anthropic messages 可切换,默认第一条;Responses 只返回被改写的思考摘要 |
| 一键更新 | 设置页直接调插件的更新通道:主路径走 npm registry,另有「从 GitHub 装」作为兜底 |
| 用量统计 | 记录每次经本插件发出的请求,按模型汇总输入/输出/缓存 token,并按各厂商公开单价估算成本 |
| 额度读取 | 勾选后调用本机 OpenDesign 桌面端自带的 vela 命令行,读取真实的 5 小时 / 7 天额度窗口 |
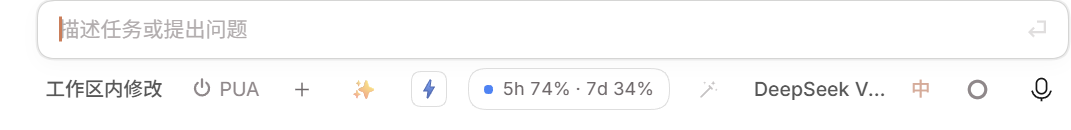
| 输入框额度条 | 选中本插件的模型时,会话输入框旁出现一枚胶囊,显示 5 小时与 7 天的剩余百分比,点开可看倒计时、钱包余额与刷新 |
| 多账号 | 每个账号对应一份独立的 OpenDesign 订阅,每份一把 API Key;可开启失败自动切换 |
| 每模型参数 | 为单个模型覆盖上下文窗口与 max_tokens 上限 |
| 模型开关 | 取消勾选的模型不出现在会话的模型选择器里 |
| 图片输入 | 声明了 image 模态的模型可以接收图片;文本模型收到的是占位文本 |
| 图片缩放 | 每张图按路由声明的尺寸与字节上限生成请求版本(2048² / 1 MiB),不再按上传原图重发;超预算按宿主的 IMAGE_OFFLOAD_REQUIRED 契约降级重试,而不是撞 413 |
| 生图模型 | 网关目录里的生图模型(gpt-image-2、seedream-5.0 等)由 opendesign_generate_image 工具调用,走 /images/generations,图片从工具结果回到会话;它们不出现在会话模型选择器里,因为生图没有文本可流式返回 |
| 工具读图 | read_image 读到的图片会随请求发给模型,不只回一段路径文本 |
所有用量数字都标注了口径。金额按官方公开价目表的基础档估算,超出阶梯阈值的长上下文请求会被低估;这不是账单,实际扣费以 OpenDesign 控制台为准。
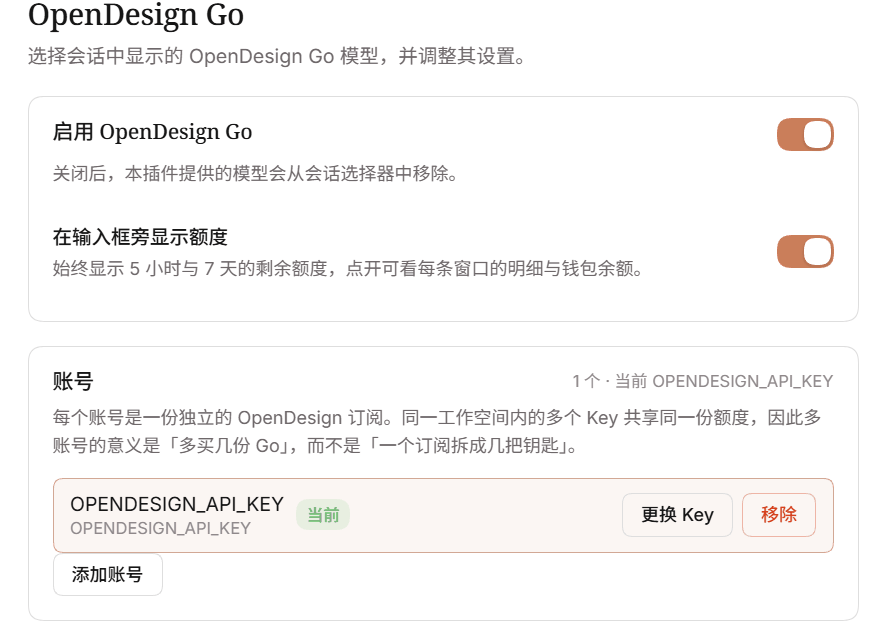
多账号的要点:每个账号对应一份独立的订阅。同一工作空间内的多把 Key 共享同一份额度,所以多账号的意义是「多买几份 Go」,不是把一份订阅拆成多把钥匙。
适配与验证
下面这些结论都有对应的实测记录,不是「按文档应该能跑」。
| 项 | 结论 | 验证方式 |
|---|---|---|
| 宿主版本 | 0.2.0-rc.1、0.2.0-rc.2、0.2.1-rc.2 三版全部通过 |
npm run test:hosts,每版在临时目录装齐 12 个 peer,再查符号 / 类型 / 挂载三层 |
| 网关上下文 | 真实窗口 1,048,576 token,未缩容 | 二分探测:喂 1,036,038 token 返 200,1,053,038 返 400 |
| 图片输入 | 声明 image 的 12 个模型全部能收图并正确识别 |
逐模型发同一张纯色 PNG,直连与经中间件两条链路各跑一遍 |
| 三条协议 | chat/completions、responses、Anthropic messages 都能流式、带工具、带图;思考内容只有 Responses 是被改写的摘要 |
同一批 prompt 各跑一遍,逐事件比对形状与 reasoning_tokens;Anthropic 另验 x-api-key/anthropic-version 头与 thinking 开关 |
| 参数表 | 14 个模型的窗口与输出上限逐条对应厂商文档;deepseek-v4.1-flash-eco 与 minimax-m3.1-flash 的输出上限无厂商文档,依据实测 |
出处逐条列在 docs/models.md |
| 额度口径 | credits 与美元 10,000 : 1;5 小时 50,000、7 天 150,000 | 两个窗口独立折算互证,与 vela 输出一致;另用 DeepSeek 调用的 credit 增量五次复核,落在 10,067–11,880 |
| 工具侧图片 | 图片改由紧随其后的 user 消息承载,直连与经中间件都到达模型 |
同一条工具结果在两种链路下逐模型比对 |
| 输入框槽位 | 三版宿主都提供 conversation.input.right(list 型、session 作用域) |
逐版解包 dsh-client-ui-conversation 的 slots.d.ts 核对 |
宿主兼容矩阵的三层是递进的,缺一层就会漏掉一类故障:符号抓导出被改名或删除(导入本身不报错,要到首次调用才炸),类型抓符号还在但签名漂移,挂载才是真实 Cordis 运行时接不接受入口。反向验证也做过——向产物注入不存在的导出会报 thisExportDoesNotExist,向源码写类型错误会报 TS2322,不会永远通过。
CI 有五个作业:Windows 与 Ubuntu 各跑 Node 24 和 22.19,加一个独立的 hosts 作业,当前全绿。
近期修复的缺陷
这些是实际撞到并定位到根因的问题,逐条记在这里,因为它们的现象都容易让人得出错误结论。
| 版本 | 现象 | 真实原因 |
|---|---|---|
| 0.1.19 | 会话用久了必定 413,压缩也必定失败,换哪个模型都一样 | 请求体里的图片按原图字节每轮重发:实测一个会话 28 张图、41.30 MB 原始、base64 后 55.06 MB,涨到网关前面 nginx 的接受上限 |
| 0.1.19 | 生图模型在列表里,选中就报错 | 网关把对话模型和生图模型混在一个目录里只给 id,插件全当对话模型发 /chat/completions,而它们只吃 /images/generations;而且生图没有文本可流式返回,本来就无法作为对话的一轮 |
| 0.1.9 | 上下文只用了三成,请求却被判超长 | 网关按 输入 + max_tokens ≤ 窗口 判据,而插件每次把模型公布的最大输出(384,000)原样发上去;宿主只量输入,不扣输出预留量 |
| 0.1.8 | 工具读到的图片,模型说「看不到」 | 请求链路上的中间件按常见形状重建 tool 消息,把 content 拍平成字符串,image_url 部件被静默丢弃 |
| 0.1.7 | 同上,模型说「看不到图片」 | 我们自己处理 tool 角色时把图片解析器传成了 undefined,每张图被替换成占位文本 |
| 0.1.7 | 插件市场安装长时间等待甚至超时 | 每次调用都无条件 settings.update,宿主会锁住 profile 根目录并重写整份 composition 文档,随后重算插件树 |
| 0.1.6 | 所有模型都被判成不能识图 | 模态字段读错了表:宿主读的是 catalog.ts 的静态目录,而那张表只有 id 和 name |
| 0.1.5 | 历史回放在部分 Node 24 上重复计数 | 会话日志一个事件一帧,旧读法依赖「一次解码只返回第一帧」;部分构建会连带后面的帧 |
对应的修法:
- 图片请求缩放(0.1.19)。先按宿主定义的
imageRequestTarget声明本路由要的尺寸与字节上限,再用attachments.readImageRequest取缩放后的请求版本——和dsh-llm-deepseek、dsh-llm-pi-ai一样取 2048² / 1 MiB。实测那个会话的请求体从 55.06 MB 降到 30.48 MB,28 张里 11 张会变小,图片全都还在。缩放解决不了的再按IMAGE_OFFLOAD_REQUIRED契约交给dsh-compaction-image-offload:抛一个带offloadImages: N的错误,由宿主记image/offload事件后重试。不自己丢是因为没记录的投影会让会话日志与实际发送的内容不一致——日志说那轮带了图,模型其实没看到。预算 20 MiB / 60 张,按 8 MiB 与 20 张整块前进,避免每轮多丢一张把 prompt 缓存打断。只统计user与tool里的图:assistant里的图既不发送也不可 offload,算进来会要求一次永远无法完成的操作。 - 生图模型(0.1.19)。目录快照多记
imageIds标出哪些 id 是生图模型;它们由opendesign_generate_image工具调用,改走POST /images/generations,返回的 base64 经attachments.saveImage落成持久引用,作为工具结果回到会话。做成工具而不是贴进 assistant 消息,是因为三条都要求如此:官方两个适配器把 assistant 图片判UNSUPPORTED_CONTENT,宿主的 offload 只扫user/tool事件,而被计入预算却无法 offload 的图会让会话卡在修不好的状态里。工具结果三条都满足——模型看得到图,会话重了能 offload,画廊照常渲染。它们不出现在会话的模型选择器里(listModels过滤掉),因为生图没有文本可流式返回;设置页仍按目录列出它们,只是不再额外标注——行里没有上下文/输出参数和「改参数」按钮,这本身已经说明它不是对话模型。 - 输出预留(0.1.9)。报给宿主的窗口改成输入预算
窗口 − max(输出上限, 窗口/4),1M 窗口 + 384K 输出的模型报 750,000;真正发出的max_tokens按本次请求的实际输入钳制,输入占满时省略该字段。图片按每张 1,024 token 计——按 base64 长度算会高估三个数量级。工具声明也计入:本机真实工具集是 326 个声明、约 163K token,占窗口 15.6%。 - 工具侧图片(0.1.7 → 0.1.8)。先是让
tool消息也走图片解析器,之后发现tool角色承载非文本部件缺乏共识——Chat Completions 规范没有约定它,各家重建实现各行其是。现在tool消息只发文本,图片提取到紧随其后的user消息,并由一句(Image content from the preceding tool result.)标明来源。 - 配置写入(0.1.7)。写入前先读该 entry 当前的值,相等就直接返回;短路放在重试循环内部,每次重写前重新读,
revision围栏语义不变。写入失败不再死重试 12 次,只有SETTINGS_CONFLICT值得重试一次。加上 5 分钟节流,实测写入量从约 1814 + 1440 次/天降到各 288 次/天。 - 模态来源(0.1.6)。删掉
catalog.ts里那份会分叉的模态字段,会话选择器、参数解析、请求门控统一读MODEL_DEFAULTS。测试强制把 14 个模型分进「支持图片」与「仅文本」两组,并要求并集等于全集,漏写一个就失败。 - 帧解压(0.1.5)。改为按帧边界切片,一片一帧,与运行时是否连帧无关。本机的 zstd 不连帧、无法复现,所以把解码器做成可注入参数,测试用一个「会连帧」的模拟解码器验证。
示意图
会话输入框的额度条:选中本插件的模型时出现,显示 5 小时与 7 天的剩余百分比,按最差的那个窗口着色;点开是明细面板。
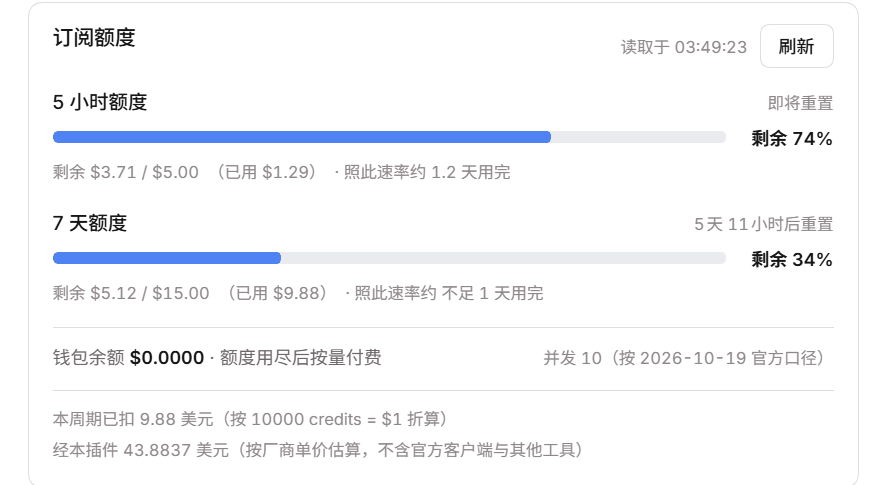
订阅额度卡片:5 小时与 7 天两个滚动窗口各自的剩余百分比、剩余金额、已用金额与外推天数,底部是钱包余额与本周期的两套对账口径:
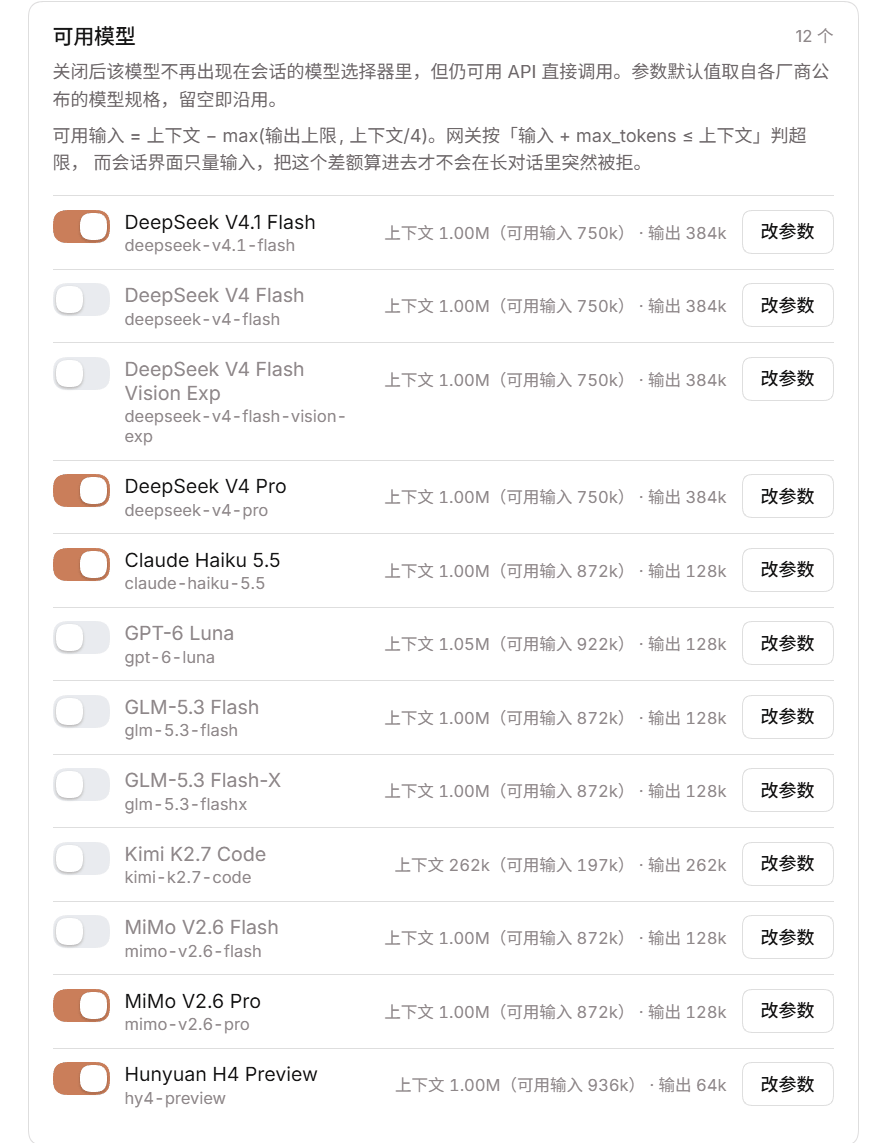
可用模型列表:关闭后该模型不再出现在会话的模型选择器里(仍可走 API),右侧「改参数」可逐项覆盖上下文窗口与输出上限:
安装
这是 DSH 插件,需要 DSH 桌面端 >= 0.2.0-rc.1(见 package.json 的 engines)。
从 npm 安装(推荐),在 DSH 桌面端的插件管理界面里填包名:
dsh-opendesign-go
装完重启桌面端,在设置里打开「OpenDesign Go」分区。
非桌面端 profile(例如 web)也可以用命令行:
dsh plugin --profile web add dsh-opendesign-go
升级到最新版:
npm install -g dsh-opendesign-go@latest
设置页里也有两个更新按钮(见更新),不用记命令。
为什么推荐 npm 而不是 GitHub
npm 包把构建产物和依赖版本一起锁定。GitHub 方式也能用(填 github:EliteOtaku/dsh-opendesign-go),但有两个代价:
- 依赖会更慢、更易受上游变动影响:GitHub 安装走 git 解析,拿到的是默认分支 HEAD,不是某个固定版本。
- npm v12 起 git 依赖默认不再解析。自 npm 12 起
--allow-git默认为none,除非显式允许,github:形式的依赖会被跳过。npm 包不涉及这条限制。
构建产物 lib/ 同时提交在仓库里,所以两条路径都不需要在本机构建。
桌面端的
desktopprofile 由 Electron 应用独占管理:依赖和dsh.profile.bundles条目是分开落地的,命令行dsh plugin add只写其中一部分,结果通常是一半安装(启动报cannot resolve profile bundle,或者插件静默不加载)。所以 desktop profile 请用插件管理界面,不要用命令行。
配置
配置写在插件自己的 profile 条目 opendesign-go 下,命名空间为 llm-opendesign-go。所有字段都是 volatile() 引用,改完即时生效,不需要重启。
设置页直接可改的是:启用开关、接口协议、输入框额度条开关、额度来源、账号列表(含每账号的 workspaceId)、模型开关、每模型参数、对账基准。其余字段(apiKeyEnv、baseURL、requestTimeoutMs、streamIdleTimeoutMs、autoSwitch、sessionRef、workspaceId、planOverrides、recoveredEnabled、recoveredProviders)目前需要编辑 profile 条目的 config 块。
| 配置项 | 默认值 | 用途 |
|---|---|---|
enabled |
true |
关闭后插件提供的模型从会话选择器中移除 |
protocol |
chat |
请求走哪条接口:chat 是 POST {baseURL}/chat/completions,responses 是 POST {baseURL}/responses。默认 chat,因为只有它返回模型自己的完整思维链 |
apiKeyEnv |
OPENDESIGN_API_KEY |
凭据引用名。插件按这个名字向 DSH 凭据服务(或启动环境变量)取 API Key,配置里不放密钥明文 |
accounts |
[] |
账号列表,每项含 id、name、apiKeyEnv、可选 workspaceId。第一项是当前账号,顺序即故障切换顺序;上限 20 个 |
autoSwitch |
false |
开启后,当前账号遇到凭据被拒或额度耗尽时按列表顺序尝试下一个账号 |
composerUsage |
true |
在会话输入框旁显示 5 小时 / 7 天额度条。只控制显示,关掉不影响读取 |
useVelaCredential |
false |
用本机 OpenDesign 桌面端的登录态读取额度,无需另填凭据 |
sessionRef |
'' |
使用控制台会话读取额度时的凭据引用名(OPENDESIGN_SESSION)。仅在不用 vela 且需要控制台通道时填写 |
workspaceId |
'' |
控制台通道的工作空间 ID;vela 通道会自动探测,一般留空 |
baseURL |
https://amr-link.open-design.ai/v1 |
推理网关基址。不能带查询串或片段,末尾斜杠会被去掉 |
requestTimeoutMs |
1800000 |
单次请求的总超时(30 分钟) |
streamIdleTimeoutMs |
300000 |
流式读取的空闲超时声明值。当前实现只用 requestTimeoutMs 判定超时 |
enabledModelsJson |
'' |
启用的模型 ID 数组(JSON 字符串)。空值表示全部启用 |
modelParamsJson |
'' |
每模型参数覆盖(JSON 字符串),形如 {"kimi-k2.7-code":{"contextWindow":262144,"maxTokens":131072}} |
planOverrides |
'' |
套餐额度覆盖,格式 go:150,plus:200。只改额度上限,不改月费 |
alignBaselineJson |
'' |
对账基准点(JSON),由设置页的「对齐当前周期」写入 |
recoveredEnabled |
false |
是否从本机会话日志补算未经本插件的 OpenDesign 调用 |
recoveredProviders |
'' |
补算时计入的 provider 名,逗号分隔;空值用 opendesign,dsh-opendesign-go |
另外四个字段 usageJson、reportJson、diagnosticsJson、updateJson 是插件写入的缓存与诊断信息,设置页只读,不建议手改。写回要抢 profile 的写锁,被拒时前两者留给下一轮轮询自愈,后两者(每个进程只写一次)按 3 秒 / 12 秒 / 30 秒退避重试三次。
完整的字段语义、取值约束和示例见 docs/configuration.md。
凭据
API Key 保存在 DSH 凭据服务里,设置页只显示引用名,不回显已保存的密钥。首次使用时有两种方式:
- 在设置页的「账号」卡片里添加账号,Key 由插件自动分配引用名(
OPENDESIGN_ACCOUNT_<n>); - 或在启动环境里设置
OPENDESIGN_API_KEY,用默认引用名。
额度读取
勾选「使用本机 OpenDesign 的登录凭证读取额度」后,插件会查找本机 OpenDesign 桌面端自带的 vela:
- Windows:
%LOCALAPPDATA%\Programs\Open Design\resources\open-design\bin\vela.exe - macOS:
/Applications/Open Design.app/Contents/Resources/open-design/bin/vela - Linux:
~/.local/share/open-design/bin/vela
也支持环境变量 OPENDESIGN_VELA_PATH 指定路径。查找顺序是:环境变量 → 官方安装目录 → PATH。官方安装目录优先于 PATH,因为只有它共享桌面端的登录态。
vela 是官方私有命令行,不是公开契约。插件会校验它输出的每个字段:格式变了就显示失败原因,不会给出一个看似正常的错误数字。
读到的额度不只出现在设置页:会话输入框旁还有一枚胶囊,显示 5h 62% · 7d 88%(就是上面 示意图 里那枚),点开是明细。它读的是宿主已经写进配置的那份读数,不额外发请求,所以不会让会话变慢。
胶囊只在这个插件的模型是当前选择时出现。别的 provider 花的是另一份额度,把自己的数字摆在别人的请求旁边会误导;同一个位置也可能被其他插件占用,不该并排显示两个互不相干的余额。
详见 docs/quota.md。
接口协议
同一个网关提供三条接口,设置页的「启用 OpenDesign Go」卡片里可以切换,默认 chat:
| 协议 | 端点 | 思考内容 |
|---|---|---|
| Chat Completions | POST {baseURL}/chat/completions |
reasoning_content 是模型自己的完整思维链 |
| Responses | POST {baseURL}/responses |
只有 summary,是被截断改写的摘要 |
| Anthropic Messages | POST {baseURL}/messages |
thinking_delta 是模型自己的完整思维链 |
三条走同一份额度、计价相同,区别只在线上形状。
Anthropic 的线格式与 OpenAI 不同,四处必须照做(都已实测,照官方 SDK 的默认行为写会撞墙):
- 鉴权是
x-api-key而不是Authorization: Bearer;缺少anthropic-version头直接 400。插件已把这两项固定进请求头。 - 参数是
thinking: {type:'disabled'}控制思考。reasoning_effort在这个面上完全无效——六档取值实测 thinking 长度都落在 1000–1700 字符的同一区间,而thinking: disabled真把思考块拿掉了。所以插件的映射是:思考等级选「关闭」→ 发disabled,其余档位 →enabled(该网关的budget_tokens只是陪衬,给 512 也能产出 1117 字符思考)。 max_tokens是必填。另两条协议省略它会让服务端自己挑,这条不行,所以窗口塞满时也仍会发一个下限值。- usage 口径不同:这里的
input_tokens不含缓存读,缓存另有cache_read_input_tokens。实测重复长 prompt:冷启动 2677,第二次 245 输入 + 2432 缓存读,两者相加正好等于冷启动值——这是「分开计数」的直接证据。OpenAI 那两个面是把它折进总和的,所以不能共用同一段换算。
关于「换 Anthropic 能绕开双段工具参数报错」这个说法:那个问题出在模型吐出的文本(一次工具调用里连出两段 {…}{…}),由宿主侧的严格 JSON 解析判定失败,与请求走哪条路径无关。插件这一层无法修它。但 Anthropic 面确实是社区反馈的规避路径,也是唯一能拿到原始思维链的备选,所以做成了可选协议;遇到就切过去试,别指望它必然不再犯。
三条实测结论决定了默认值:
- 计费与额度消耗相同,三条路径走的是同一个模型、同一份额度。
- 换到 Responses 会降级思考显示:
/responses的思考和文本一样是流式增量,但增量内容是对思维过程的改写摘要,不是原始思维链。插件把思考块渲染给用户,所以少掉这段是可见的质量损失。Anthropic 与 Chat 一样返回原始思维链。 - 省额度问题各面都一样:预算紧张时空回答的来源是思考 token 吃光
max_tokens,与协议无关(同一组英文 prompt,预算 24 时 chat 7/12 空、responses 9/12 空)。
真正需要 Responses 的场合是它的截断信号:它给 status: "incomplete" + incomplete_details.reason,而 Chat 只有 finish_reason。插件已经把两者都映射成同一个 max-tokens 停止原因。
Responses 那边有四处字段名不同,插件各自做了投影,不需要用户关心:工具声明是扁平的(无 function 包裹)、图片 part 是 {type:'input_image', image_url: <字符串>}、系统提示可以放进 instructions、输出上限字段叫 max_output_tokens。
更新
设置页在发现新版本时会显示一张更新卡片,两个按钮:
- 一键更新(主路径):走 npm registry,与桌面端插件管理界面同一条 Host 通道(
remote.pluginManager.updateBundle)。它会先做版本检查,失败时由 Host 自己把旧版装回来。 - 从 GitHub 装(兜底):从仓库标签安装(
github:EliteOtaku/dsh-opendesign-go#vX.Y.Z)。Host 不允许安装一个 profile 里已有的包名,所以这条路会先卸载再安装;本插件在安装失败时会把原版本装回去,并把结果如实写在卡片上。
两个按钮各自只在对应来源有更新时出现:npm 的发布与仓库的标签可能不同步(先打标签后发布是常态),少一个来源就少一个按钮,而不是给一个无版本可装的按钮。
失败原因直接显示在卡片上,最常见的两种:
- 版本刚发布,被 pnpm 拦下:
ERR_PNPM_MINIMUM_RELEASE_AGE_VIOLATION。pnpm 11 拒装发布不久的新版本,几小时后再点即可,或由管理员把该版本加进pnpm-workspace.yaml的白名单。 - 版本要求的 DSH 比当前运行版本高:插件管理界面里能看到具体缺哪一项要求。
restart-required 会明确写成「已装好 X,重启 DSH 后生效」——文件落地和运行中的宿主换掉模块是两件事,把它显示成「已更新」会让人以为已经在用新版。
非桌面端的 profile(例如 web)仍然只有命令行:
dsh plugin --profile web add dsh-opendesign-go@latest
模型
模型列表来自网关的 GET {baseURL}/models,该端点按账号额度等级返回:Go 拿到 14 个 Design Plan 模型,Plus / Pro / Max 拿到各自档位的额外模型。默认参数取自各厂商文档,可在设置页逐项覆盖;插件未收录的新模型使用通用默认值并标注「参数未收录」。
| 模型 | ID | 上下文 | 输出上限 | 图片输入 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | deepseek-v4.1-flash |
1,000,000 | 384,000 | 支持 |
| DeepSeek V4.1 Flash Eco | deepseek-v4.1-flash-eco |
1,000,000 | 384,000 | 支持 |
| DeepSeek V4 Flash | deepseek-v4-flash |
1,000,000 | 384,000 | 支持 |
| DeepSeek V4 Flash Vision Exp | deepseek-v4-flash-vision-exp |
1,000,000 | 384,000 | 支持 |
| DeepSeek V4 Pro | deepseek-v4-pro |
1,000,000 | 384,000 | — |
| Claude Haiku 5.5 | claude-haiku-5.5 |
1,000,000 | 128,000 | 支持 |
| GPT-6 Luna | gpt-6-luna |
1,050,000 | 128,000 | 支持 |
| GLM-5.3 Flash | glm-5.3-flash |
1,000,000 | 128,000 | 支持 |
| GLM-5.3 Flash-X | glm-5.3-flashx |
1,000,000 | 128,000 | 支持 |
| Kimi K2.7 Code | kimi-k2.7-code |
262,144 | 262,144 | 支持 |
| MiMo V2.6 Flash | mimo-v2.6-flash |
1,000,000 | 128,000 | 支持 |
| MiMo V2.6 Pro | mimo-v2.6-pro |
1,000,000 | 128,000 | 支持 |
| MiniMax M3.1 Flash | minimax-m3.1-flash |
1,000,000 | 524,288 | 支持 |
| Hunyuan H4 Preview | hy4-preview |
1,000,000 | 64,000 | — |
说明:
deepseek-v4-flash与deepseek-v4-flash-vision-exp是已退役的 ID,官方文档说明两者都由 DeepSeek-V4.1-Flash 承接,因此参数与图片能力都沿用 V4.1-Flash。deepseek-v4-pro是另一个模型,官方价格表对它的「图像理解」标的是不支持。deepseek-v4.1-flash-eco是 OpenDesign 侧的慢速档,同一个模型的低速线路,DeepSeek 厂商文档里没有这个 ID。参数沿用 V4.1-Flash(窗口与输出上限均为实测确认),思考等级少一档ultra:它保留max却拒绝ultra,五轮实测每次都返回 400。它按同一个价格计费(输入 0.3 / 输出 1.2 / 缓存读 0.006 USD per 1M token),但在订阅额度里按 0.27× 扣减,而 V4.1-Flash 是 0.5×——「便宜」体现在额度倍率上,不在单价上。官方建议用于批处理。minimax-m3.1-flash的思考等级集合两端都被砍掉:它不接受none(厂商文档说这个 ID「requires adaptive thinking」,实测三发三中 400),也不接受ultra,可选的是minimal到max。它的 524,288 输出上限没有厂商数字,由实测定界——524,288 返 200,524,289 被拒。网关另外声明了video输入,但宿主的模态类型只支持text与image,这一项在插件里没有对应位置。- 覆盖值的允许范围:上下文窗口 1,000–10,000,000,输出上限 1–1,000,000。越界会被拒绝并提示,不会静默截断。
- 请求没有显式给出
maxTokens时,插件用上表的输出上限作为max_tokens,再按本次请求的实际输入钳制——网关要求输入 + max_tokens ≤ 窗口,不钳制就会在长对话里被拒。 - 设置页的模型行会同时显示「可用输入」,即
窗口 − max(输出上限, 窗口/4)。改max_tokens时能立刻看到自己拿多少输入去换了多少输出。 - 思考等级按模型给出,取自网关对每个模型实际接受的集合,见 docs/models.md。八个可选值不等于八种强度:按 DeepSeek 官方映射表,
minimal/low、medium/high/xhigh、max/ultra各折叠到同一档,网关上实测的reasoning_tokens也正好分成这三组。插件保留全部八个合法值,是因为缩表会让默认档medium被钳到low,静默降低默认思考强度。 - 插件只发
reasoning_effort,不发厂商文档里的thinking字段。原因是实测:这个网关忽略thinking(发了也不生效、不报错),而reasoning_effort: none确实关闭思考——两个 DeepSeek ID 各四轮,none的reasoning_tokens全为 0,thinking: disabled的四轮全都还在思考。 - 「图片输入」一列取自
src/model-params.ts的MODEL_DEFAULTS,厂商文档是首选依据,出处逐条列在 docs/models.md;唯一例外是deepseek-v4.1-flash-eco,厂商没有这个 ID,该行依据实测(纯色图与双色图识别全部正确)。会话选择器、参数解析和请求门控都读这张表,因此列表里显示的图片能力与实际能否发送图片一致。文本模型收到图片时会得到占位文本,不会把图片字节发给网关。
更多细节见 docs/models.md。
套餐结构说明
Go 档月费 $10。官方额度页给它的两个滚动窗口标了美元价,插件实际读到的是 credit 上限:
| 窗口 | 额度上限(vela 读数) |
官方页标价 |
|---|---|---|
| 5 小时 | 50,000 credits | $18 |
| 7 天 | 150,000 credits | $55 |
(插件按 10,000 credits = $1 折算美元。这个率是实测值:billing summary 在 2026-10-19 直接报过 10000,拿 DeepSeek 调用的 credit 增量除以公开价成本五次采样得到 10,067–11,880。页面的 $18 / $55 与它差约 3.7 倍,但两套数字的比例一致(50,000:150,000 = 1:3,$18:$55 ≈ 1:3.06),说明页面用的是另一种计价口径。)
所以「月总额度 $220」是宣传口径,真正的硬约束是 5 小时与 7 天两个窗口。设置页把窗口读数按 10,000 折算成美元显示,分母用官方的 $220,因此那个百分比会偏低约 3.7 倍——百分比可以低估,窗口读数本身是准的。
插件不预测月消耗,只回答能操作的问题:「照当前速度,这个窗口会不会在重置前用完?」窗口是硬上限,一个月最多就是四个周窗口之和,外推到超过它的数字只会读成不存在的余量。详细推导见 docs/quota.md。
文档
License
MIT,见 LICENSE。Copyright (c) 2026 EliteOtaku。

No comments yet. Be the first to write one.