拾页 · DSH Knowledge Library
本地优先的 DeepSeek Harness 资料库插件。把网页、文字、文件和视频字幕保存到自己的电脑,按分类与专题整理,再让 Agent 检索、引用并形成知识笔记。
npm · 下载 v0.1.1 · 更新记录 · 反馈问题 · MIT
这是社区插件,与 DeepSeek 官方没有隶属关系。插件已声明 dsh 原生加载配置,通过 dsh plugin add 安装后自动加载,无需另行注册账号或申请插件 ID。插件通过 npm 和 GitHub Release 分发;发布到 npm 不代表已收录进官方或第三方插件目录。
兼容基线:DeepSeek Harness 0.2.1-rc.2、Cordis 4.0.5、Node.js 22.23.0。
使用 Node 内置 SQLite,最低要求 Node 22.13.0。DSH 仍处于预览阶段,其他版本需要重新验证。原生界面已针对 本机 DSH Web 验证;桌面发行版、远程部署尚未验证,不能直接视为兼容。
已实现
- dsh 原生侧栏「资料库」,跟随宿主深浅主题、字体与按钮样式,支持窄窗口阅读。
- 网页正文提取、原始 HTML 保存、来源地址与作者记录。
- 文本 / Markdown 收集;UTF-8 文本、HTML、SRT、VTT 文件导入。
- 视频、音频、PDF 等文件原样归档,并明确标记「仅归档」。
- 分类对应本地目录;标签与专题用于跨分类组织。
- 中文全文与短词搜索、类型筛选、资料去重。
- 稳定资料 ID、段落引用、字幕时间戳、带来源的知识笔记;点击引用定位原段落。
- GitHub 当前源码支持逐篇分析、零散资料智能分组、确认后本地归类与按组生成独立知识草稿;复用 Harness 默认模型(尚未发布到 npm)。
- 导出单份 Markdown,下载原始附件。
- 网页采集任务持久化,失败可重试,重启后恢复中断任务。
- GitHub 当前源码支持列表与详情删除资料、回收站查看与恢复(尚未发布到 npm)。
- 从原始资料目录重建 SQLite 索引;校验正文和段落文件,避免外部修改静默改变引用。
- 8 个原生 Agent 工具,直接使用 dsh 的模型与对话;GitHub 当前源码另有 2 个知识整理工具。
采集、本地归档与检索不调用模型,也不监听剪贴板。主动发起知识整理,或让 Agent 读取资料时,相应正文会进入所配置模型的上下文;如果模型在云端,相应内容会发送到模型服务商。
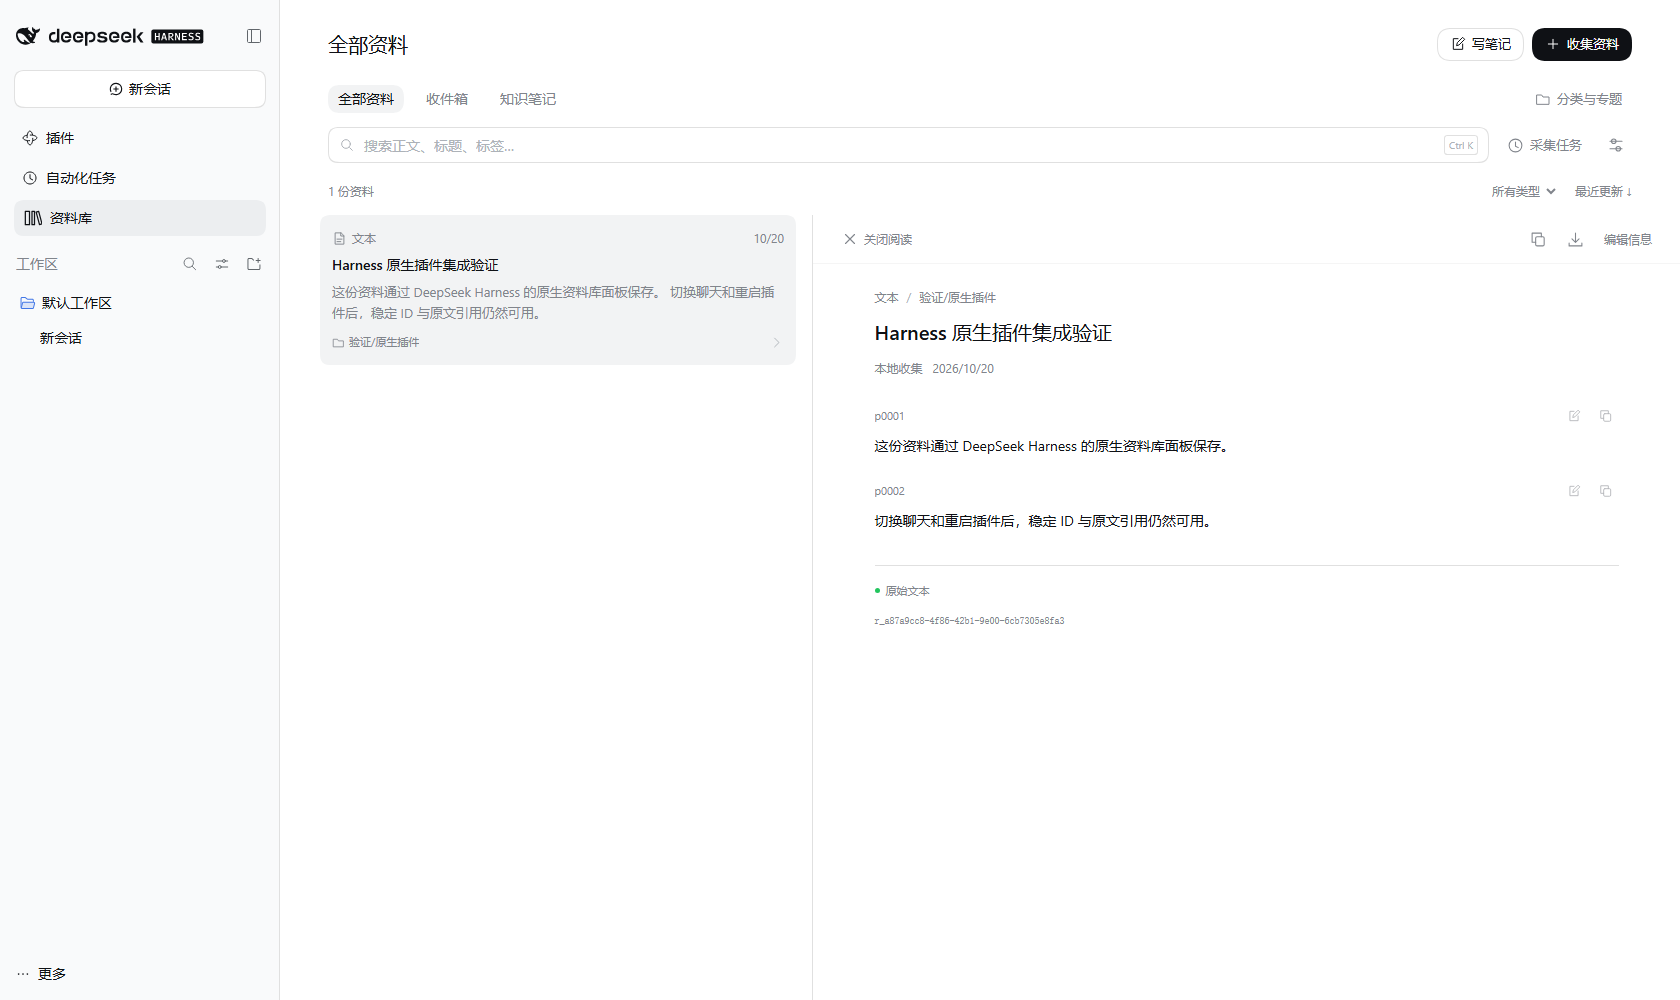
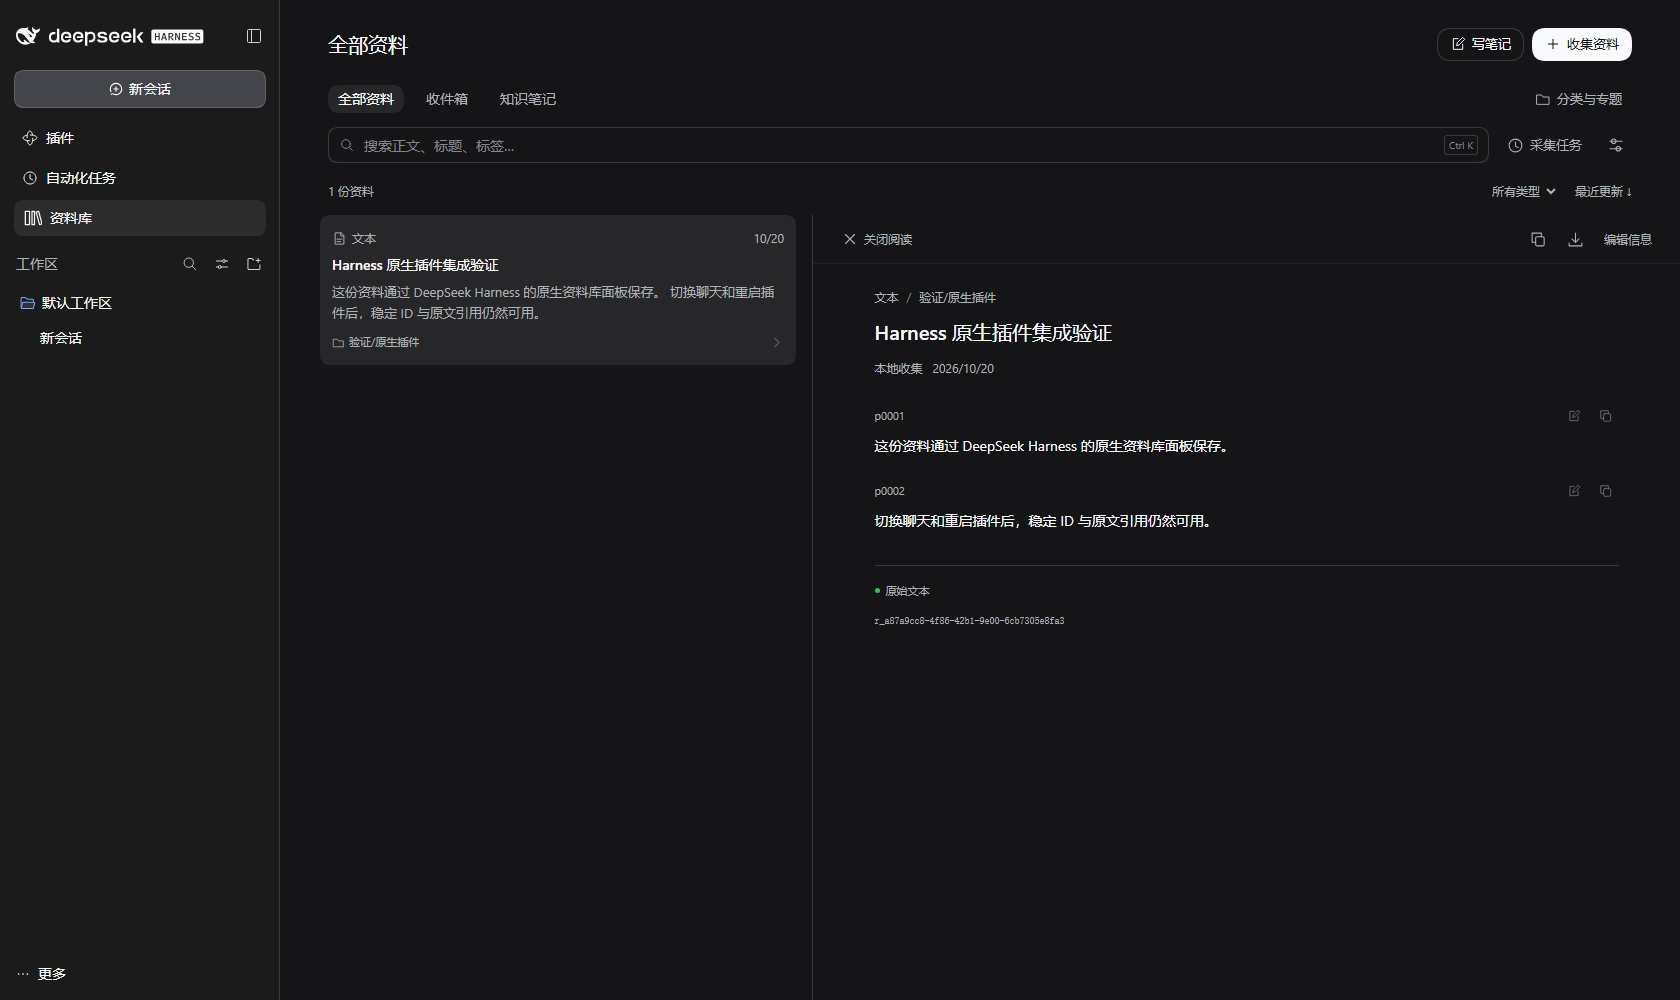
截图来自隔离的 DSH Web 测试实例,使用测试资料。
安装到 dsh
先安装 DeepSeek Harness,确保终端可以运行 dsh。在 PowerShell 或其他终端执行下面这条命令,从 npm 下载并安装已经构建好的插件,不需要克隆源码、安装 GitHub CLI 或注册 npm 账号:
dsh plugin --profile web add dsh-knowledge-library@0.1.1 --registry=https://registry.npmjs.org/
重启 DSH Web,再在浏览器中按 Ctrl+Shift+R 刷新,点击侧栏 资料库。界面与 Agent 工具共享同一份本地资料。示例安装到 web profile;如果你实际使用其他 profile,请先确认宿主版本与界面兼容性后替换。已验证的宿主为 0.2.1-rc.2。
也可以安装 GitHub Release 中的同一版本:
dsh plugin --profile web add "https://github.com/Alan-dong-dong/dsh-knowledge-library/releases/download/v0.1.1/dsh-knowledge-library-0.1.1.tgz" --registry=https://registry.npmjs.org/
如果终端无法直接下载 GitHub 地址,可以从 Releases 下载 .tgz 与 SHA256SUMS,然后安装本地包:
# 将输出与 SHA256SUMS 中的值比较。
Get-FileHash 'D:/下载/dsh-knowledge-library-0.1.1.tgz' -Algorithm SHA256
dsh plugin --profile web add "D:/完整路径/dsh-knowledge-library-0.1.1.tgz"
安装过程中仍需从 npm 下载运行依赖。插件包含 dsh.bundle.patch 配置和符合 dsh lazy-CJS 协议的客户端入口。更新时将安装命令中的版本号替换为新版本,或安装新 Release 的版本化 .tgz 地址,再重启宿主。卸载可执行 dsh plugin --profile web remove dsh-knowledge-library;已保存的资料保留在独立资料目录。
如果安装后没有入口,先确认安装的 profile 与启动的 profile 相同,重启并刷新,再用 dsh --profile web --dump-config 检查是否存在启用的 knowledge-library。网页采集遇到代理 fake-IP 提示时,参见下方配置。
从源码安装
适合开发或需要自己构建的用户:
git clone https://github.com/Alan-dong-dong/dsh-knowledge-library.git
cd dsh-knowledge-library
npm ci
npm run build
$pluginPath = (Get-Location).Path.Replace('\', '/')
npx --no-install dsh plugin --profile web add "link:$pluginPath"
npx --no-install dsh web
独立预览
不需要模型密钥,也可以单独打开资料库:
npm run build
npm start
访问 http://127.0.0.1:4317。这只是同一个插件界面的本地预览,不是另一个资料系统。
自定义目录与端口:
$env:KNOWLEDGE_LIBRARY_ROOT = 'D:/KnowledgeLibrary'
$env:PORT = '4317'
npm start
同一个资料库只能由一个写入实例打开。使用 dsh 插件前,请关闭使用同一目录的独立预览。
dsh 配置
默认资料目录为当前用户主目录下的 Documents/DSH-Knowledge-Library,不是插件安装目录或聊天工作区。
在 dsh 的配置中修改 knowledge-library 项,或者创建一个覆盖文件:
GitHub 当前源码还提供界面入口:打开资料库右上角的 设置 → 选择目录,选择目标文件夹后点击 切换资料库。Harness 使用系统选择窗口或网页内目录浏览器,也可以直接填写完整绝对路径。选择过程可以取消;只有确认切换后才保存插件配置,重启后仍使用新目录。此功能尚未发布到 npm,npm 0.1.1 仍需通过下方配置修改目录。
切换目录会读取目标资料库并将后续内容保存到那里;旧资料保留在原目录,不会自动搬迁。需要迁移时先关闭 Harness,复制整个资料库(包含 .system)到新目录后再切换。目标目录被占用、无法写入或插件重载失败时,会显示错误。新旧资料库应位于互不包含的独立目录。使用命令行 --patch 或主目录覆盖文件固定 root 时,需要先调整该覆盖配置,才能从界面保存新目录。独立预览通过启动环境变量指定目录。
手动配置示例:
- id: knowledge-library
  config:
    root: D:/KnowledgeLibrary
    allowProxyFakeIp: false
通过以下命令加载:
dsh --profile web --patch ./library.patch.yml
root 必须是绝对路径。卸载插件、删除聊天都不会删除这个资料目录。
本机代理的 fake-IP DNS
若网页采集提示检测到 198.18.*,且你确认本机正在使用 Clash/Mihomo 的 TUN fake-IP 模式,可以把 allowProxyFakeIp 设为 true。
GitHub 当前源码提供 资料库设置 → 网页采集 → Clash/Mihomo 代理兼容(fake-IP):勾选后点击 保存采集设置,保存成功后重新采集失败任务。任务遇到 fake-IP 错误时,也可以直接点击 代理兼容设置进入;保存后会返回任务列表。仅勾选而不保存不会改变配置。此界面入口尚未发布到 npm;npm 0.1.1 可在 Harness 插件配置中手动修改 allowProxyFakeIp,保留其他字段并重新加载插件。
GitHub 当前源码的独立预览也可直接勾选并保存,保存后对后续采集生效,无需重启。设置保存在当前资料库的 .system/preview-settings.json,重启后继续生效;Harness 使用自身 profile 的插件配置。
尚未保存预览设置时,可以用环境变量指定初始值:
$env:KNOWLEDGE_LIBRARY_ALLOW_FAKE_IP = '1'
npm start
通过界面保存后,以保存的预览设置为准,包括手动关闭兼容模式。
此开关默认关闭,只放行域名解析结果中的 198.18.0.0/15。它不允许直接访问此范围的 IP URL,也不放开 127.*、10.*、192.168.* 等其他本机和内网地址。该模式依赖你对本机代理 DNS 的信任。本机公网采集验证在显式启用此开关后通过。
兼容模式解决 fake-IP DNS 的访问限制,不保证站点本身可访问。GitHub 当前源码使用带插件身份的 Mozilla 兼容请求标识,并针对微信文章的隐藏正文容器提取内容、标题、作者与懒加载图片地址,避免只保存作者和页面按钮;微信逐行代码块合并后保留完整代码、缩进和语言,无需执行网页脚本。这些适配尚未发布到 npm。图片保留远程引用,不自动下载图片文件。
微信公众号链接仍可能因网络环境或站点策略连接超时、要求浏览器验证;重试仍失败时,可以复制正文保存为文本,或导入本地 HTML。
GitHub 当前源码对连接重置(包括 TLS 握手前断开)、临时 DNS 故障等网络错误最多自动重试 2 次,短暂退避后建立新连接;DNS、跳转和重试共享 25 秒上限,取消采集时停止等待。持续失败会显示中文网络提示。每次重试仍检查所有 DNS 结果与跳转地址;证书、HTTP 状态错误和网页验证不自动重试,也不会关闭 TLS 证书校验。此恢复处理尚未发布到 npm。
网页返回验证页面
GitHub 当前源码会识别明确的微信“环境异常”和常见 Cloudflare 验证页结构。识别到时,任务显示 需浏览器验证,不会把验证提示当作文章正文保存;保存下来的验证页 HTML 也会被拒绝。相关修复尚未发布到 npm。
在采集任务中点击 打开原网页,自行在浏览器中完成验证,再点击 粘贴正文,粘贴实际文章内容保存。文本摘录会预填 来源网页,可以核对或修改;也可以导入浏览器保存的实际文章 HTML。后台采集不共享浏览器登录或验证状态,浏览器验证完成后直接重试后台请求仍可能被拦截。
识别依据是站点路径、页面结构和提示的组合,普通文章中提到“验证”或“环境异常”仍可正常采集。此前已误存的记录会保留,需要重新收集实际正文。
删除与恢复资料
GitHub 当前源码可以在收件箱或其他资料列表点击每份资料右侧的 删除 图标,也可以打开资料后点击工具栏的 删除资料。核对标题后确认 移入回收站;取消不会改变资料。
删除后,资料从收件箱、普通搜索和统计中移除;顶部 回收站 可以查看并恢复到原分类。普通删除保留本地原文件和正文,不释放磁盘空间,也不会自动过期;已有笔记仍能通过引用查看来源。删除状态随资料保存,重启或重建索引后仍保留。重新采集完全相同的资料会恢复原记录,保留资料 ID 和引用。这些功能尚未发布到 npm。
在 回收站 → 清空回收站 核对总数量,再点击 永久清空,会永久删除整个回收站的正文、原始附件和索引,无法恢复;当前搜索或类型筛选不会缩小清空范围。确认期间内容变化需要重新确认。相关笔记正文保留,失效引用标记为“来源已永久删除”,笔记仍可导出。遇到部分文件占用等失败会报告结果和待清理数量,可再次清空重试;重启也会继续处理此前已明确确认的文件清理。未删除的资料不受影响。
将资料整理为知识笔记
GitHub 当前源码已接通 资料 → 逐篇分析 → 智能分组 → 确认归类 → 各组知识草稿 → 知识笔记,这些功能尚未发布到 npm。升级源码后需要重新构建并重启插件或独立预览服务;仅刷新网页不会升级正在运行的后端。
- 在列表点击 智能整理,勾选最多 10 份资料,再点 智能分析分组。这些资料可以主题零散,整理方向可以留空。
- 核对模型后点 开始分析分组。模型逐篇提取主题、概念、概要、用途和建议分类标签,再按实际关联分组。无关联的资料独立成组,信息不足的资料保留待整理;不会为了固定组数合并资料。已有分类会作为参考,也可建议新目录。
- 在 确认智能分组 中查看理由和逐篇分析。可以修改组名、理由、分类和标签,调整每份资料的所属分组,选择 单独成组 或 保留待整理,也可以新增或删除分组。删除分组会把其资料留待整理,保存时忽略空分组。保存分组方案 只保存建议,不移动来源目录。
- 核对 同步来源分类和标签到本地目录。开启时,确认后将已分组资料移动到对应分类目录,保留原标签并添加分组标签(总数最多30个);关闭时,只按组生成草稿。未分组资料不移动。点击 确认归类并生成 N 份草稿(关闭同步时为“确认分组”)后,每组形成一个独立任务;全部留待整理时不会创建草稿任务。
- 在父任务中打开各组草稿,逐份核对核心观点、关键概念、可复用方法、适用条件与局限、待验证问题和来源引用。每组还会检索相关已有知识笔记,给出新建、追加补充或重复内容仅关联来源的建议,等待单独确认。新建笔记只引用本组来源;补充笔记保留旧来源并添加本组来源。
持续补充已有知识
单篇直接整理和智能分组的子任务都会先形成独立草稿,再通过本地词面检索选择最多5份相关有效笔记,让同一模型完整比较正文。对比页面展示匹配理由、重复内容、新增知识和差异/待核实点;分类相同本身不作为合并依据。
- 建议补充已有笔记:核对目标标题、分类、版本和原文,编辑 本次新增正文 并查看 更新后正文预览。点击 确认补充已有笔记 后,将新增内容追加到原笔记,保留其ID、标题、分类、原文及旧段落ID,合并新来源与标签。不同观点并列记录并说明条件,不改写旧结论。
- 建议仅关联已有笔记:本次内容已覆盖时,点击 确认仅关联来源,只增加来源和标签,不重复追加正文。
- 另存为新笔记:对建议不满意,或想独立保存,可以切换后编辑原始独立草稿,点击 确认保存笔记。没有合适候选时默认新建。
保存草稿、查看旧笔记和关闭窗口都不会修改正式笔记;查看前先保存审核进度。最终确认才提交更新。旧笔记被删除、分类/标签/正文等在审核期间变化时,拒绝覆盖,可以另存为新笔记,或重新整理取得最新对比。多个草稿指向同一笔记时,前一份更新后,其他草稿也需要重新核对。
追加和来源关联会递增笔记版本,更新前后快照保存在该笔记目录的 .history/,随笔记分类移动、备份或永久清空。.system/note-update.json 是单次更新的写前日志:未提交的中断更新恢复原状,已提交的中断更新完成写入;再次确认不会重复追加。当前没有历史版本回退按钮。原始资料仍保持不可变,不会用模型改写原文。
检索不含回收站,不使用向量索引;完整对比候选正文合计最多6万字,单篇超过5万字会跳过并在界面显示数量,候选正文不会截断。界面展示有效笔记总数、词面命中数和实际对比数;没有匹配不等于整库没有相关知识。同一批分组草稿独立处理,尚未确认的新草稿不作为已有笔记候选。
如果已确定多篇资料围绕同一问题,可以在开始窗口选择 同主题直接综合,跳过分组阶段;单篇资料详情中的 生成知识笔记 默认采用此方式,也可以改为智能分组以获取分类建议。正式笔记保存在 知识笔记 中,原始资料详情提供关联笔记入口。查看来源前会先保存当前草稿或方案;其他修改请保存后再关闭窗口。
顶部 知识整理 可以查看智能父任务和各组子任务、取消处理中任务、舍弃方案/草稿或主动重试失败任务。列表和详情显示 待整理 / 整理中 / 待分组确认 / 待确认 / 已整理 / 整理失败。任务、分析、方案、归类进度与草稿持久保存在 .system/knowledge-jobs.json;服务重启后仍保留。被中断的模型任务等待主动重试,不自行重复付费调用。已生成的关联笔记移入回收站后,来源重新显示待整理;恢复笔记后关联状态恢复。
归类因文件占用等原因只完成一部分时,会如实显示已完成数量,保留原文并锁定方案。可在问题解决后 继续归类并生成草稿,或 回退已更改的分类 后重新编辑、舍弃方案;回退同样可在中断后继续。重启后不会擅自移动文件或重新调用模型。归类完成、各组任务建立后,方案成员固定;后续需要重新分组时,先处理现有草稿再发起新任务。来源分类/标签被其他操作修改时,同步归类会拒绝覆盖;可重新分析,或关闭同步仅生成各组草稿。
模型配置: 在 Harness 中复用其已配置的默认模型及凭据,插件不保存第二份密钥。点击开始后会向该模型发送所选正文;生成草稿时也会发送检索到的相关已有笔记用于增量对比。独立预览使用启动进程的以下环境变量,密钥不会写入资料文件或返回前端:
| 环境变量 | 用途 |
|---|---|
KNOWLEDGE_LIBRARY_MODEL_API_KEY |
兼容 Chat Completions 接口的密钥;未设置时读取 DEEPSEEK_API_KEY |
KNOWLEDGE_LIBRARY_MODEL_BASE_URL |
服务基础地址,默认 https://api.deepseek.com;其他兼容服务可填写其 /v1 基础地址 |
KNOWLEDGE_LIBRARY_MODEL |
模型名称,默认 deepseek-chat |
在自己的 PowerShell 中设置好环境变量后执行 npm start,并保持窗口运行。无可用模型时,界面会显示配置提示并禁用开始按钮;不会生成虚假的摘要。请勿将真实密钥提交到 Git。
单次正文总量最多 10 万字,长文会完整分段提炼,不会悄悄截掉末尾;每次模型请求最多等待 120 秒。直接综合含已有笔记对比最多22次请求;智能分析/分组阶段最多40次,确认后各组继续生成草稿,整个智能任务合计最多80次请求,每组含对比最多22次。达到上限会停止并说明原因,可能产生相应调用费用。仅归档的音视频、PDF 等文件需要先提供正文或字幕。模型响应不完整、分区重复/遗漏、引用不存在、来源删除或正文变化时会拒绝处理。模型可建议分类标签,移动目录必须在界面确认后执行;采集后不会自行调用模型。
对 Agent 说什么
把这段文字保存到“技术/AI”,添加“待读”标签,归入“个人知识库”专题。
搜索资料库中有关混合检索的内容,读取相关段落,整理成一份带来源引用的笔记。
找出收件箱里有关 Harness 的资料,调用 library_knowledge_generate,围绕“提高 Agent 可靠性”生成知识草稿,等我在资料库里确认保存。用 library_knowledge_status 查看进度,不直接发布。
从收件箱选择最多10份零散资料,调用 library_knowledge_generate,mode 使用 smart,先逐篇分析和智能分组。等我在资料库确认分类和分组后,再按组生成独立草稿。
导入 D:/资料/课程字幕.vtt,保留时间戳,归入“课程学习”专题。
| 工具 | 用途 |
|---|---|
library_capture |
保存文本,或创建网页采集任务 |
library_import_file |
复制用户指定的本地文件,最多 64 MB |
library_search |
按关键词、分类、标签、专题、类型检索 |
library_read |
分段读取正文与字幕,返回引用位置 |
library_update_metadata |
修改标题、分类、标签、专题与备注 |
library_save_note |
保存笔记,并验证引用资料与段落存在 |
library_jobs |
查看网页任务,重试失败任务 |
library_overview |
查看资料库统计与索引警告 |
library_knowledge_generate |
GitHub 源码:多篇默认 smart 先分组;单篇默认 compose 直接综合,也可显式选择 |
library_knowledge_status |
GitHub 源码:查看整理进度、失败原因和草稿 |
工具返回结构化 JSON,避免把整库内容一次性送入上下文。library_read 默认返回 12 个段落,最多 30 个;资料内容均被描述为待分析的不可信输入。引用格式:
library://r_资料UUID/p0002
笔记引用验证的是来源存在与定位有效性,不自动证明笔记中的结论正确。
本地文件结构
DSH-Knowledge-Library/
├─ materials/
│  └─ 技术/AI/
│     └─ r_资料UUID/
│        ├─ metadata.json      分类、标签、来源、引用、校验值
│        ├─ content.md         提取后的正文
│        ├─ segments.json      稳定段落及字幕时间戳
│        └─ original.html      原始文件(如有)
└─ .system/
   ├─ index.sqlite            可重建索引
   ├─ jobs.json               持久化网页任务
   └─ writer.lock             单写入实例锁
原始资料创建后正文保持不可变,修改理解时创建笔记;需要修订原文时重新导入。知识笔记可通过上述增量整理确认后追加,旧正文与段落引用保留。标题、分类、标签和专题可以在界面中修改。手动改写 content.md 或 segments.json 会在重建索引时报告校验异常,避免引用指向已被改写的证据。
备份时先关闭插件或预览,再复制整个资料目录。不要只复制 SQLite 文件。索引丢失可以重建;任务历史保存在 jobs.json。启动时会忽略未提交的 .pending-* 目录并报告无法解析的资料。
当前边界
- 网络视频平台自动下载、音视频自动转写、关键帧分析、PDF 文本提取和 OCR 未接入。可以先导入原文件与外部生成的字幕。
- 网页采集适用于直接可访问的文章;登录页、反爬或复杂动态页面请复制文本,或导入保存的 HTML。
- 网页正文和原始 HTML 会保存;图片保留远程引用,不下载资源,不保证原网页完整离线还原。
- 网页最多 6 MB,文本最多 200 万字符,单个文件最多 64 MB。
- 搜索以本地全文和字面匹配为主,当前不含向量索引。智能分组与分类建议由模型完成,需要主动发起,分类移动与正式笔记保存分别确认;采集后不会自行调用模型。
- 前端安全显示文本和标题,不执行资料 HTML。Markdown 的复杂表格、公式等尚无专用排版。
- 当前专题为单值字段,标签可多值;尚无批量专题压缩包导出、同步和多人协作。
- 后台网页任务随宿主停止;下次启动可重试恢复,不会在退出 dsh 后常驻运行。
- HTTP 界面仅接受本机连接、精确 Host 与同源写入;远程 Web、代理前缀部署与桌面 IPC 需要单独适配。
- 删除、回收站和模型知识整理目前仅在 GitHub 源码可用,尚未包含在 npm
0.1.1中。
开发与验证
npm ci
npm run build
npm test
npm run pack:check

# 浏览器测试使用 Python Playwright。
python -m pip install -r requirements-test.txt
python -m playwright install chromium
npm run test:ui
npm run test:knowledge:ui
npm run test:dsh:knowledge
npm test 覆盖内容持久化、索引重建、中文检索、去重、分类移动、引用、字幕、文件归档、原生 Cordis 工具注册与卸载,以及 HTTP 接口边界。
知识整理测试另覆盖长文尾部处理、多来源引用、持久草稿、确认幂等、来源变化/删除、取消竞态、模型失败/变化、旧版服务与 HTTP 权限边界。智能分组测试覆盖准确分区、不确定资料待整理、方案编辑、归类前只读、索引失败回退、部分归类继续/撤销、目录移动中断恢复及路径边界。增量整理测试覆盖匹配/追加/重复关联/另存新建、旧段落稳定、并发变更、目标及引用校验、索引失败回滚和提交前后中断恢复。test:knowledge:ui 使用隔离预览和本地兼容 HTTP 模型;test:dsh:knowledge 使用隔离 Harness profile、实际 LlmRuntime 与测试提供商完成单篇、直接综合、零散资料智能分组及增量整理流程,并完整重启检查方案、笔记和审核草稿。两个命令都不调用外部付费模型,截图和结果位于 test-results/knowledge-*、test-results/grouping-*、test-results/incremental-*。
npm run test:ui 启动临时资料库和无头浏览器,验证采集、搜索、笔记引用跳转、信息编辑、重新加载、字幕上传、类型筛选、文本渲染和移动端布局,并完整停止和重启独立预览验证代理开关持久化。数据与服务日志位于 .test-runtime/,截图与结果位于 test-results/,不会修改默认资料库。
tests/dsh_smoke.py 用于已经启动的隔离 dsh 实例,从 DSH_TEST_URL 读取带本机启动令牌的地址,验证原生侧栏与真实插件界面。不要把启动令牌提交到仓库。
运行上述原生检查后,可以在同一隔离实例中执行 python tests/dsh_style.py。该检查要求宿主外观保持默认的“跟随系统”,会对比资料库与原生自动化任务页面的字体和按钮颜色,并验证深浅主题切换、弹窗、分类导航以及窄窗口布局。截图与报告保存在 test-results/style-*。
npm run test:dsh:directory 会创建独立的 DSH profile 与资料目录,验证宿主目录浏览、取消选择、目标目录错误、插件加载失败回滚、切换后保留原资料,以及完整重启后的目录和资料持久化。测试使用网页内浏览方式,不会弹出系统选择窗口,也不会更改个人 Harness 配置;报告和截图位于 test-results/directory-*。
该命令还执行 tests/dsh_proxy.py,验证代理兼容开关的手动保存、关闭、失败保留旧值、采集错误入口、返回重试与重启持久化,以及验证页失败后的原网页入口和保留来源的正文粘贴。任务展示使用固定测试数据,配置保存与正文保存调用真实 Harness 接口;报告和截图位于 test-results/proxy-* 和 test-results/verification-*。
源码分层:
src/core/:存储、检索、网页提取、字幕和任务队列。src/tools.ts:dsh Agent 工具。src/index.ts:Cordis 宿主插件及生命周期。src/http.ts:本机界面接口。src/client.tsx:dsh 原生侧栏与主面板注册。src/ui/:中文资料库界面。src/standalone.ts:同一界面的独立预览。
未调用付费模型或使用真实模型凭据测试模型推理。已验证工具能被实际 dsh/Cordis 运行时注册与执行;具体模型如何选择工具,取决于你的模型与 dsh 配置。
维护与发布
npm run verify 执行构建、行为测试与安装包检查。产物位于 release/:版本化 .tgz、SHA256SUMS 和包文件清单。发布包只包含构建文件、插件配置与说明,不包含本地资料、测试实例或开发依赖。
仓库的 automation/workflows/ 提供 Windows / Linux 持续集成和版本发布的 GitHub Actions 模板,当前尚未启用。维护者如需自动化,可将模板复制到 .github/workflows/,再使用具有 workflow 写入权限的凭据推送。发布模板要求标签与 package.json 版本一致,验证后会上传安装包与 SHA-256 校验文件。
发布前运行本机 npm run verify,检查隔离安装与原生界面,再将同一个版本化安装包发布到 npm 和 GitHub Release。上传 Release 时只选择本次版本的 .tgz 与对应 SHA256SUMS。
npm 发布需要维护权限与有效认证。更新 GitHub 源码不会自动更新 npm;必须递增版本号并发布新包,用户再按新版本安装并重启宿主。
No comments yet. Be the first to write one.